先说结论:能跑,但有三个前提
先说结论:Edge0-145B 是真开源、真能在一张卡上跑,但「塞进笔记本」这句话,你得划掉一半再信。
我的第一个判断:真正干活的是笔记本里那块 NVIDIA 独显,不是笔记本本身。官方文档写得很直白,要么 Linux 要么 Windows,加 NVIDIA GPU 加 CUDA 13,普通轻薄本连门槛都没摸到。
第二个判断:Q3_K 是
激进量化。官方自己写了,质量分是模型级的,没把 Q3_K 和 NVFP4 分开评。体积省下来,精度差多少,没人给你打包票。
第三个判断:本地跑省的是 API 的 token 钱,掏的是电费、下载时间和等待。就冲「偶尔用一次」这几个字,先别折腾。
笔记本三个字有水分
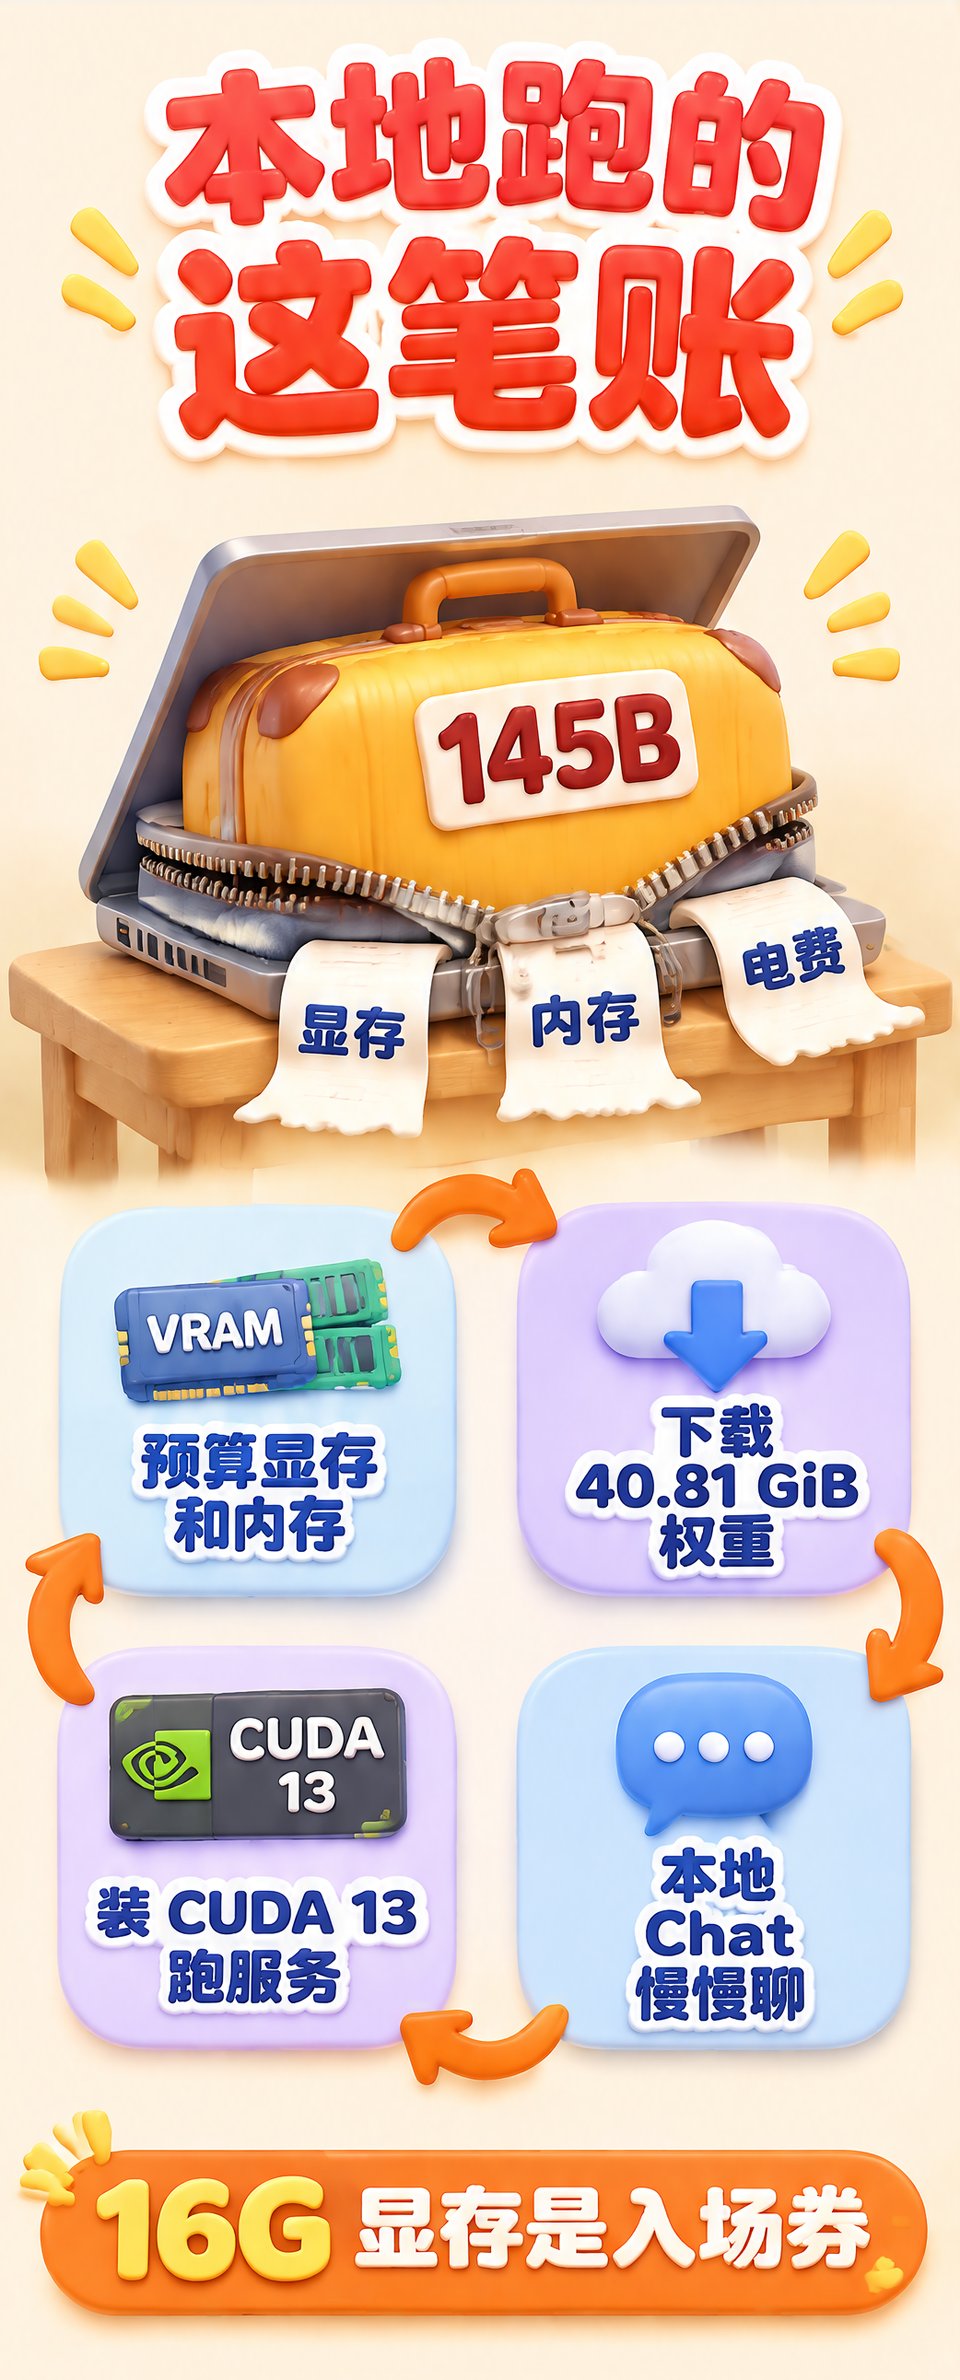
官方发布说明写得清楚:需要 NVIDIA 显卡,算力 7.5 及以上,也就是 RTX 20 系之后的卡;显存至少 16GB,系统内存 20GB 起,还得装 CUDA Toolkit 13。
注意,16GB 是「跑得动」的底线,不是「跑得舒服」的线。官方用 16GB 显存加 20GB 内存的受限环境测过,每秒约 36.8 个 token。什么概念?聊天能聊,但对方每说一句话,你要端着咖啡多等两拍。
24GB 的 RTX 4090、RTX 5090D 才是这套数字的好朋友。至于 8GB 显存的轻薄本用户,连下载按钮都不该碰。
苹果用户先别欢呼。M2 Ultra 跑 Metal 的成绩确实出现在官方测速表里,每秒 60.9 token,但文档末尾补了一句:这些数字不构成 macOS 发布可用性的承诺。说白了,官方还没给 Mac 松口。
40 个 G 的权重和激进量化
先掂量体积:Q3_K 版权重 40.81GiB,NVFP4 版 47.79GiB。算上下载和解压,你至少得给硬盘留出近百 GB 的地方。
145B 走的是混合专家路线,512 个专家每次只挑 10 个激活,单个 token 实际动用 10.12B 参数,基座是 Qwen3.8-Flash-Next。这是它敢喊「单卡可跑」的底气。
底气也有代价。Q3_K 是 3-bit 级别的量化,NVFP4 是 4-bit 浮点,都属于激进派。官方质量表列了一大排分数,最后一行注释写得很诚实:模型级结果,没对两种量化分别做评估。
上下文同样要打折看。标称 256K,但 KV cache 是 int8,只有 32K 常驻。想塞本长篇小说进去满血读,先问问显存和内存答不答应。
还有个内存细节:开常驻模式后,Q3_K 的 40.81GiB 权重会拆成显存 23.14GiB 加内存 31.28GiB 来放。你机器总内存不够,连加载都过不去。
官方怎么把 145B 挤进一张卡
这套模型聪明在分层流式加载。引擎叫 edge0-strata,是 Strata 的一个分支,负责调度 CPU、GPU 和 PCIe 的活。
基本思路是:卡的显存只放一部分专家,其余专家躺在主机内存里,用到哪个再临时拉过来。所以占多少显存,看的是卡上驻留的专家数,跟模型总规模不完全挂钩。
官方还带了个 1.26B 的草稿模型做投机解码,先让便宜的小模型猜,主模型再验证,能偷一点首 token 的等待时间。这层心思说明,速度是按着帧来抠的。
顺带一提,120B 版也在同一天发布,512 专家、8.64B 活跃参数,权重更小,对显存更友好。机器不够格又眼馋的,可以先看它。
速度账:先看数字再掏钱
官方测速表里最好看的一行:RTX 5090D 24GB 跑 Q3_K,聊天生成每秒 99.7 token;喂 4K 上下文的预处理,每秒能消化 2169.9 token。
RTX 4090 24GB 是每秒 69.9 token,日常也够。但这些数字都是官方在自己引擎上测的理想值,回到你的机器、你的场景,先打个七折当心理预期。
要是只有 16GB 显存,数字直接掉到 36.8 token/s。长文档总结这种活,能跑,但你大概率会中途去泡茶。
官方没给首词延迟的明确毫秒数,我也不编。我的体感判断:日常问答、改代码,这速度够用;但跟云端旗舰那种「回车就出字」的丝滑比,还差着距离。
本地跑到底图个啥
把账摊开算:省的是每次调 API 的 token 费,掏的是三样——40 个 G 的下载流量、风扇呼呼转的电费,还有每句话多等几秒的时间。
隐私敏感的内容是硬需求:病历、合同、公司代码库,不想上传云端,本地跑几乎是唯一解。断网环境、出差路上没信号,本地模型同样是刚需。
长期高频调用是另一种账。一天几百万 token 的用量,API 账单相当可观,本地跑一个月,电费可能只是零头。前提是机器真扛得住。
反过来,一个月就用三五次的人,40 个 G 占着硬盘,电费照付,效果还打折。这笔账,怎么算都不划算。
适合谁,不适合谁
适合谁:内容坚决不能出本机的,比如病历、法务卷宗、公司内网代码;断网或网络不稳定的环境;调用频率高到 API 账单开始扎眼的团队。
不适合谁:只想偶尔问几个问题、图省事的;追求每个答案都满血质量的;显卡还是 8GB 老卡的。这几类人,云端模型依然更划算。
我的建议很实在:想试,先别直奔 145B。拿 Edge0 的 35B 或者 120B 热热身,把引擎、模型文件夹、聊天界面这套流程跑顺了,再决定要不要下那 40 个 G。
下载 40 个 G 只需要一次冲动,跑不动的时候,后悔是真金白银的。
真想试,按这个来
官方给的最简流程:权重从 HuggingFace 拉,选择模型文件夹 Edge0-145B-q3k 或 Edge0-145B-NVFP4,解压放好;再跑一行命令,Linux 是 build/cpu/bin/edge0-infer serve --model /path/to/Edge0-145B-q3k,Windows 对应 build\windows\bin\edge0-infer.exe。
服务起来之后,打开 Edge0 Chat 桌面应用,选模型文件夹,就能本地开聊。不注册、不联网、不用 API key,这是「本地跑」最爽的地方。
丑话说前头:这套东西要自己编译或者下 release 包,装 CUDA 13,对着文档折腾一阵子,不是双击就完事。动手前先确认显卡和内存够格,再决定要不要把 40 个 G 拉回家。
最后把账理一遍:Edge0-145B 开源是真的,一张卡能跑也是真的。它适合的是「有 NVIDIA 独显、显存 16G 起步、不差电费、内容不想上云」的人。
条件凑齐,它是台能打的本地大模型;条件差一条,它就是 40 个 G 的下载后悔药。先对号入座,再决定动不动手。

