
一句话:这 58 倍比的是「新一代整机架对上一代整机架,每块 GPU 能吐多少 token」,不是新卡对旧卡的单独倍数。据 vLLM 官方博客,单台 Vera Rubin NVL72 跑 DeepSeek-V4.1-Flash,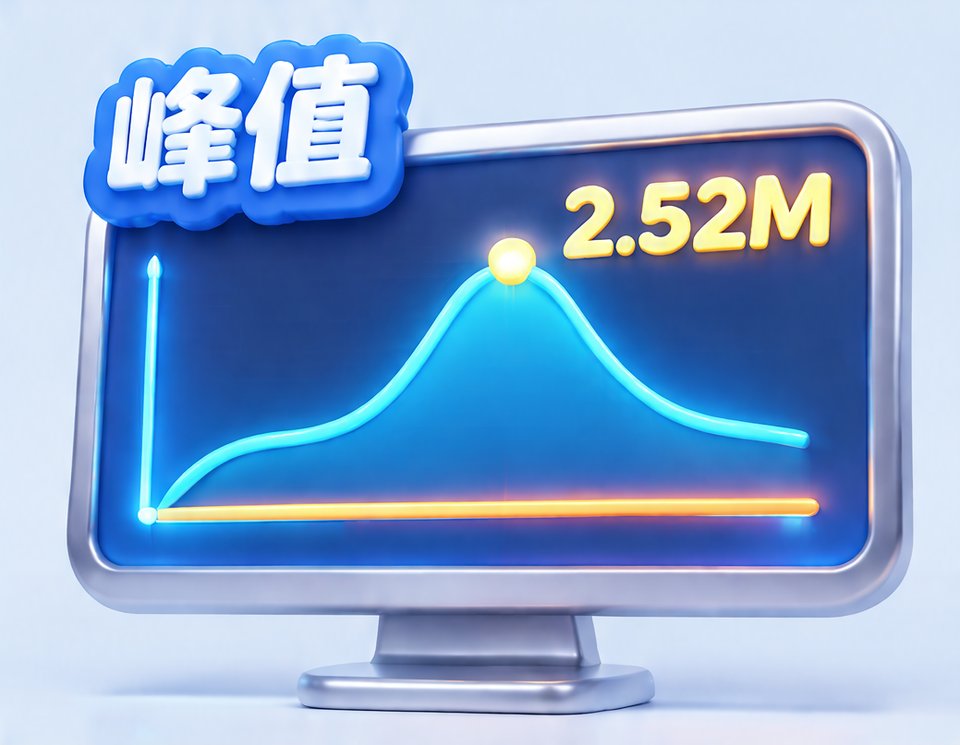
每 GPU 吞吐 1.7M tokens/s,单用户 387 tokens/s。数字很响,但响不等于能直接拿去算账。
先把比较对象钉死。
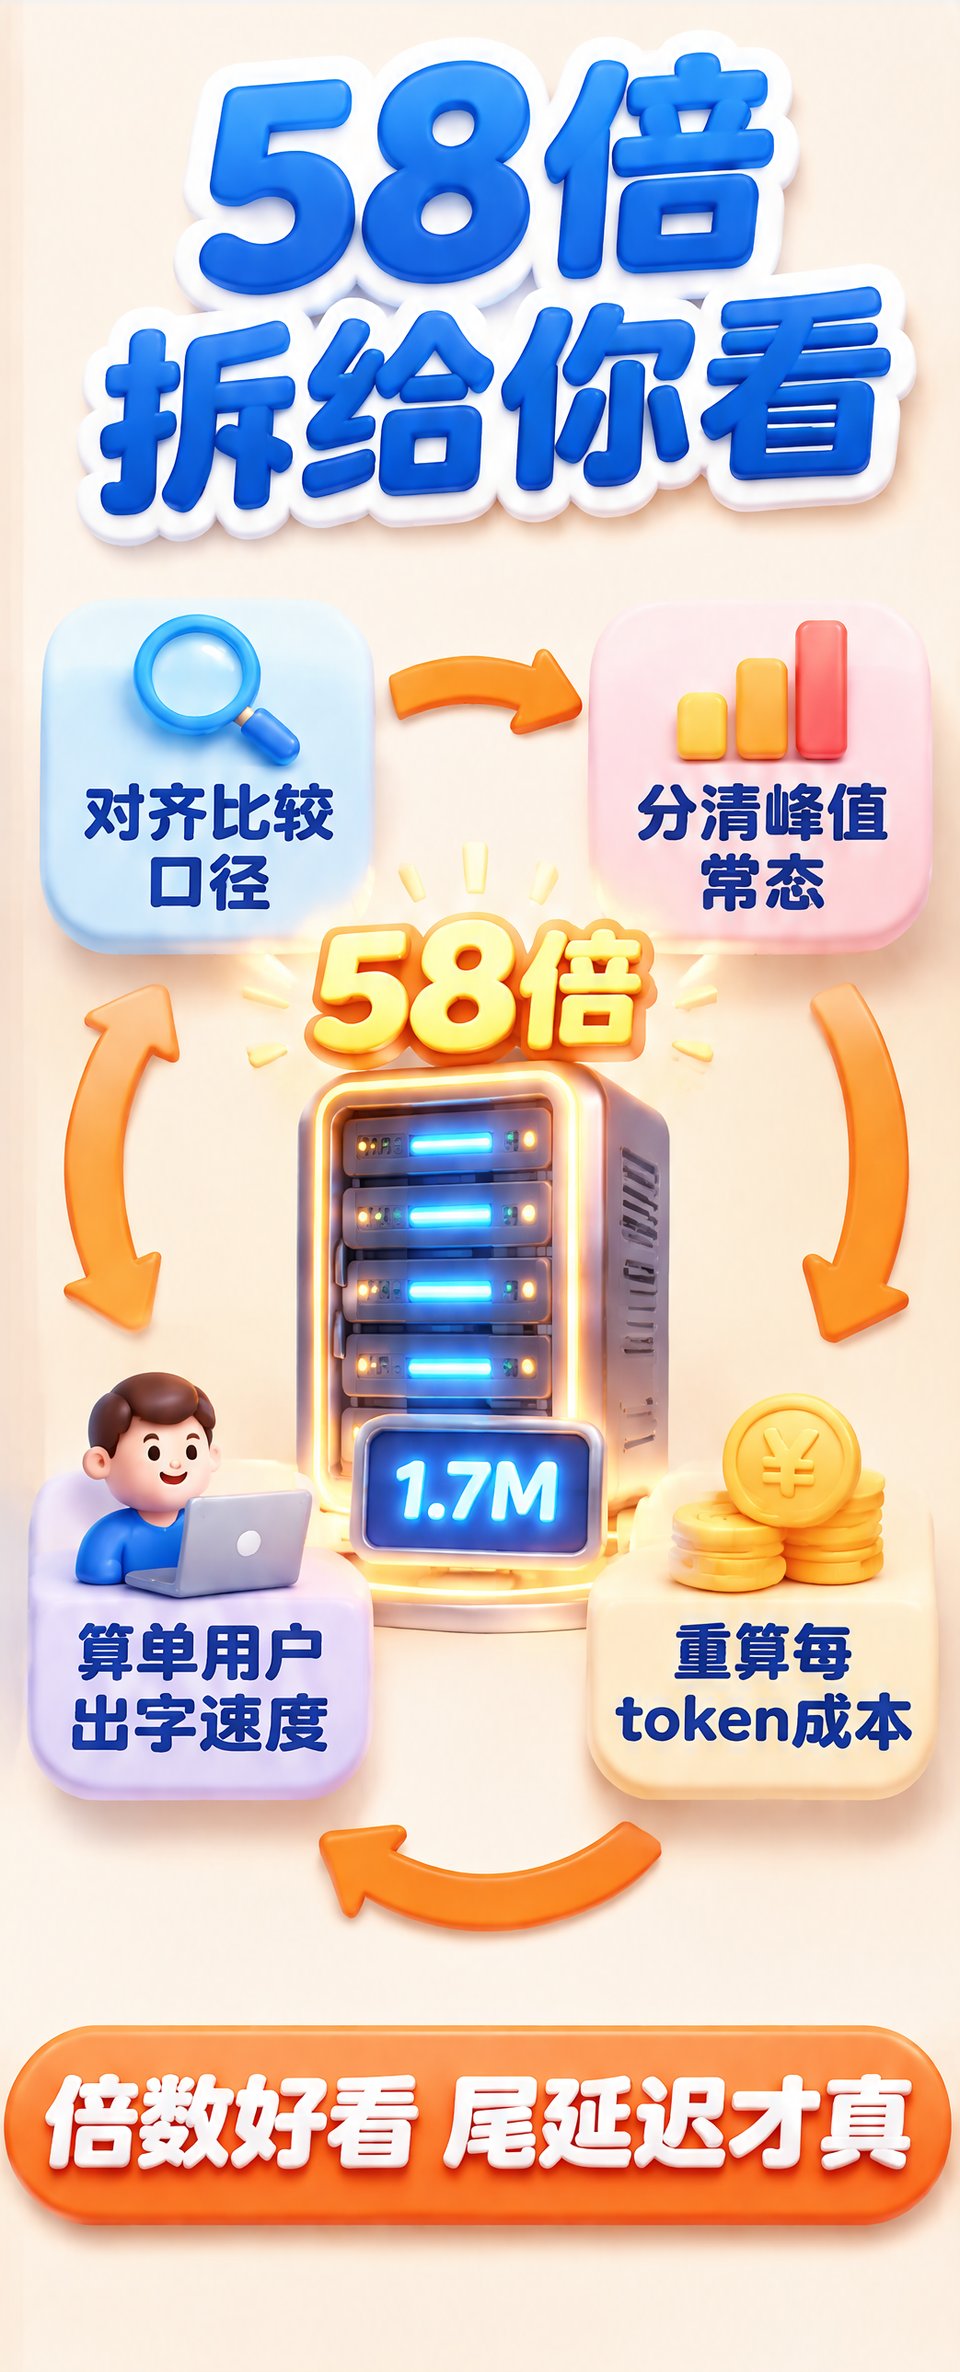
58 倍的分母是 GB300 NVL72,也就是上一代机架级平台,不是某张老显卡。拿它去跟单卡比,等于拿一支球队的进球数去跟一个前锋比,数字没错,结论全错。口径一错,后面每一条推论都会跟着歪,所以这节最值得先读。
每 GPU 吞吐,不是单机总吞吐
比较维度也得看清楚:1.7M tokens/s 是每 GPU 吞吐,不是整机总和。整机 72 颗 GPU 乘上去,量级自然大得多,但那个数没法跟上一代的单卡数并排放。据其公布的实测,这个 1.7M 是逐卡摊出来的口径,只有在这种口径下,58 倍才站得住。
很多人直接拿「单机总吞吐翻了几倍」来说事,那是另一种账本。同样是这台机器,换成单机总吞吐再对比,数字会更大,看着更吓人,但那不是官方那张 58 倍的原始出处。引用之前先确认比的到底是哪一列,别让倍数替你转移了比较对象。
为什么换一代机架能差出这个量级?推理吞吐看三件事:显存带宽、互联、批处理调度。Vera Rubin 这代在带宽和 NVLink 上都换了新规格,调度侧再配合 MoE 的专家路由做批处理。三者一起动才有倍数级的差距,只动一样,拿不到这种数字。
这里还藏着一层机制,常被忽略。MoE 模型每生成一个 token 只激活一部分专家,吞吐和显存容量不是线性关系;堆显存不等于堆吞吐,真正卡脖子的是带宽和路由效率。所以拿「显存翻了几倍」去推吞吐,推出来的数一定跑偏,不如直接看官方实测。
峰值 2.52M,那是天花板不是日常
据 vLLM 官方博客,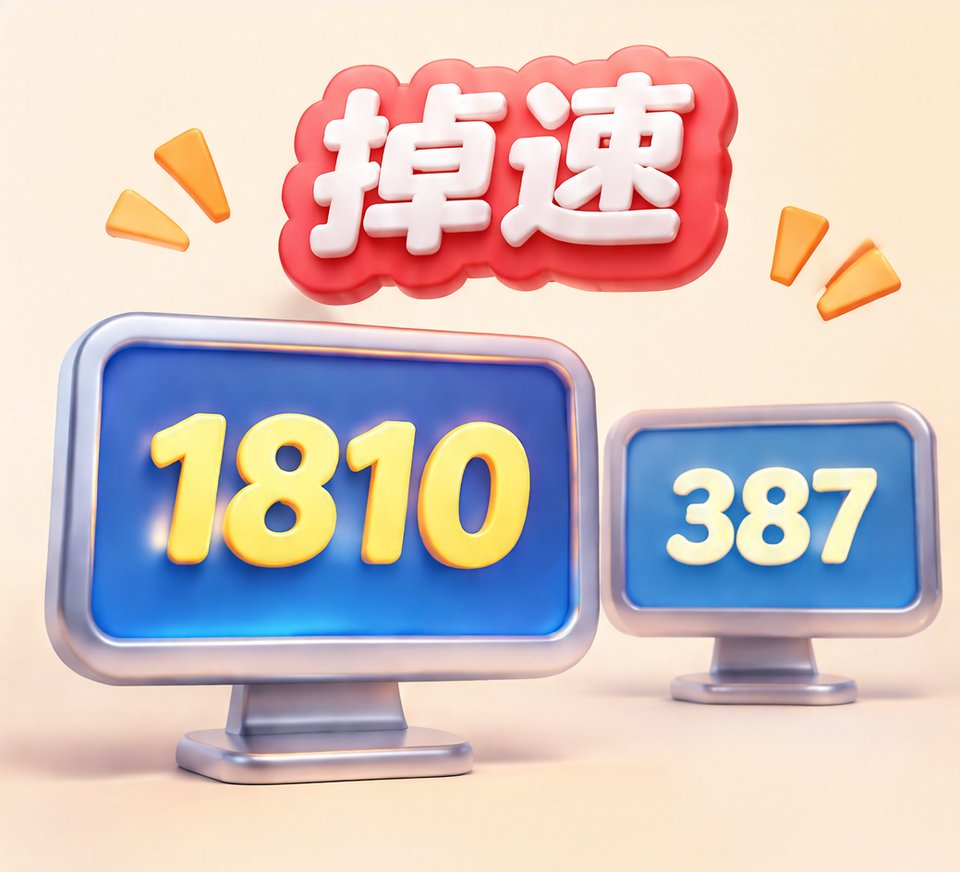
峰值吞吐 2.52M tokens/s、单用户最高 1,810 tokens/s。注意「峰值」两个字:这是把批处理压满、带宽吃到极限时的读数,代表硬件上限,不代表线上均值。按峰值做容量规划,是最常见的一种预算事故。
我的判断:真实业务里能稳定跑到的,通常明显低于峰值。请求长短不齐、并发忽高忽低,调度器不可能一直满负荷,何况还得留余量应付突刺。把 2.52M 当日常吞吐去算单位成本,账会算得过分乐观,报价报出去就收不回来。
峰值数字适合用来判断「这台机器顶格能扛多少」,不适合用来承诺「你线上就有这么多」。做容量设计时,我习惯先打个七折八折的余量,再往上叠并发曲线。倍数再好看,落到峰值以下才靠谱,否则上线第一天就被峰值打脸。
单用户 387 掉到多少,这才是体感
同一批数字里最有信息量的是这一对:单用户 387 tokens/s,峰值下最高 1,810 tokens/s。前者大体是常态下的出字速度,后者是高并发把机器喂饱时单人能拿到的上限。两个数差了四倍多,说明并发一上来,资源分配规则就变了。
换句话说,吞吐和体感是两条曲线。总吞吐上去,服务成本下来;并发挤满时,每个人的等待会变长,尾延迟先炸。规划时得同时看两个数:这台机器能扛多少并发,以及扛到那个并发时,最后一个用户等多久。只报前一个数,等于报喜不报忧。
387 到 1810 的这个区间,其实就是单用户 tokens/s 的弹性范围。聊天框里出字快不快,看的是靠低的一端;只有保证机器有余量,个人体验才贴得近高的那端。所以别只盯着总吞吐欢呼,单人那条线的位置,才决定你的用户嫌不嫌卡。
换硬件,从来不是白捡
同一套权重,换个平台就拿到线性倍数,这种事几乎不存在,至少不会只靠硬件这一个变量。据其公布的实测,58 倍背后是并行策略的调整加 kernel 层的重写,再加新一代硬件的带宽和互联,三者叠出来的。想复刻,得一起改。
我的判断:单看数字会以为「只要换了 Vera Rubin 就有 58 倍」,实际要踩对的坑还有一串。VLLM 是专门给这套机型做的适配,模型是 Flash 轻量版,batch 参数也是按新带宽调的。任何一个环节不对,倍数就要打折扣,直接照搬会翻车。
这也提醒一件事:跨硬件迁移,收益不能只看纸面。换机之前先在真实负载上压一轮,看带宽到底吃没吃满、尾延迟抖不抖,再决定要不要全部切换。同样一份吞吐数字,适配好的团队能兑现七八成,没适配的只能拿到两三成。
云厂商的账本要重算
同样一批机架,能服务的用户数变了,单位 token 成本就得重算。据其公布的实测,一台机器的每 GPU 吞吐是上一代机架的 58 倍,这个比例会直接改写容量模型:过去要几台机架才撑得住的流量,现在一台就够。定价表、SLA、扩容阈值,全要跟着调。
这里有个连带效应,容易被忽略:容量模型一改,采购节奏也改。云厂商按季度屯机器、按年折旧,如果单机吞吐跳了一个量级,旧机器的折旧还没走完,新机器的性价比就已经把它架空了。谁的库存转得快,谁在这轮换机里少亏点折旧。
对云厂商而言,这轮不只是换块卡,是把整个计费逻辑重写一遍。单位 token 成本一旦掉一个量级,按算力小时报价的老方案就站不住,得转成按 token 计量、按吞吐分成的新模型。谁的计量方式跟得上新硬件,谁就先吃到这波红利。
小团队等的是租价
你大概率买不起机架,但这代硬件跟你有关系。云厂商换硬件的动机只有一个:同样的电、同样的机房,多出几倍的 token。竞争一上来,每百万 token 的租价就会被往下压。真正落到账单上的是租价曲线,不是发布会上的倍数。
所以对做应用的团队,这条新闻的价值不在「58 倍好厉害」,在于它给了你一个谈判窗口:下一轮续约,同样的预算应该能买到更多量。提前把用量结构理清楚,知道自己是吃吞吐还是吃低延迟,比盯着倍数转发有用得多。
对小团队最实在的一条建议是别急着扩卡,先把接入方式做对。同一批 token,用便宜的离线批处理跑和用昂贵的实时接口跑,单价差很多。新硬件把吞吐抬上来之后,跑量的成本被摊得更低,俭省的姿势反而比机器本身更值钱。
但这里有个前提
泼盆冷水:这是官方自测,特定模型加特定并行配置,Flash 版本本身就便宜,换成别的大模型或别的 batch 参数,倍数就会变。据其公布的实测是自家机型自家调优,第三方复现之前,58 倍应当读作「上限参考」,不是「你的生产环境」的保证。
更要紧的是尾延迟。带宽跑满的时候,平均 tokens/s 很好看,延迟抖动才是真实体验的杀手,排队一抖,用户就觉得卡。峰值数字测的是快,生产环境拼的是稳,两者不是一回事,别拿发布会读数当生产金标准。
所以这条新闻我会这么读:方向是真的,量级可信,对上一代机架的对比也公允,但结论要落在你的业务里。先用小流量压一压,看尾延迟和单人出字速度合不合预期,再谈倍数能不能兑现。数字负责指方向,压测负责定结论。

