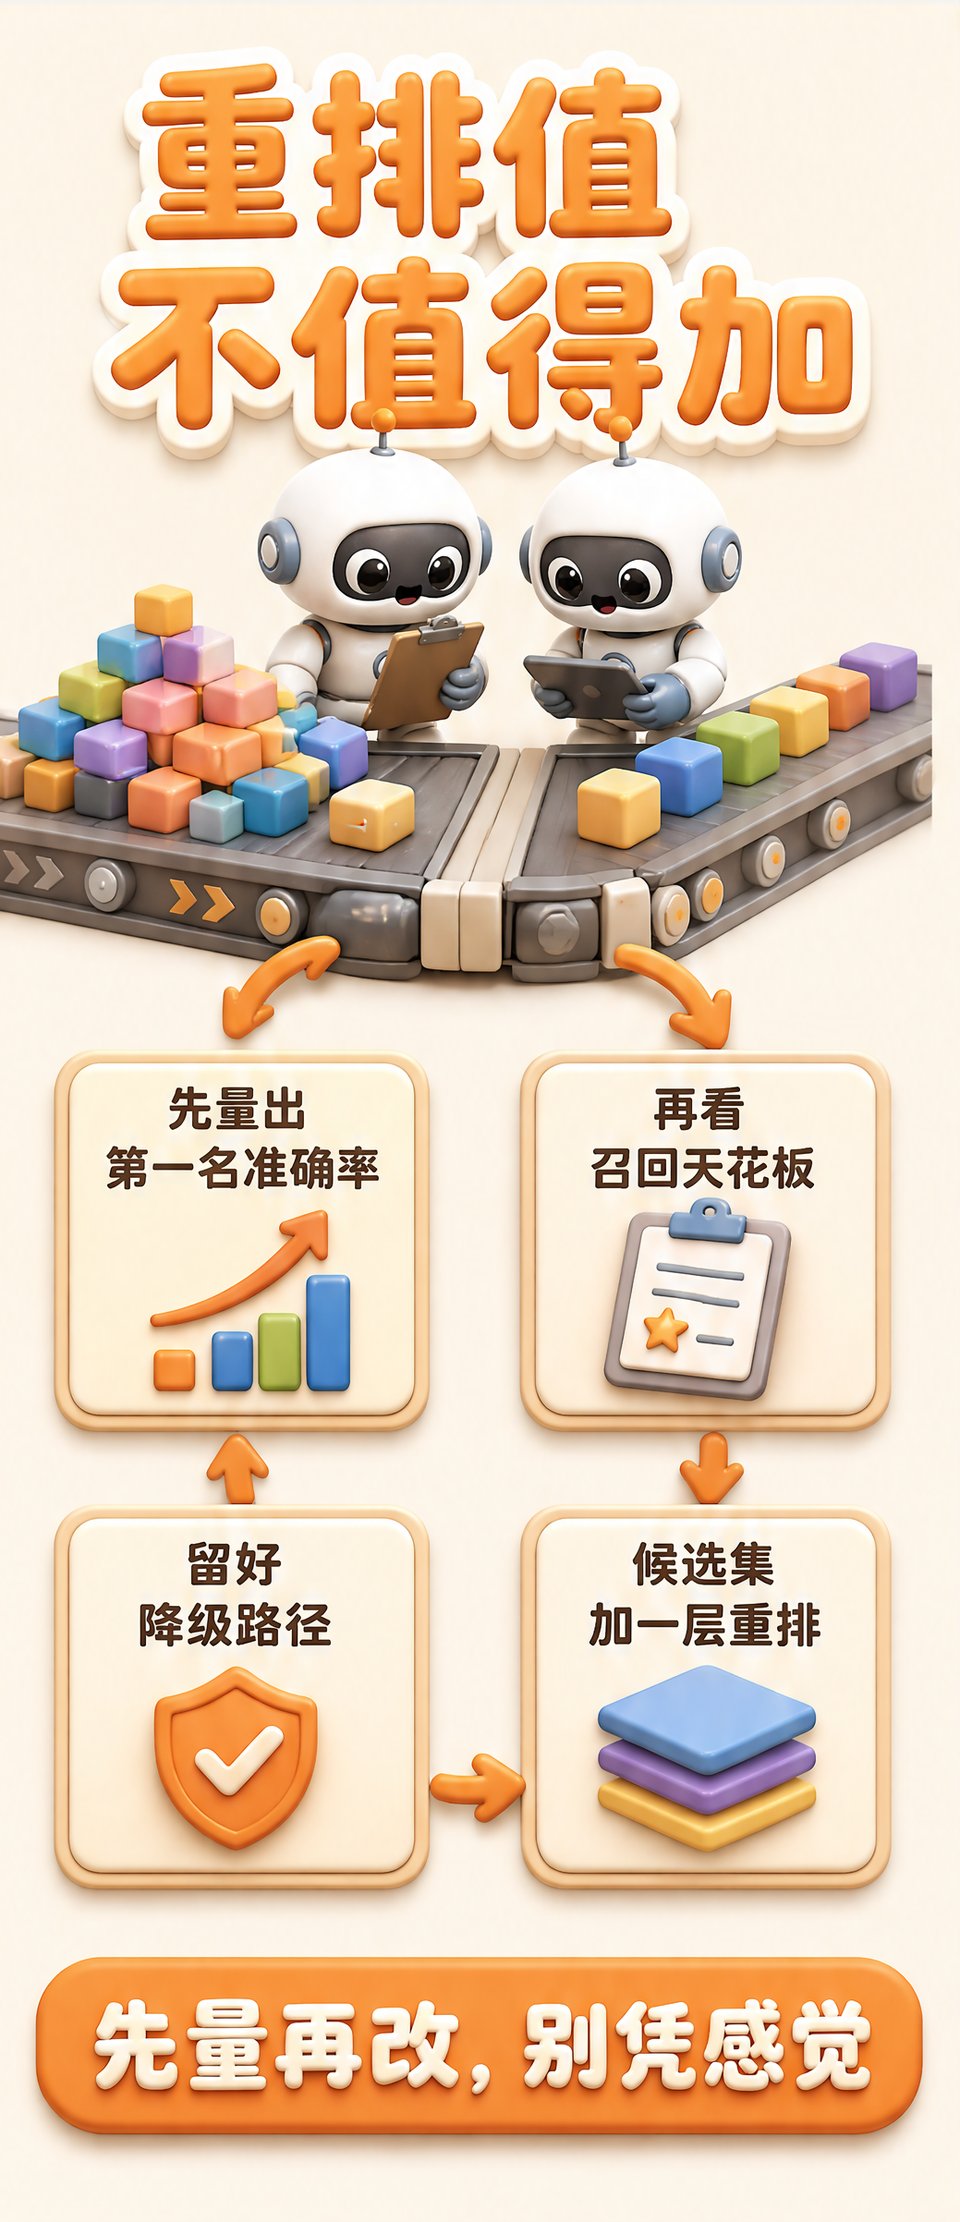
结论先放这儿:模型没换、知识库一个字没动,只在检索结果后面加了一层重排序,第一名答对的概率就从 81.0% 蹦到 97.1%。据 OpenRouter 的教程,这两个数字来自一个 274 题的合成基准。
跑这个基准用的 embedding 是 google/gemini-embedding-2,重排是 voyageai/rerank-3-lite。我第一反应是数字太漂亮,八成是拿数据集喂出来的。回头当工程问题拆了一遍,才觉得不奇怪——它补的不是知识,是排序。而 RAG 答错,一大半就错在排序上。
先把两个词分清楚:
召回和重排
RAG 的检索是两段式,召回和重排各管一头。第一段叫召回:把你的问题变成向量,去库里比相似度,捞回前 N 条候选。它便宜、快,几毫秒能扫几十万条,但只看语义距离,不看「这条到底能不能回答问题」。
第二段叫重排。它把问题和每一条候选原文放在一起,逐对喂给一个交叉编码器打分,重新排队。慢,因为要跑 N 次;准,因为它看的是两者拼在一起的意思,而不是两个向量各自待在空间里的位置。
81.0% 和 97.1% 差在哪一步
据 OpenRouter 的教程,纯向量检索在这个 274 题的基准上,precision@1 是 81.0%。翻译一下,五条问题里有一条,最该被端上来的那段文字被排到后面去了,模型于是拿着次优的段落去组织答案。
对 top 30 候选加一层 voyageai/rerank-3-lite 之后,precision@1 提到 97.1%。注意那个「top 30」:重排不是回全库重新找,它只在已经召回来的 30 条里重新排座次。检索范围一点没扩大,变的只是先后顺序。
所以这 16 个百分点的真实含义是:那 16% 的题,正确段落其实早就被召回来了,只是没排第一。向量检索擅长「大概在这附近」,交叉编码器擅长「这一条才对」。前者负责别漏,后者负责别错。
代价:多花的那点钱,和多等的那点时间
钱不贵。据同一份教程,成本约 $0.10 / 千次查询。一个每天一万次检索的应用,一天一块钱上下。省下的是那堆因为答非所问而重试的 token,这笔账怎么算都划得来。
延迟和成本里,延迟才是真成本。重排要给 30 条候选逐对打分,通常是几十到几百毫秒,而且它串在你的请求链路里,用户能感觉到。别把它当成一个看不见的步骤——要么把候选集砍到 20 条以内,要么首屏先返回、重排结果后到再补。
工程改造也不算小事:链路里多一个服务调用、多一个超时和降级分支、多一份重排额度监控。原来挂了就是检索挂了,现在多一个环节可以挂。上线前最好想清楚,重排超时的那一刻,你返回原始顺序,还是返回空。
我的判断是,返回原始顺序。RAG 里最糟的用户体验不是答案排得不够好,是突然什么都答不出来。降级要降得难看但可用,别降得干净但全空。
多大的库值得上这一层
几千条以内的知识库,我一般不推荐先上重排。候选集本身就只有几十条,向量检索排错也错不到哪儿去,你多付的延迟换不回用户能感知的差别。这个体量,先把切块和字段写对,收益大得多。
几万到几十万条,重排的性价比开始显现。库里同主题段落多,语义距离挤成一团,向量检索分不出那些细微差别,交叉编码器正好补这一刀。到了这个体量,从 30 条里挑一条,重排几乎是必需品。
百万级以上,光靠重排不够。你得先做混合检索、元数据过滤、分层召回,把候选集压到一个重排模型吃得下的规模,再谈排序。重排是最后一道筛子,不是第一道筛子。
什么时候先别加,去修切块
有一种症状,加多少层重排都白搭:正确答案压根没进候选集。候选集里没有的东西,
重排救不了。这时你的 recall@30 就是天花板,它只能在 30 条里排座次,排得再漂亮也变不出第 31 条。
第二种,切块切碎了。一条完整的规则被切成三段,每段都缺主语,重排模型看到的是三个残句,它再准也只能挑出一个最像的残句。先按语义边界切,别按固定字数硬切。
第三种,元数据没用起来。文档有部门、时间、版本这些硬字段,先用过滤把范围缩到该看的那些,比让模型在一堆过期文档里猜要靠谱得多。过滤是确定性逻辑,重排是概率判断,能用前者的时候别用后者。
几个我踩过的坑
中文效果别想当然。rerank-3-lite 这类模型的多语言能力不差,但中文长句、同义改写、缩写术语,实际表现得自己测。我见过的翻车,是把「报销标准」和「报销流程」判成高度相关,因为它看到的字面太像了。
候选集太小,重排没意义。只看 top 5,等于把排序问题变成五选一,提升自然看不出来。教程用 top 30 是有道理的:候选要够杂,重排才有活干。
别只盯 precision@1。这个指标衡量「第一名对不对」,很适合事实问答,但不适合那种要凑齐多条证据的总结类任务。你的场景要什么,先定义清楚再测。
还有一个更隐蔽的:换重排模型要重测。它跟 embedding 是两套模型,各自独立更新,上线前攒的那套评测结论不能直接搬。
先量再改:三步自查清单
第一步,攒题。从真实日志里挑 50 到 100 个问题,人工标出每条的标准答案段落。不用多,但必须是真问题,不是你坐在工位上现造的。
第二步,量 baseline。先只跑向量检索,算出 precision@1 和 recall@30 两个数。前者告诉你现在排得准不准,后者告诉你重排的天花板在哪儿。
第三步,看差值。如果 recall@30 已经 95% 以上,而 precision@1 只有 80%,那这 15 个点就是重排能吃到的,值得上。如果 recall@30 只有 70%,先回去修召回和切块,别急着买排序。
顺序别反。先量再改,改完再量,两次数值摆在一起,你才知道那一层到底有没有用。我见过太多团队凭感觉加组件,加了半年,没人说得清 precision 是涨了还是掉了。
FAQ
Q:没有 GPU,能上重排吗? 能。走 API 就行,voyageai 这类服务按次计费,不用自己部署。真要在本地跑,交叉编码器的显存需求也比大模型低得多。
Q:重排会不会把原本对的结果改错? 会。81.0% 到 97.1% 是平均值,个别题会从对变错。所以降级路径和回归测试得有,别默认它只涨不跌。
Q:混合检索和重排,先做哪个? 先看 recall@30。召回漏得多,先做混合检索(向量 + 关键词);召回够全只是排不准,再上重排。

