
一句话:智能体的长期记忆最怕的不是忘,是记错了还一直信。MIT、Meta 与耶鲁的团队 2026 年 10 月挂上 arXiv 的 ReHarness(编号 2610.12668)给的解法很省:不重建记忆库,只修这次被检索出来、又被证明不好用的那几条笔记。
先看那个排序的例子
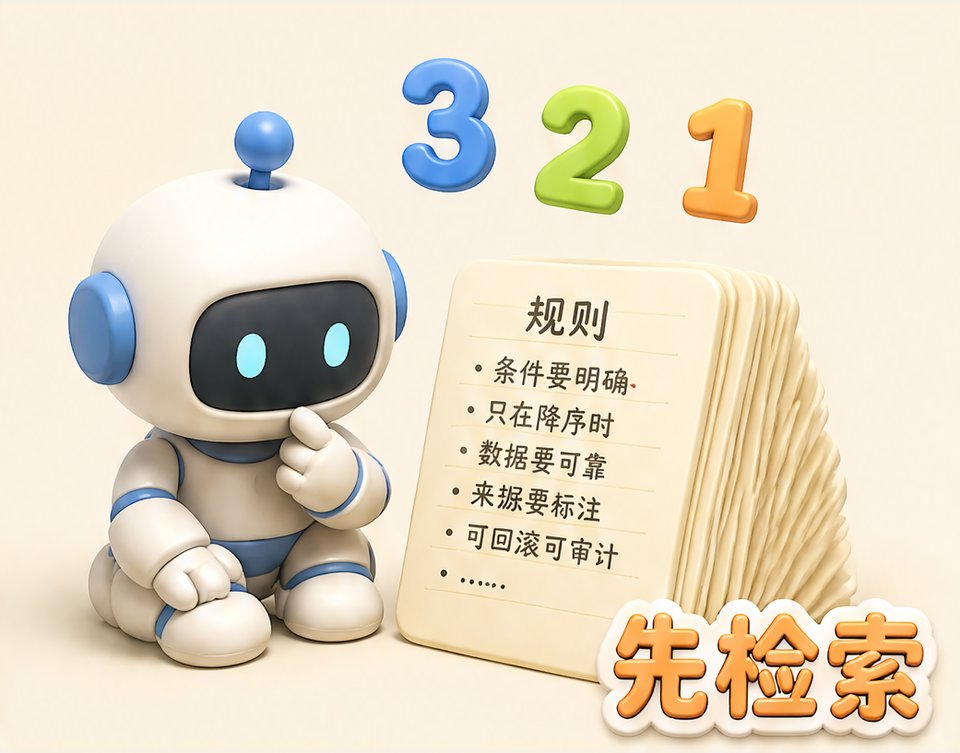
论文开篇的例子短得像段子。智能体拿到 {3,7,4} 要求降序,它答对了,顺手写下一条经验:「大的放前面」。下一个任务是升序 {2,9,5},系统检索到这条经验照做,答错。
它又写了一条新的:「小的放前面」。但旧的那条并没有被删,还躺在库里。第三个任务来了,检索又把「大的放前面」捞出来,于是它再错一次。错误没有扩散,错误在原地重复。
这就是问题的形状。不是模型不够聪明,是那条写歪的笔记一直有效、一直能被召回、一直没人回头改它。据该论文的描述,这类过时或过度泛化的反思,会在后续检索里被反复激活。
记忆系统真正的 bug 是「记错还信」
我们平时聊 AI 记忆,盯的是容量和召回率:能不能记住上个月的决定,能不能找回三个月前的文档。这些指标都默认「记住是好事」。可经验有保质期,写进来时对,环境一变就不对了。
论文把现有做法叫「只进不出」:一个记忆智能体在任务结束后写经验,一个决策智能体在新任务开始时读经验,信息流单向往前。写和读都只往前走,状态只增不改。据该论文摘要,这类框架的短板就在这里。
单向积累在分布漂移时最要命。据论文对稳定性与可塑性的拆解,Mem0、RBank、DoT、ACE、GEPA-Online 这几种记忆或提示优化方法,在漂移后的第一个实例上平均增益是负的——带着这些记忆,比不带还差。
我的第一条判断:所谓「记忆污染」,本质是缺一条回收通道。每写一条经验,系统同时欠下一笔债——「这条日后要是误导了谁,谁负责来改」。只进不出的库,债只增不减,最后整库都是没人敢删的旧账。
只改被用到的那几条
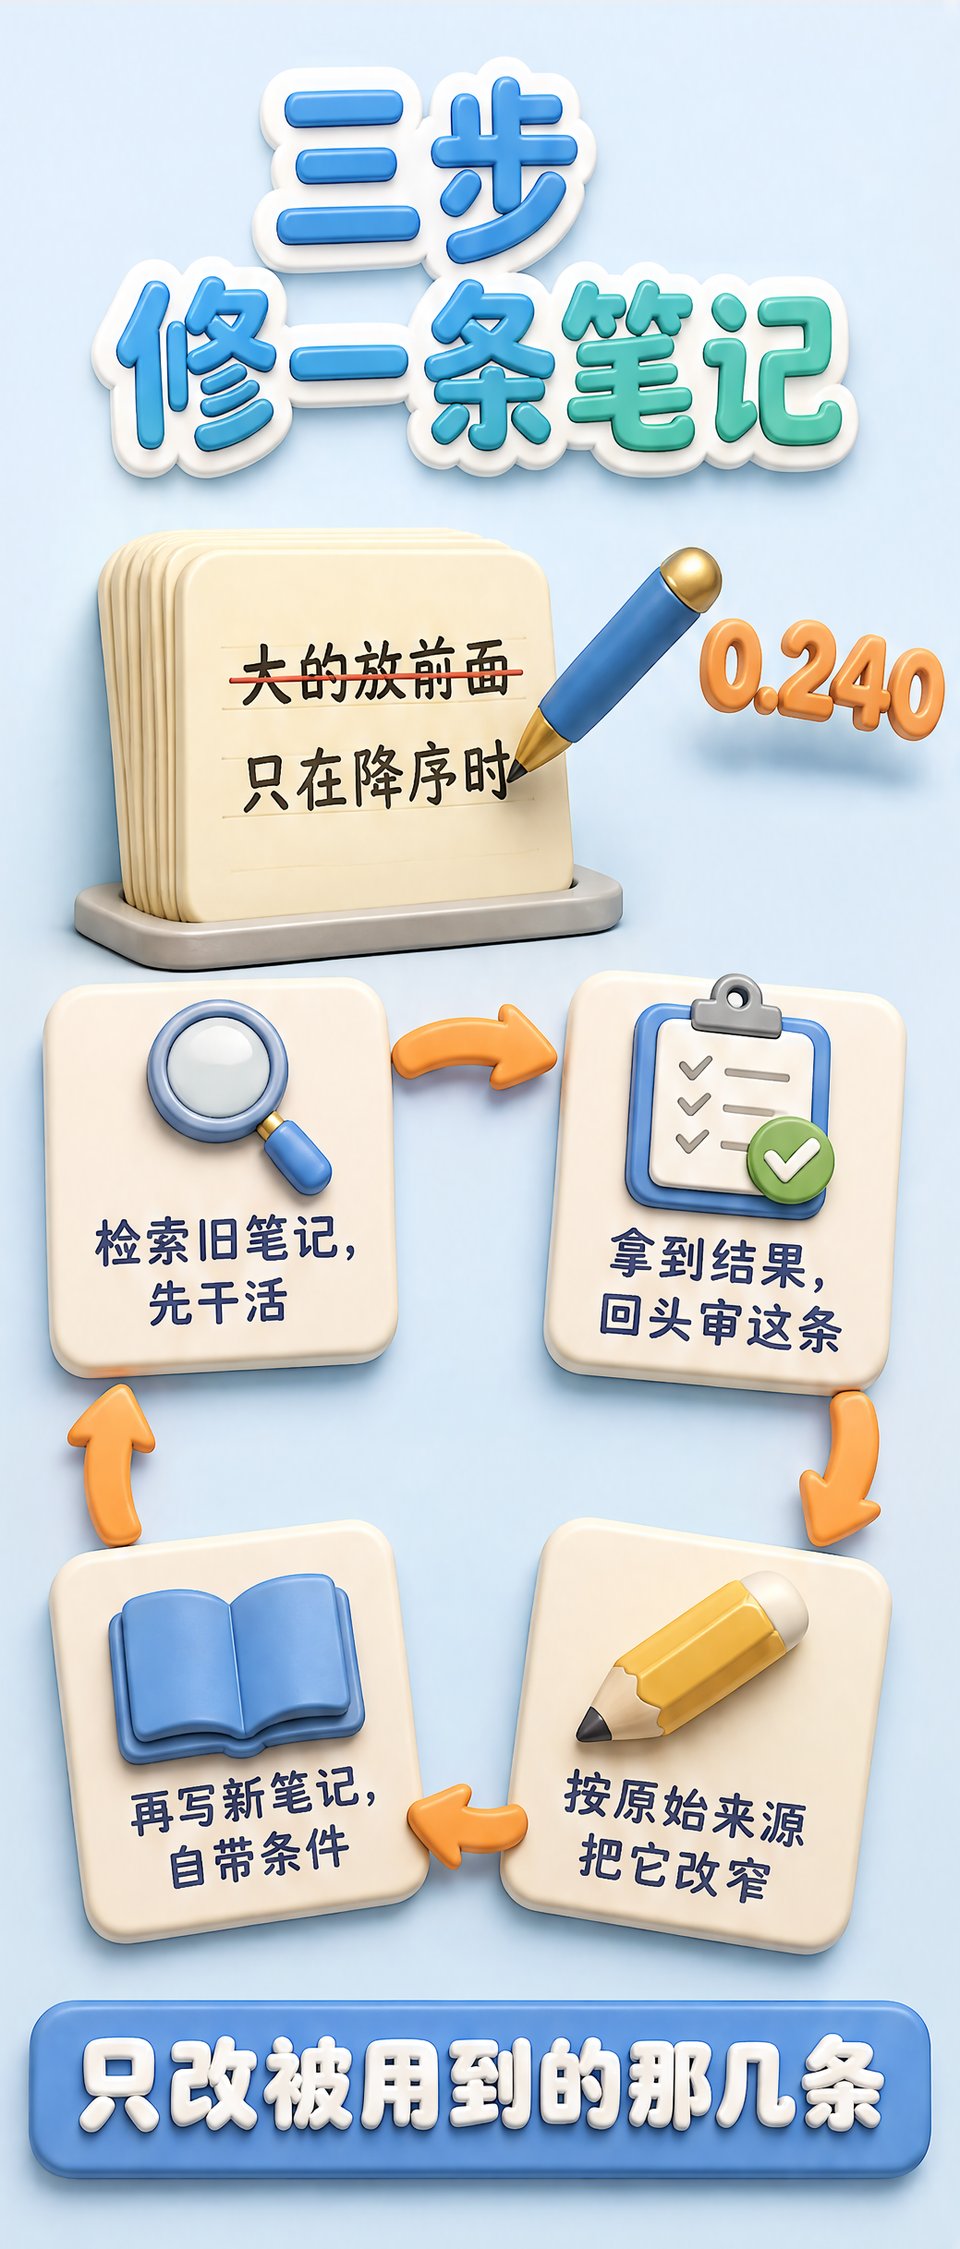
ReHarness 的做法,是把「读—写」这条单行道改成三步循环。第一步前向读:按当前输入检索最相关的几条反思,交给干活的智能体。第二步反向修订:拿到这次的轨迹和奖励后,由一个修订智能体逐条重审刚才用过的那几条。
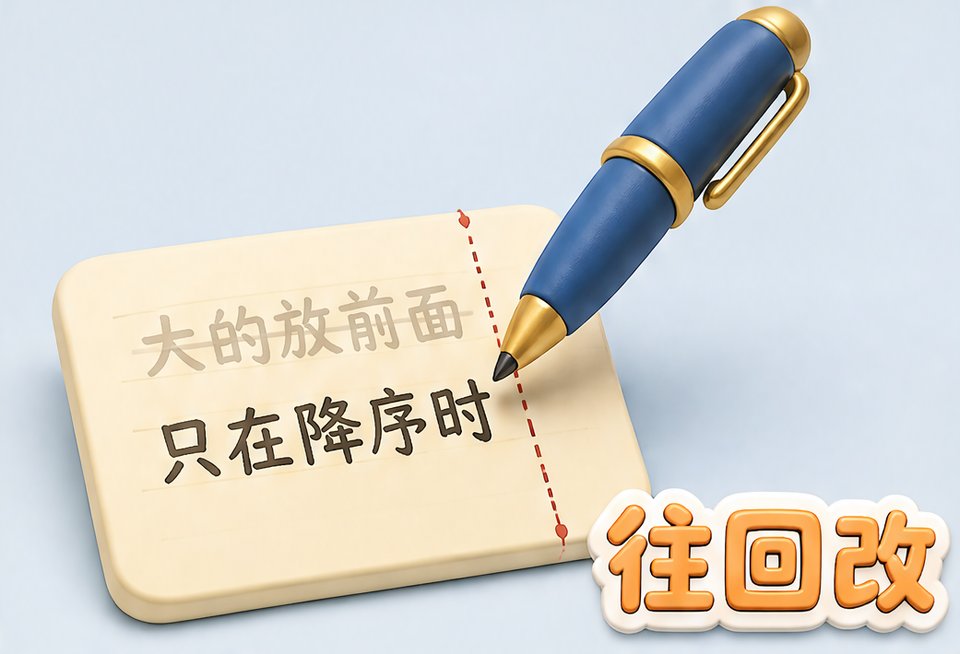
第三步前向写:记忆智能体照这次的轨迹写一条新经验,并且拿刚修好的旧经验当示范,让新经验一开始就带上适用条件。据该论文,排序那个例子里,旧经验被改成「只在降序时把大的放前面」。
整个设计里我认为最硬的是一个细节:修订时,当前这次的轨迹只能当「反馈信号」,不能当「内容素材」。新写进去的事实必须锚定在它自己那条旧经验的来源轨迹上,否则就等于把答案抄进去了。
这条约束叫 grounding,作用是防泄漏。据论文的审计,三个模型骨干上,修订内容「有来源依据」的比例都超过 95%;Claude 那一档的修订率是 0.868,平均每条经验改 2.41 处。改得不多,但每次改都有凭据。
关键在「只改被检索到的那几条」。整库重写听着更彻底,可它每轮都要跑一遍全量,成本随任务数线性涨,而且改了什么、为什么改,事后根本说不清。只动被用过的那几条,改动范围天生可解释,也能回滚。
0.240 这个数怎么读
主指标叫归一化增益:一条任务流上,方法的奖励减去「不带记忆的裸模型」的奖励,再除以「理论最高奖励减去裸模型奖励」。它衡量的不是准确率,而是「从历史经验里学到的东西,到底值多少钱」。
据该论文表 1,三个基准(CL-Bench、MemoryBench、MemoryArena)乘三个模型骨干(Claude、GPT、Gemini)的平均归一化增益是 0.240。最强的原始轨迹基线 Top-K Raw 是 0.168,把全历史塞进上下文的 Full Raw 是 0.164。
九个组合里,ReHarness 在八个排第一或并列第一。配对 Wilcoxon 检验做了 Bonferroni 校正,对 Top-K Raw 的校正后 p 值是 0.039,对 Full Raw 是 0.043,都过了显著性线。
更值钱的是成本那一栏。据论文的消融,ReHarness 不需要多大的修订集就能赢过最强的全历史基线,token 消耗大约是后者的三分之一——反过来说,在 CL-Bench 配 Claude 这一组上,把完整原始历史重放一遍要多烧 3.4 倍 token。
拆掉修订模块的对照也很干净。同一组设置下,没有修订时平均增益 0.144,加上修订是 0.217,CL-Bench 六个任务全都更高。反事实重放能到 0.335,但那把修订后的记忆用回了已经看过的那个实例,违反在线协议,不算线上成绩。
为什么这套思路值得普通团队抄
第一件事,给每条笔记加元信息:写入时间、来源任务、当时成功没成功、被用过几次。ReHarness 能修订,前提是它知道「这条笔记是为哪次任务写的」,原始轨迹也还留着。没有来源,连改的凭据都没有。
第二件事,把「重放历史」当兜底,别当默认。全历史塞进上下文确实有效,论文里 Full Raw 也有 0.164,只是贵。日常用检索出的少数几条,出问题、或者任务类型刚变过的时候,再放全量兜底。
第三件事,每轮任务结束后做一次小修订。不是让模型「反思一下」,而是点名让它重审这次用到的每一条,问一句「它当时该怎么写,才不至于让你这次走错」。修订完的笔记要有版本号,能回滚到上一版。
这三件事的共同点是便宜。改动范围小、每次只动几条、来源清楚,出错时能定位到具体哪条经验把哪个任务带偏了。对没资源自研训练流程的团队,这个量级才现实——先要能改一条,再谈重建一座库。
但这里有个前提:对错信号
整套方法的燃料是「这次任务的轨迹和奖励」。修订智能体要判断旧经验好不好用,得先知道这次干得对不对。这个信号在基准里是现成的,每题都有评分;在你的业务里,八成没有。
论文自己也撞了这堵墙。据论文的任务级拆解,CL-Bench 里的 exploitable 扑克任务上,ReHarness 只有边际增益,作者把原因归到「手牌级别的奖励噪声太大」——运气盖过了策略,反馈本身没有诊断性。
所以泼盆冷水:没有干净的成功/失败标签,这套方法会退化。修订智能体拿不到可信的对错,就只能靠模型自己的反思去猜,而「让模型反思自己的判断」这件事,恰好是这篇论文想绕开的那个坑。
我的第二条判断:长期记忆的工程难点,接下来几年会从「存和取」挪到「标注」。谁能把每个任务的成败写得够细、够及时,谁的记忆系统就能自我纠错;谁的成败只有一句「用户没说不满意」,谁就只能攒一堆没人敢删的旧笔记。
还有个更细的门槛:来源轨迹得留得住。ReHarness 要求修订内容锚定旧经验的原始轨迹,那就意味着每次任务的过程日志不能只存结论,得存住过程。这一步很多团队省了,省掉之后修订就只能靠想象。
常见问题
问:这跟 RAG 有什么区别?RAG 是把文档检索进上下文,文档本身不动;ReHarness 动的是模型自己写的反思,而且是被用过、被验证过好不好的那些。前者管知识,后者管经验,混着用容易两头不讨好。
问:为什么不干脆每轮重训模型?因为论文的协议是严格在线流式:每个实例只出现一次,没有验证集,模型只能走 API,没有梯度可算。这套约束恰好就是多数团队的真实处境——你调不了权重,只能调上下文里的文字。
问:小团队现在能上手吗?能,但先做最土的那版:笔记带来源和时间戳、每次任务后只重审用到的那几条、修订留版本可回滚。据 Rohan Paul 在 X 上的转述,这项工作的重点落在「反向修订」这一环,而不是把记忆库做大,这个顺序别搞反。

