
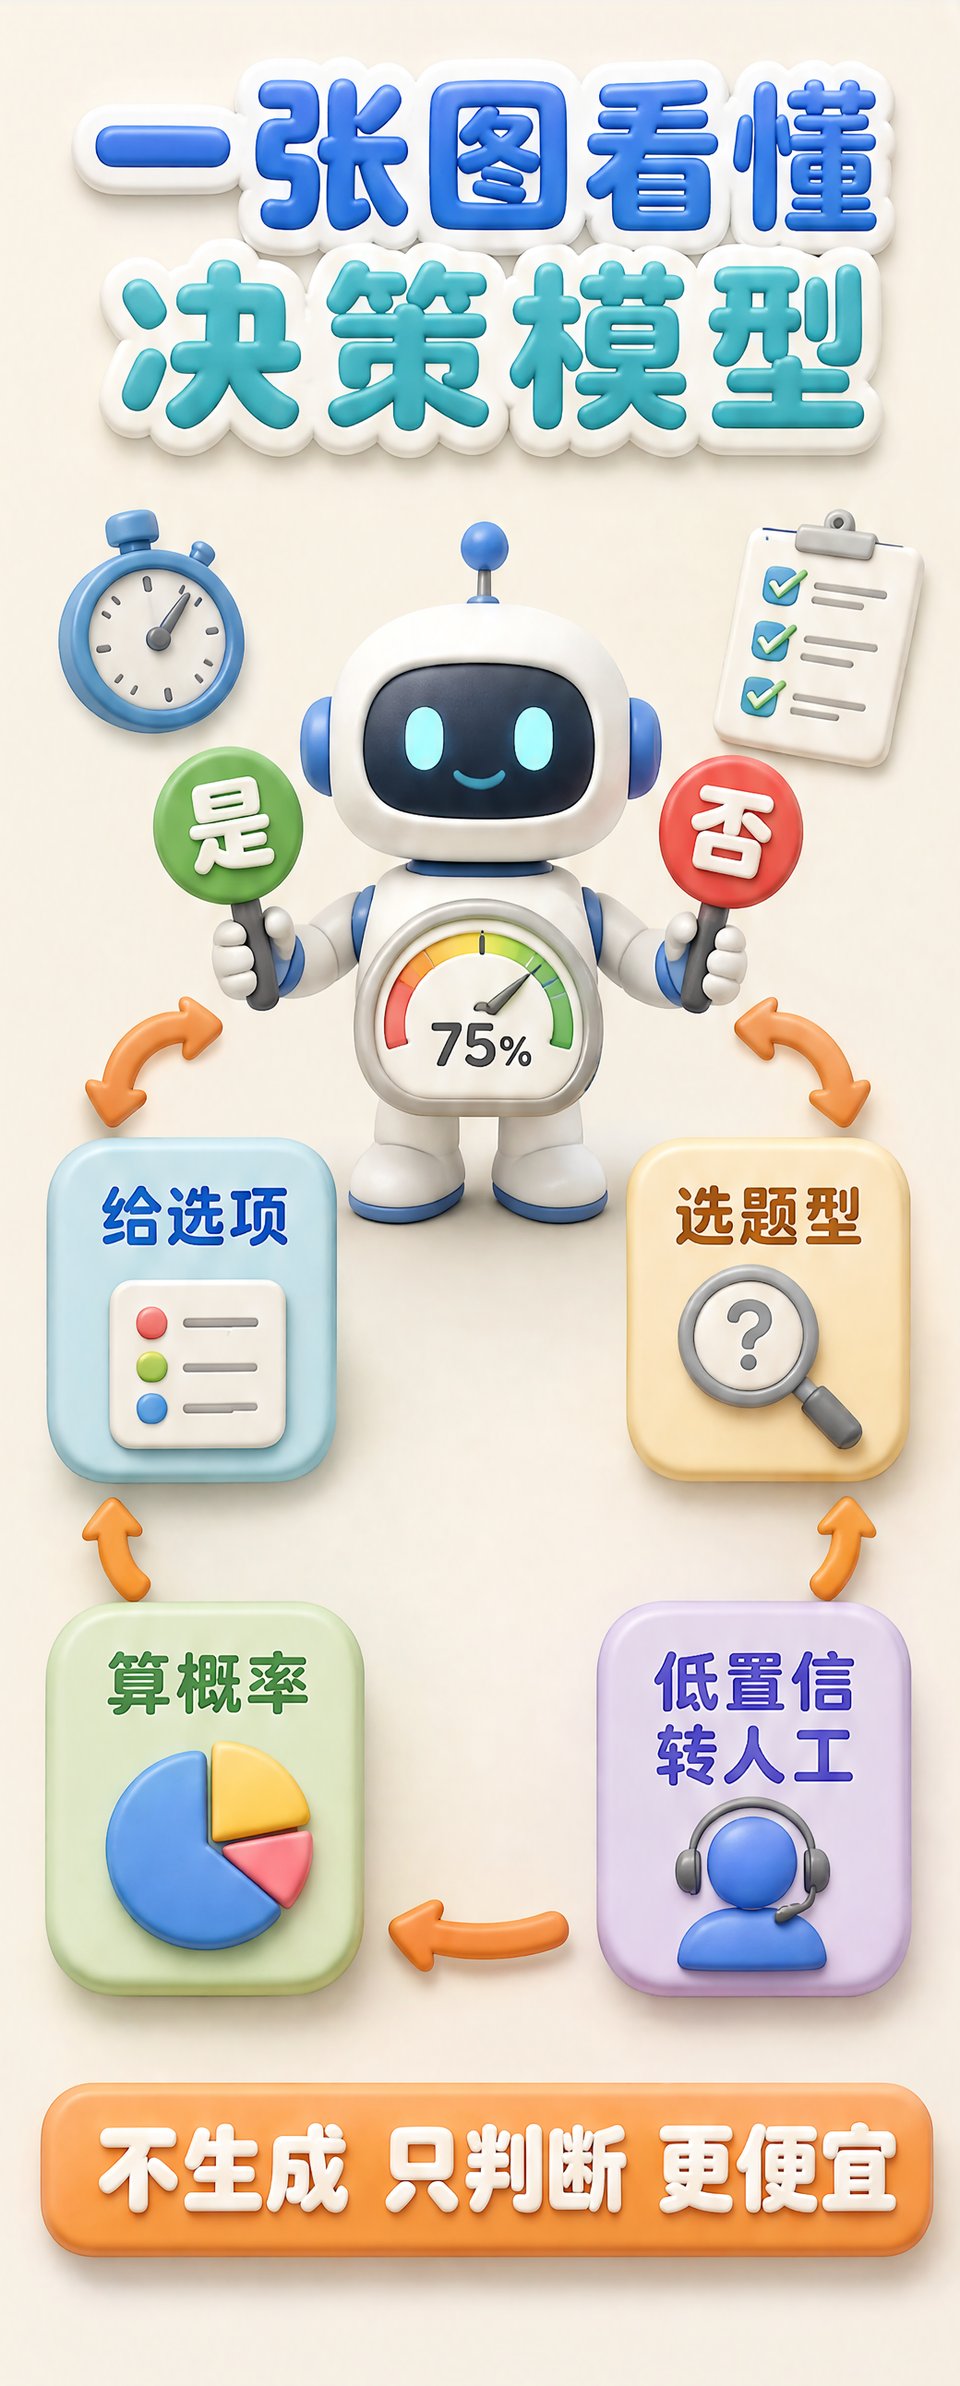
一句话:Gemini Decision 1 不写文章,只对摆在面前的选项打分,然后回你一个是、一个否,或者「选第几个」。据 Google 官方博客,这套 API 2026 年 11 月 11 日发布,一次前向算完,不逐 token 生成。
配套模型叫 gemini-decision-1。一次请求最多带 1,000 个问题,输入上限 262,144 token,差不多一本中篇小说的体量,塞进去一次判完,不用来回对话。下面是它到底怎么算的。
它干的事,就一件:打分
把 Decision 1 想成一个极挑剔的判卷老师。你给它一段材料,再给一张问题清单,它不写作文,只挨个勾:这题是、那题不是、这道从五个里挑第三个。
说白了,它把「回答问题」换成了「做选择题」。答案空间是封闭的——要么是,要么否,要么从一堆选项里挑一个,没有第三条路可走,也没有「我觉得还有别的可能」这种发挥空间。
三种题型,把话说死
题型只有三种。noul 是是/否,返回一个概率;choice 在 2 到 255 个选项里挑一个,给归一化概率;score 按有序量表打分。每题都附一个 0 到 1 的置信度。
三种题型基本盖住了「判断」的常见形态:要不要、选哪个、有多好。再多就没了——它不写理由,也不会帮你补一个你没列的选项。后面这件事很要紧,我先记在这里。
为什么不算文字,反而更准
划重点:生成模型写字的每一步,都是从上万个候选词里抽一个。抽样就有随机性,同一个问题问两遍,答案可能不一样。Decision 1 把这一步删了:它不算下一个词,直接对「是」和「否」两条路算概率,谁高听谁的。
据 Google 官方博客,端到端延迟 150 到 250 毫秒(16K 以内上下文)。更值钱的是另一句:问题数从 1 涨到 100,性能几乎不变。
我的判断:这才是它跟聊天模型最根本的分野。生成模型是「一个问题一次调用」,10 个问题就是 10 次;决策模型是「100 个问题共用一次前向」,材料只读一遍。前者按字收费,后者按判断收费。
还有个副作用:因为没有解码采样,同一个输入跑两遍,输出是稳定的。生成模型做不到这点,温度调再低也可能抖;拿它做规则校验,这种抖很要命,你会分不清是规则变了还是模型抽风。
定价:$0.10 一百万 token
据 Google 官方博客,输入 $0.10/百万 token,输出不计费——因为它根本没有输出 token。同一套基准上,它比 Gemini 3.5 Flash-Lite 配 Interactions API 便宜近 5 倍。
这里要较真:便宜 5 倍不是把单价砍下去,是架构省出来的。老做法让模型把思考和答案一起吐,思考 token 照样按输出收钱;Decision 1 没有思考过程可吐,只算一次概率。
所以别把它当「更便宜的小模型」。它是换了计价单位:按判断次数付钱,不按字数付钱。用量大的业务,这两种账会越算越不像,规模越大差得越离谱。
置信度那栏,比准确率有用
每题返回的 0 到 1 置信度,是这套 API 里最容易忽略、也最该用起来的一栏。0.93 和 0.51 都是「是」,含义完全不同:前者能直接放行,后者说明模型自己在犹豫。
用法很直接:设个阈值,比如 0.8,低于阈值的全部转人工,或者转给贵模型复核。成本曲线于是从一条直线变成一条你能自己调的斜线——要 95% 的自动化率还是要 99% 的准确率,旋钮在你手上。
说白了,它把「我有多确定」做成了一个可读字段。以前的模型也会不确定,但它不确定的时候,照样用同样自信的语气写完一整段,你只能靠猜。
对 Agent 架构意味着什么
现在一个 Agent 干活,要用主模型做一堆小决定:这轮该调哪个工具、上下文够不够、该走规则还是走模型。每个小决定都是一次完整调用,token 和延迟都花在判断上。
拆出来之后架构清爽了:贵模型负责它真擅长的生成和规划,判断的小活交给 Decision 1。据 VentureBeat 报道,它的落地场景就是工具选择、策略与规则校验、模型路由、上下文质量分级。
模型路由是最典型的用法。用户一句话进来,先判它该走便宜的小模型还是贵的旗舰,一次判断一百多毫秒、成本不到一分钱;判错代价也小,置信度低就上浮一档。比让旗舰模型先通读一遍再决定便宜太多。
集成铺得不慢:OpenRouter、LangChain、Vercel、LiteLLM、Pydantic AI、Pipecat、LiveKit、OpenCode 都已接上。文本、图片、音频、视频、PDF 能塞进同一个输入。
一个具体例子。据 VentureBeat 报道,语音框架 Pipecat 1.16 新增的 PerceptionReader 用 Decision 1 判断说话人的韵律、语气和讽刺。语音 Agent 以前普遍缺这一维:它听得清你说什么,听不出你在阴阳怪气。
不是它一家在做
OpenAI 有 Decisions API,配 GPT-6 Luna;Amazon 有 Strands Decider;TypeSafe 出了 Jev。据 VentureBeat 报道,Perplexity 把 Decider v1.3 和 Decider Flash v1.3 直接开源,权重挂在 HuggingFace,OpenRouter 免费一周,还加了 locate 能力。
竞争一来,schema 会互相抄齐。我的判断:半年之内,「决策模型」会从新品类变成基础设施的一层,像当年的 embedding 接口,谁都得有,但先做的那家定规矩。
但这里有个前提
第一刀是闭集。它只能在已经列好的选项里挑。选项没列全,它判得再准也是错,而且错得毫无察觉——它不会告诉你「这里缺一个更好的答案」。
举个具体的:工具清单漏了那个真该用的工具,它不会喊缺,只会从剩下的里挑个最像的,还回你 0.88 的置信度。你看到 0.88,以为稳了,其实从第一步就歪了。
第二刀是校准。置信度这栏只有校准做得好才有意义。如果它说 0.9 的判断实际只对七成,那这个数字就是假精确:你按 0.9 设阈值,等于把一堆错判放了过去。
上新业务前,先拿几百条真实样本画一条校准曲线,看它说 0.9 的时候到底准几成。这一步省不了,省了就等于把方向盘直接交出去,出事还找不到原因。
第三刀:它只回答你问的。问题含糊,答案照样干净利落,看不出毛病在哪。判断题的输入设计比调 prompt 更要紧,这活最后还是人的。
所以它省的是「判断」的钱,不是「想清楚该判断什么」的钱。前者能自动化,后者暂时还得靠人,这也是我反复说选项和提问要紧的原因。
顺便答三个问题
问:这东西能替掉我现在的模型吗?答:替不掉。它只回选项,不生成内容。写文案、改代码、做总结还得靠生成模型,它是插在旁边专门判是非的那一层。
问:一千个问题一次发,会不会判串了?答:据 Google 官方博客,问题数从 1 到 100 性能几乎不变,每题独立算概率、独立给置信度,按返回顺序对回去就行。
问:置信度低就一定是难题吗?答:不一定。它也可能只是被措辞绕晕了。低置信度先别急着升级大模型,把问题重写清楚再问一遍,往往更划算。

