
ARC Prize 把 Google Gemini 4 Carbon 的成绩挂上了榜单:ARC-AGI-3 拿到 99.1%,ARC-AGI-2 拿到 94.2%,官方还给了完整结果页和 GitHub 上的复现仓库,连跑法都写清楚了。数字漂亮到有点不真实,先别急着转发,账在后面。
因为同一份材料里还躺着另一个数:65.1%。同一个模型,同一天公布,和 99.1% 差了 34 个百分点。这不是笔误,也不是两个版本,是两套跑法各自跑出来的。这篇不吹分数,只算账:这 34 分是谁弄丢的,4.6 千和 7.2 千美元又分别买到了什么。
先把结论摆前面:这不是模型退步了,是评测的架子换了。同一份权重,架子一换,分数就从天花板掉到及格线附近。所以下面每个数字后面都得跟一个括号,写清它是在什么条件下跑出来的;少了这个括号,数字只是一句口号,还是那种传三手就会变成「超越人类」的口号。
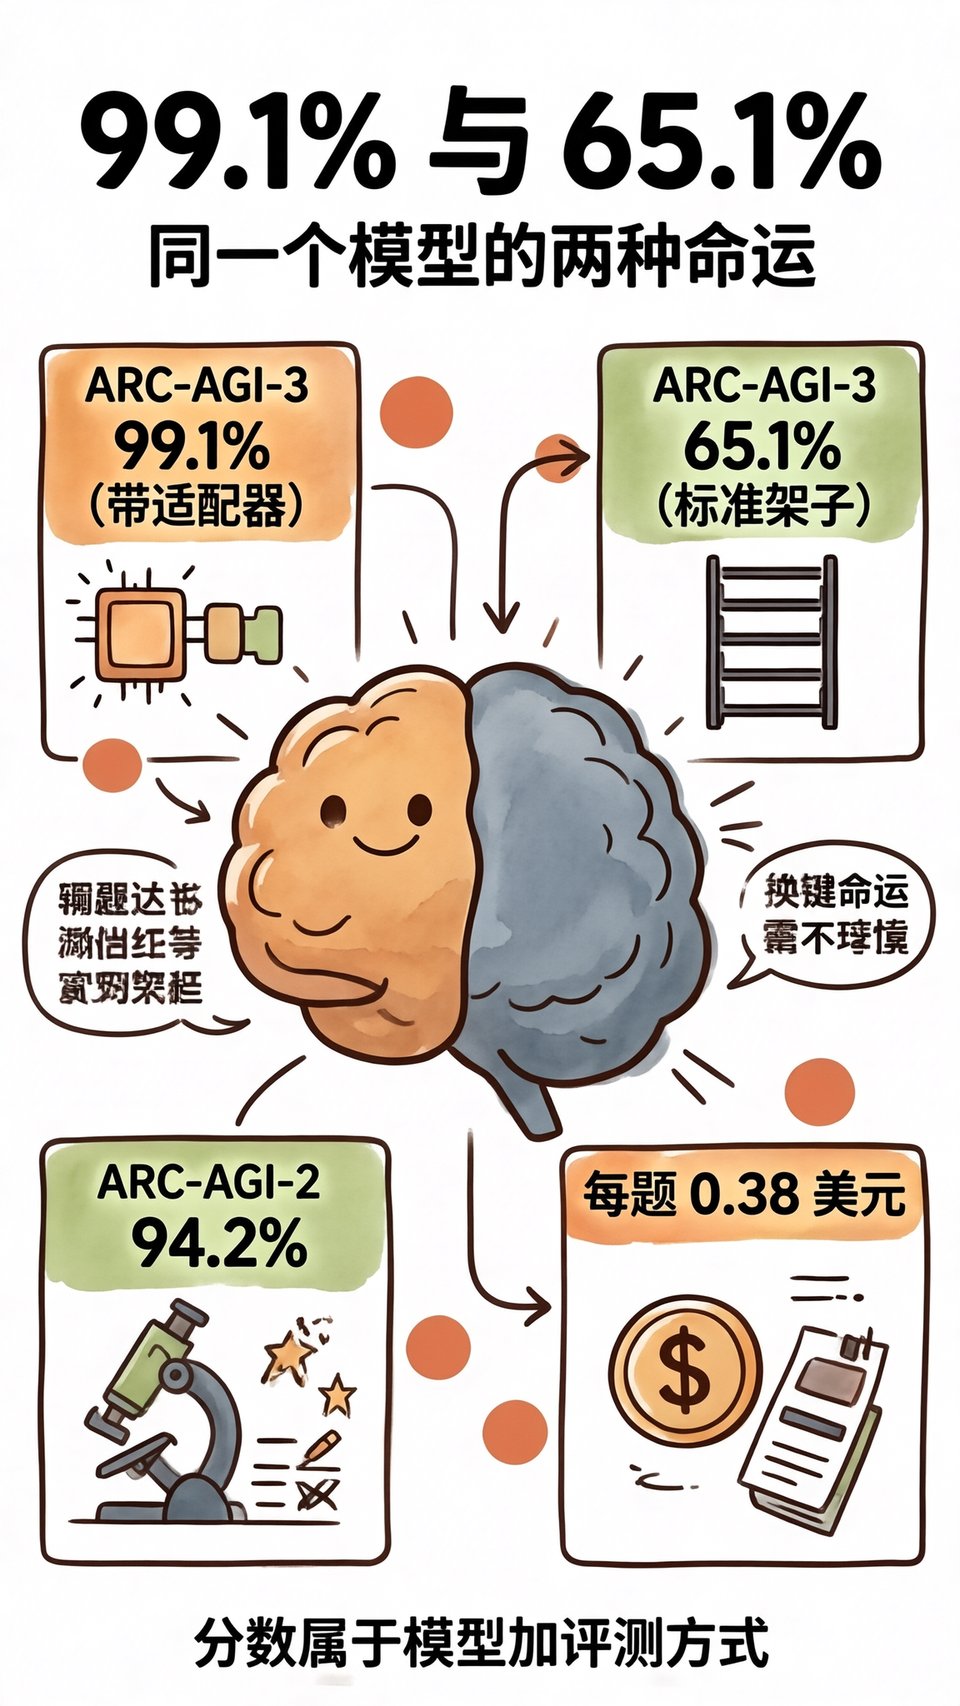
一句话:分数很高,但要看跑在什么架子上
一句话:这不是一个「模型得分」,是一个「模型加一套评测架子」的联合得分。同一份权重,换一种跑法,从 99.1% 掉到 65.1%。任何只写「某模型 99.1%」的标题,都省掉了半个事实,而省掉的那半个,恰好是花钱最多、争议最大、也最该被追问的部分。
划重点:官方同时给了两个数,两种跑法各自独立跑完。99.1% 走 provider adapter,花了 4.6 千美元;65.1% 走 standard harness,花了 7.2 千美元。花钱更少的那档分数更高,花钱更多的那档分数更低,这个反差本身就值得停下来看三秒,因为它反的是常识。
说白了,榜单上那一行不是模型的体检报告,是「模型 + 壳子 + 预算」的联合体检报告。壳子一换,报告就换一份。这不叫作弊,评测本来就没办法脱离工具谈分数;能被工具影响多少,本身就是个该公布出来的参数,公布了才谈得上可比,也才谈得上复现。
所以我读这类成绩的习惯是先看括号里的跑法,再看数字。数字是结论,括号才是条件。条件不给全的成绩,等于考试只报分数不报开卷闭卷,听着热闹,其实没法横向比,也没法判断它离人类基线还差几个身位,更难照着复现一遍,自然也不该拿它当采购依据。
同一模型,99.1% 和 65.1%,差在哪
先把 harness 说清楚:它是把题目喂给模型、把答案收回来、再判分的那一整套外部程序。提示词模板算它的一部分,允许调几次、能不能跑代码、能不能重试、超时给多久、日志留多细,全都算在里头,任何一项放宽,分数都会往上走一点。
provider adapter 是厂商自己写的适配层,通常可以接外部工具、做多轮编排、让模型自查答案再提交。standard harness 是官方统一的那套,尽量逼模型自己答,不额外递工具,也不给第二次机会,两边跑的根本不是同一场考试,比分自然也不该并排挂。
所以那 34 个百分点不是模型忽强忽弱,是「允许它借助多少外物」的差额。一个准开卷,能查资料、能试错、能回头改答案;一个只准闭卷,一次答完。分数差得离谱,逻辑一点都不离谱,这就是架子明码标价的价钱,只是价签贴得很小,小到没人愿意念出来。
这也是全篇最该记住的一句:分数不是模型的属性,是「模型 + 评测架子」的联合属性。你把架子拆了,分数跟着塌,塌多少取决于架子原先替你扛了多少。架子扛得越多,裸模型那一栏就越难看,这也是只报高分最省事的原因,省事到能省掉一整场讨论。
每道题 0.38 美元,贵不贵
成本口径得摆出来:ARC-AGI-2 上平均每道题 0.38 美元;ARC-AGI-3 走完整一轮,adapter 那档 4.6 千美元,standard 那档 7.2 千美元。这些都是 ARC Prize 公布的口径,不是按 token 单价倒推的估算,也不是挑最好看的那一次报的。
0.38 美元买一道抽象推理题,单看像一杯咖啡,甚至有点便宜。但这是平均值,题量大起来就是四位数美元,而且越往上堆重试和多轮编排,单价越飘。单题价和总额两个都得看,只挑一个,很容易得出相反的结论,比如「这么便宜随便跑」。
更值得琢磨的是那 7.2 千:分数更低,花钱更多。严格的架子不便宜,多轮、重试、完整日志、逐题留痕,每一项都在烧钱。贵不等于强,贵只说明这套跑法有多重,跟模型聪不聪明是两回事,两笔账不能记混,混了就容易被一句「更强」糊过去。
所以看成本别看总数,要看「一道题多少钱」和「这些钱换来了几分」。只报分数不报单题成本的评测,等于只报马力不报油耗,听着带劲,真要下单的时候心里没底,也没法判断便宜的那一档,钱是省在模型上还是省在架子上;这两者差得远,一个会随规模降价,一个降不下去。
ARC-AGI 到底在测什么
它测的是没见过的抽象推理题:给你几个示例,让你当场归纳规则,再套到新题上。据 ARC Prize 的说法,人类基线常在 85% 上下。它的目标一直是「没背过的题」,不是把旧题库翻新一遍,所以靠刷题攒熟练度的收益本来就有限,题外的题才是主战场。
注意它不考知识量,考的是当场归纳。所以「能不能用工具」这件事影响极大:能搜索、能试错、能自查,等于把开卷考试拿去和闭卷考比。卷子是同一张,条件已经不一样了,比分自然也不在一个量纲上,硬摆在一起比没有意义,只能说明各自条件下的上限。
这就解释了前面的落差。一套题人类在 85% 上下,模型带着工具跑到 99.1%,那这个 99.1% 衡量的多半是工具编排的水平,不只是模型肚子里那点推理。工具是它的一部分,不该算成外挂,也不算成模型的独立战功,功劳得分清,不然就变成给工具记功。
换个说法:99.1% 说明这套「模型 + 工具」的组合在 ARC-AGI-3 上确实能打,这是个真结论。但把它读成「模型本身的抽象推理超过人类」,就多读了一层材料里没有的意思,属于自己给自己加戏,加完还得自己先信,这就不好玩了。
榜单之外,普通人该关心什么
三件事。看到分数先问「什么 harness」;看到成本再问「能不能规模化」;看到榜单再问「有没有公开复现」。这次三条都有答案,结果页和复现代码都摆了出来,这点该给肯定,也是它比多数榜单实在的地方,至少你能自己跑一遍,跑不通也知道卡在哪一步。
但这里有个前提:复现的是「模型加架子」,不是「模型的聪明」。想复现 99.1%,你得连那套 adapter 一起复现;只把权重拉下来跑 standard harness,你复现到的会是 65.1%,跑法错一个字都不行,这也是复现榜单最容易被忽略的地方。
对普通用户来说,这套落差其实很有用。以后看到「某模型又破纪录」,先找括号:带没带工具、允不允许重试、一次跑多久、花了多少钱。这几个问题问完,一半的震惊标题会自动缩水,剩下的那半才值得认真读,读的时候也别忘了那是组合成绩,组合里每一件都可能被悄悄换掉。
所以真正该记的不是 99.1 这个数,而是「同一个模型能差 34 个百分点」这件事本身。它提醒你:任何单点分数背后都站着脚手架,读分数的时候,顺手把脚手架也读一遍。别只抄那个数字,抄着抄着括号就没了,只剩一个吓人的数。

