
一句话:智能体评测的重心,正从「答对多少题」挪到「能不能交出一份别人能直接用的活」。据 Artificial Analysis 公布,他们与 Google DeepMind 联合推出了新基准 MKA,全称 Multimodal Knowledge Agent,中文可译作多模态知识智能体。名字长,事情不复杂。这次不是比谁答得准,是比谁干得成、干得便宜。
说白了,就是给智能体一堆视觉上复杂的文件,让它做完一件现实里的知识工作,再看它交出来的东西能不能用、花了多少钱。Artificial Analysis 是常年做模型价格、速度、质量横向对比的独立机构,这份榜挂在他们的站点上,数字也由他们公布。下面按五个小节拆:先摆数字,再拆方法,最后讲我自己的疑问。
先划重点:质量第二,价格只有六分之一
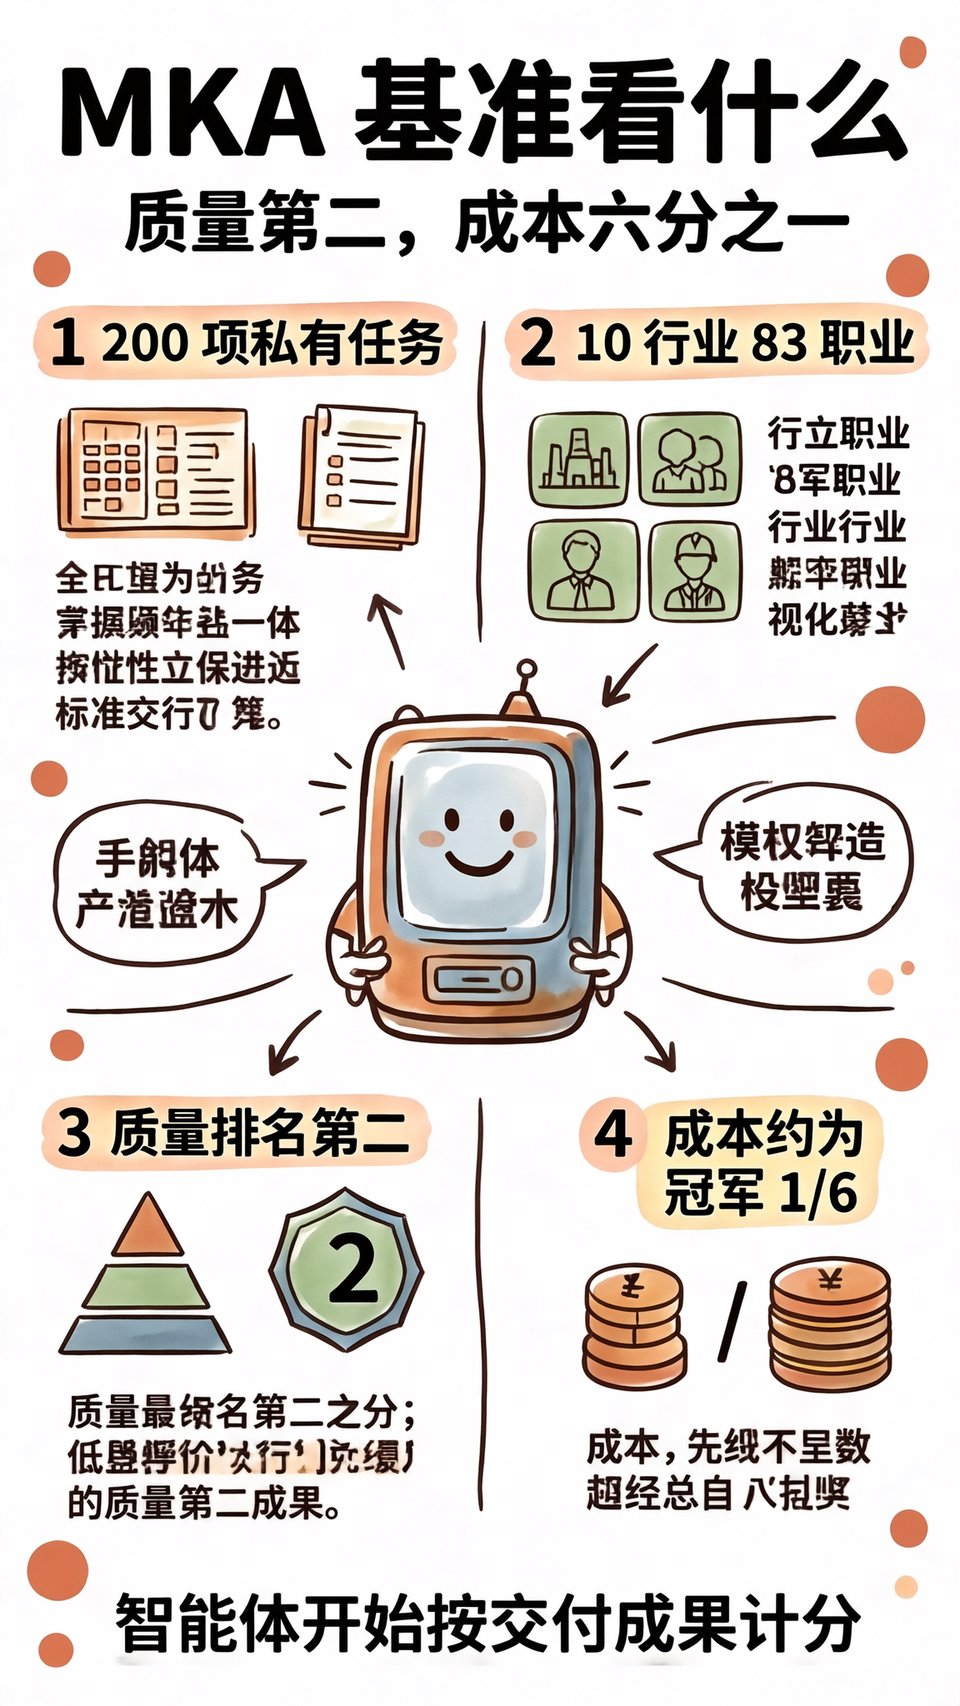
划重点:Gemini 4 Carbon 在参测模型里质量排名第二,平均任务成本约为第一名模型的六分之一。质量差一档,钱差六倍——这个组合比「又拿了个第一」值得看,因为它给的是一个取舍,而不是一个名次。名次只能贴在海报上,取舍要写进预算表。把这两句并排写,比单看任何一句都诚实。
据 Artificial Analysis 公布,MKA 含 200 项私有任务,覆盖 10 个行业、83 种职业,已经在他们的平台上上线。题面不公开,公开的是成绩、排名和每项任务的平均成本。三样凑齐,才够支撑一次采购判断:能力够不够、贵不贵、贵得值不值。题目不公开,等于把信任票交给发布方,这也是后面要追问的地方。
一句话:这是一份「交付能力乘单位成本」的联合榜单。它不问你多聪明,问你多贵。质量榜已经很挤,成本榜还空着;谁先把两个轴画进同一张图,谁就先定了叙事。这份榜的第一层意义在这里,不在名次。写榜单的人如果同时是出题人,叙事权就更集中。
所以先记住两件事:私有题决定了它防作弊,按任务算成本决定了它能指导花钱。至于排名,往后再放一放——第五节那个疑点没解开之前,名次只能当参考,不能当结论。这也是我读这类榜的默认姿势。先把框架立住,细节才有地方挂。
200 道私有题,考的是看文件干活
一句话题型:不是问答,是交付。输入是一堆视觉上复杂的文件——扫描件、表格、图表、带批注的文档;输出是一份能直接交给同事的成果,而不是一句回答。这个转向比任何单项分数都重要:问答考的是知道,交付考的是会做。
200 项任务,10 个行业,83 种职业。三个数字放一起,说明出题人刻意绕开了「程序员专属」的老路:83 种职业意味着大量非技术岗,处理的是报销单、合同条款、说明书、检测报告这类东西。这些活没人愿意干,但每天都要有人干。
这类文件有个共同点:信息不在纯文本里。表格的单位藏在表头,条款的例外写在脚注,图里的拐点要自己看出来。让模型「看一看、再算一算、再按格式写出来」,链条一长,错误就有地方藏。链条越长,越考验流程,而不是智力。
评分点也跟着变。不再是答案字符串对不对,而是成品能不能用:格式对不对、数字有没有算错、结论有没有超出材料。这一步跨过去,考的就是完整工作流——读文件、找关键信息、算数、成文,中间任何一环掉链子,成品就废。
为什么私有题库比公开榜更难作弊
公开题有个老毛病:题一旦上网,就变成了训练数据。模型不必会干活,只要见过这道题。分数涨得很快,能力涨得很少,榜单和现实就这么分家。所有公开基准最终都会撞上这堵墙,区别只是撞得早晚。这堵墙不是技术问题,是激励问题。
私有题把这条路堵住了。题面不公开,厂商拿不到,也就没法针对性喂数据。想提分只剩一条路:真的把「看文件、办事」做得更好。这也是为什么大厂愿意参测——它验的是产品力,不是记忆。记忆能刷,产品力刷不出来。
但私有题库不是免费的。它意味着外部无法复现,你只能选择相信出题方。防作弊和可验证,在这里是一对天生的矛盾,MKA 选了前者。这个选择不算错,只是要认账:公信力全靠发布方自己兜,一旦出事,没人能独立复核。
还有一层要较真:200 项摊到 83 种职业,平均每个职业不到 3 题。样本量决定了它能测出大方向,测不出细分职业的强弱。谁要是拿它证明「我的模型在财务岗更强」,那是过度解读,别跟着信。榜单的颗粒度,就是它的可信边界。
成本才是智能体的生死线
传统评测里,成本是备注;智能体评测里,成本是主项。理由很直白:一次任务要跑很多步——读文件、调工具、重试、自我核对,token 是成倍烧的。单次调用便宜,不等于一件事便宜。很多模型就输在这一步乘法上。按次计价的直觉,放到按活计价的场景里会算错。
所以「质量第二、成本六分之一」这句话得这么读:质量差一档,钱差六倍。在够用的质量线上,单位成果的价差就是六倍。同样的预算,一家做六件活,另一家做一件,选谁不必猜。这不是情怀问题,是算术问题。差的这六倍,就是自动化能不能铺开的门槛。
这也是智能体和聊天机器人的分野。聊天机器人按次收费,一次几厘钱,贵点无所谓;智能体按活收费,一份活可能几十次调用,成本直接决定这门生意做不做得成。成本从备注升成主项,是行业开始算账的信号,也是它开始落地的信号。
据 Artificial Analysis 公布,成本口径是「平均任务成本」,把所有任务的花费摊平。对长短任务混搭的基准,这个口径合理,但它藏掉了方差:个别任务可能贵十倍,而这恰恰是企业最怕的那一块。平均值好看,长尾才要命。这句话听着糙,但它决定了这份榜该怎么用。
但这里有个前提:题是谁出的
但这里有个前提:MKA 由 Google DeepMind 与 Artificial Analysis 联合发布,消息由 Philipp Schmid 在 X 上宣布。出题方之一,同时也是参测方之一。这个身份重叠不构成舞弊,但读者有权多问一句:题是为谁设计的?这句话不好听,可榜单的可信度就是这么攒起来的。
更关键的是,第一名那个模型的名字没有公布。Gemini 4 Carbon 排第二,那第一是谁?如果是别家的模型,这份榜的说服力反而更强;如果不方便说,疑问就只能一直悬着。悬着的东西,不能当结论用。一个不肯说名字的第一名,等于一份没有署名的证据。
第三方评测的公信力,建立在「出题的人不参赛」上。联合发布不等于不独立,但它确实需要更透明的交代:任务怎么设计,评分由谁执行,第一名的身份为什么隐去。这三条目前都没有答案,所以这份榜现在只能算半成品。
说白了,数字可以用,但要带着条件用:它证明了「私有题加按任务算成本」这个方向站得住,不等于证明了某一家模型的座次。下次看到智能体榜单,先问三句:题公开吗,钱算进去吗,出题的人下场了吗?MKA 答对两句,第三句还欠着。

