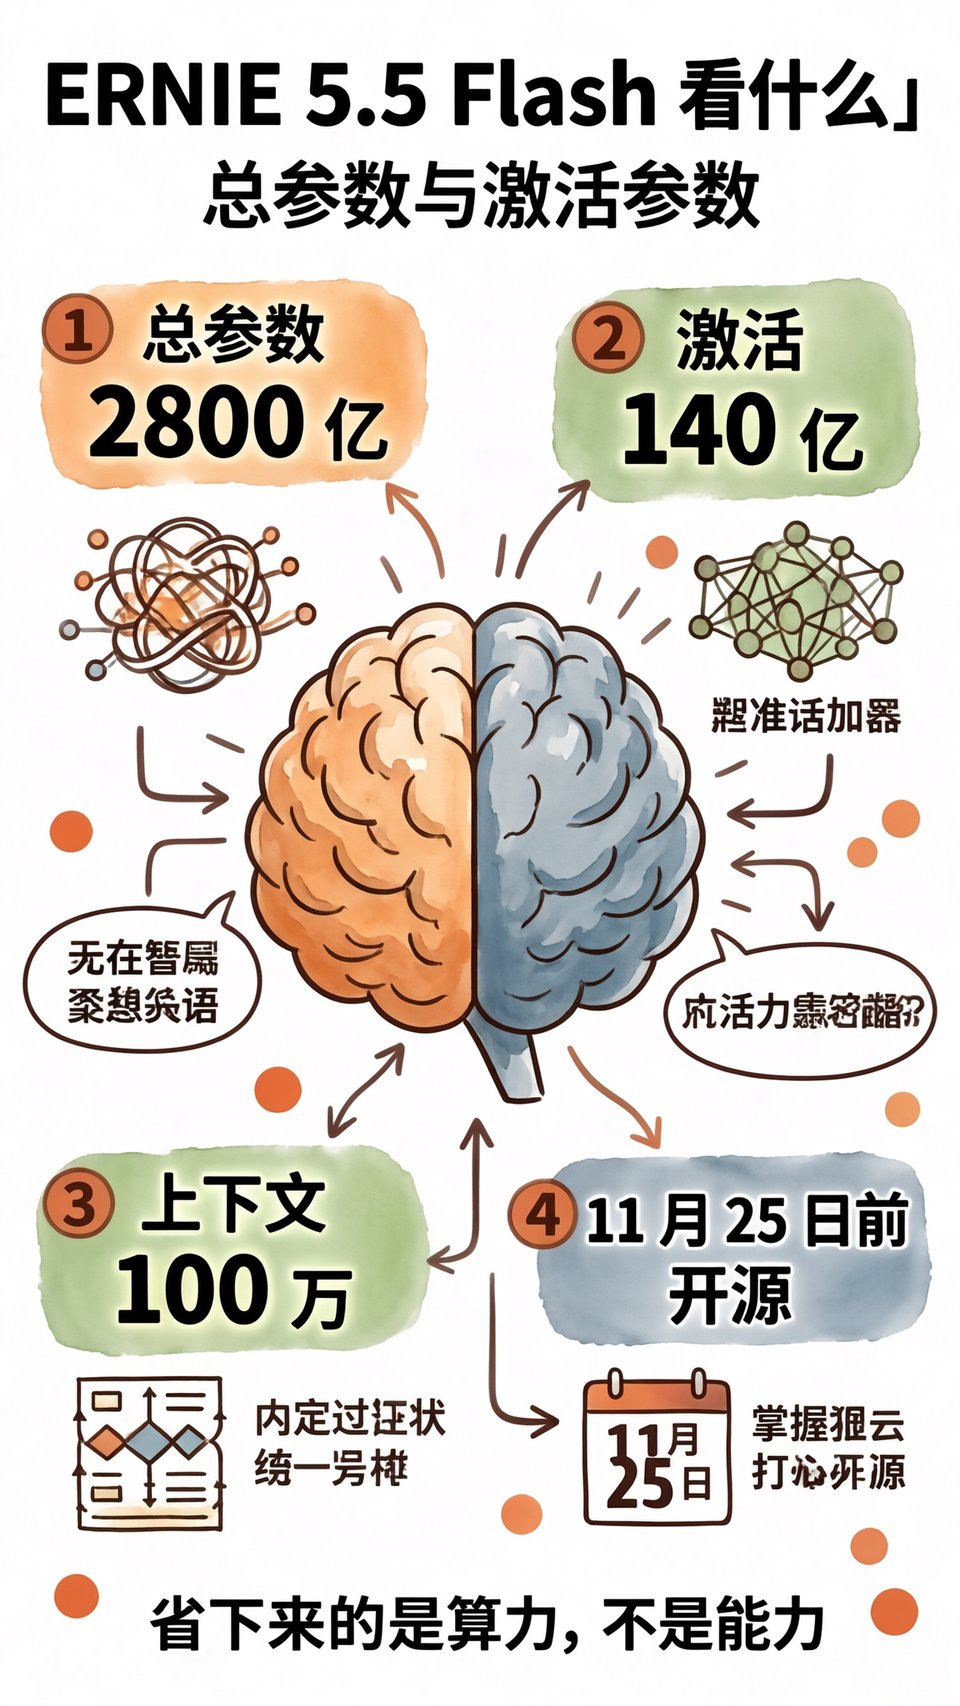
百度文心放出了 ERNIE 5.5 Flash Preview,是 ERNIE 5.5 Flash Base 的首个后训练版本。参数表挺唬人:总参数 280B,激活参数 14B,支持 1M 上下文。API 已经在千帆平台上线,权重说好 11 月 25 日前开源。四个信息挤在一段,每个都得拆。
我先把态度摆出来:这份表里真正值钱的是后半句。280B 是仓库面积,14B 是同时开工的工人数。看懂这个区别,你才知道它快在哪、省在哪,以及哪些地方可能是没说的。
这篇不复述官方新闻稿。官方展示的成果集中在游戏开发、3D 建模、知识工作、视频创作这几类 Agent 场景,图都漂亮,但演示和日常使用之间隔着一段距离,我下面会说清这段距离有多长。
还有一句先讲明:下面涉及价格和速度的推测,都建立在官方公布的数字上,我不替它补数据。演示能证明的事很少,能证伪的事很多,所以重点看它没说什么。
先说结论:参数结构比参数总量更值得看
结论先给:这颗模型的看点不在 2800 亿这个总量,而在只激活 140 亿这个结构。MoE 的做法是把参数拆成很多小块,每次推理只叫醒其中几块干活。参数总量更像知识仓库的面积,激活量才是它一次动手的力气,买的是仓库,用的是力气,两笔账别混着算。
好处直接落在账单上。显存得装下 280B,算力只花 14B 那一份,响应快、单次推理成本低,是这条路线最实在的收益。但反过来说,服务器该占的坑一个不少,部署成本不会因为激活参数小而跟着缩水。省下的是电费和等待时间,不是机柜。
我的判断是:这是一套为高并发、短对话、Agent 反复调用准备的省钱方案,不是为一次想清楚一件大事准备的。官方表示它在编程、3D 建模、知识工作、内容创作等方面有竞争力,还保持较快解码速度。这句话得拆开看,竞争力的参照系是谁,有没有公开的基准和分数,都没写。
另一句判断:Preview 这个词比任何参数都重要。预发布意味着能力上限还在动,你今天测出的分数、调好的提示词,下个月可能就作废。版本号后面挂着 Preview,本质上是一张免责声明,想接进生产环境的人得先接受这点。
280B 总参数,只激活 14B 是什么意思
打个比方。280B 像仓库里堆着 2800 亿个柜子,14B 是同时只打开 140 亿个柜子取货。总容量决定它能装多少知识,同时打开的柜子数决定它一次能多快、多便宜地把东西取出来。听懂这个比方,参数表就不用再看了,剩下的多是包装。
换成具体场景更清楚。让它写一段商品文案、回一封邮件、改一个函数,14B 的激活量绰绰有余,回应会很快,成本也压得住。让它一口气读懂一份带图表的年报,压力就转到上下文和路由策略上,这两处才是它的天花板。
MoE 的老毛病也在这里。路由没选对,该叫醒的专家没叫醒,输出就会飘,而且飘得没有规律。这类问题在长尾题目上比在常规题上更容易露出来,官方这次没提专家数量、路由方式和负载均衡的细节,只给了总参数和激活参数,剩下的要等开源看配置文件。
所以我的看法是:14B 激活是它的性格底色。你把它当便宜快速的小模型用,会满意;把它当 280B 大模型用,大概率会失望。市面上不少争论,其实都是拿仓库面积去衡量开工力气,方向从一开始就歪了。
1M 上下文,实际能用到多少
1M 上下文听着像能一口吞下一整排小说。但上下文长度和上下文质量是两回事,能塞进去,不等于能记住、能用对。窗口大小是门槛,能不能稳住是本事,这两件事参数表分不出来。长窗口的承诺和长窗口的表现,从来不是同一个指标。
常见现象是中间塌陷:开头和结尾的信息抓得牢,中间一大段容易糊。参数表不会告诉你这件事,只有自己把一份长文档丢进去问细节,才看得出来。测法很简单,在文档前段、中段、后段各埋一个只有那处才有的细节,逐一问它。
还有计费。1M 上下文如果按输入长度计价,一次长文档问答的钱可能比好几次短对话加起来还贵,具体怎么算,官方没说。上下文越长,缓存和显存压力越大,速度和价格都会往下走,这是所有长窗口模型的共同代价,没有例外。
我的判断:先按能稳稳处理一部长文档的心态去用它,把 1M 当余量而不是常态。真要拿它跑超长文档,自己搭一套小测试,比看发布会上的演示靠谱得多,也便宜得多。测试不用复杂,三份你手头的真实文档就够。
官方没说清的三件事
第一件,开源开的是什么。官方口径是权重于 11 月 25 日前开源,可开的是 Preview 还是 Base、许可证怎么定、能不能商用,一个字都没写。这三个问题才决定它对你有没有用,也决定它能不能进公司项目,比参数重要得多。
第二件,1M 上下文的真实表现和计价方式。有效长度多少、超长输入怎么截断、长文本怎么收费,这些是成本的大头,目前没有公开说明。发布会讲了能读多长,没讲读长了要多花多少钱,后者才是你付账时看到的数字。
第三件,那个有竞争力是和谁比。官方表示它在编程、3D 建模、知识工作、内容创作方面有竞争力,没给基准测试的对手、分数和测试条件。没有对照的有竞争力,约等于没说,任何新模型都可以这么形容自己。
它和当前默认聊天的差距,也不在纸面参数,在确定性。默认那几个聊天模型,你大致知道它答错了是哪种错法,知道哪类问题该换人问;一个刚出的 Preview,你还不知道它的脾气,这需要时间来摸。短期里它是备选,不是替代品。
普通人现在能用上什么
眼下能做的只有一件事:去千帆平台申请 API 试。权重还没放出来,本地部署这条路要等到 11 月 25 日前后才有答案,而且还得看许可证怎么写。想先把它跑在自己机器上的人,这几天可以先按兵不动。
试的时候别只看它会不会写诗。挑你手上真实的三件活:一段代码、一份表格整理、一段 3D 素材的描述,看它一次能不能过。过不了,参数再大也和你无关;能过,再谈贵不贵。这一关过了,再去想接进流程。
成本要自己算。记下每次的输入输出长度和实际扣费,换算成每完成一件事多少钱,这比盯着单价有用。Agent 场景尤其如此,一次任务可能连着调用很多轮,单次便宜不代表整件事便宜,账要按任务结。
我的判断:现在不值得为它改工作流,值得花半小时摸个底。等开源落地、许可证明确、长上下文表现有人复现,再决定要不要把它放进日常。工具的取舍从来不看发布会有多热闹,只看它能不能替你省下时间。

