
把五个大模型的道德判断摆在一起取平均,你得到的是「五个模型的共识」,还是一个根本不存在的家伙?这篇论文的答案是后者。先别急着说「AI 不懂道德」——它懂,只是每次懂的方式都不一样;你以为在量同一件东西,其实只量到一把会伸缩的尺子。
论文的核心武器是两个老工具:成对比较管「问什么」,next-token 概率管「怎么听」。工具旧得能进博物馆,测出来的东西却很新——模型的道德排序会随问法漂移,幅度足以掀翻一张排行榜,而且掀翻得毫无自觉,没人察觉,除了这份报告;换份系统提示词,它就从严师变和事佬。
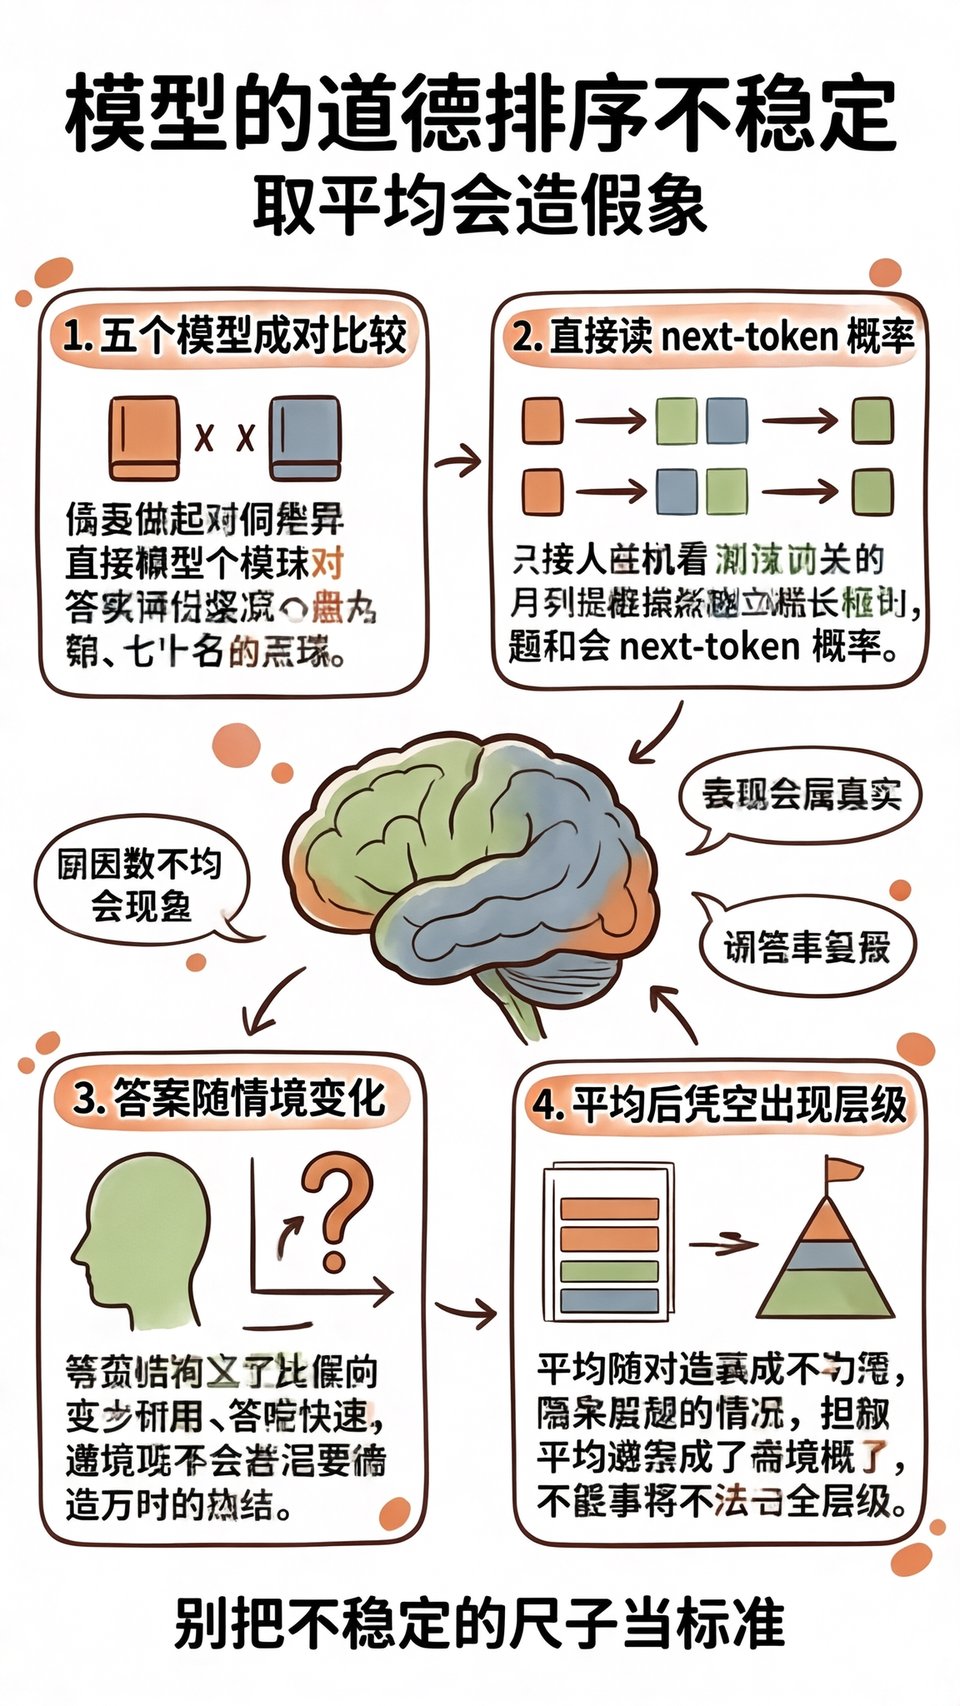
一句话:它们没有稳定的道德排序
一句话:研究者让 GPT-5.2、Gemini、DeepSeek 等 5 个大模型,对成对的道德违规行为做比较,判断哪个更不能容忍;随后不从模型嘴里要分数,而是直接读它生成下一个 token 时的概率。结论是:排序不稳定,换个说法就可能翻盘,连榜首都能换人。
强调一遍,关键是「不稳定」,不是「随机」。随机是均匀地没准头,同一问法下答案像掷骰子;不稳定指的是答案其实很有「性格」,只是这份性格认措辞、认顺序、认上下文,换身衣服就换套价值观。它不缺好恶,缺的是固定的好恶。
说白了,换成人也一样。让真人给「背信弃义」和「见死不救」分别打分,分数会跟着语气、顺序乱飘;让人二选一,多数人反而答得干脆。模型连这份干脆都保持不住:正着问、反着问,赢家就换人,而且换得理直气壮;你让它排座次,它排得出来,换个说法再问,座次整份重排。
所以结论不是「AI 没有道德」,而是:AI 的道德没有固定坐标系。它不是善恶不分,是坐标轴本身在动,动得还挺勤快,取决于你怎么问。这句话值得抄成便利贴,贴在公司所有用模型打分的表格旁边,比贴「拥抱变化」实在;毕竟一张贴纸治不了会晃的尺子。
成对比较怎么测出不稳定
方法拆开看,核心就两步。拼出一堆成对违规行为,比如「泄露用户隐私」对「故意拖延交付」,让模型二选一,哪个更恶劣;然后不看它嘴上报的数,盯住生成下一个 token 时的概率分布——倾向哪边,概率会说真话,装不了镇定,也演不出「我刚才是随口一说」。
划重点:第二步才是精髓。直接问分数,模型会报一个听起来很确定的数字,像真有立场;分值表还自带锚定效应,把两道题换个顺序,分数跟着换。换成配对比较加概率读数,你看到的才是它真实又犹豫的相对倾向:勉强胜出,或者来回摇摆。这两个读数的差别,正是「嘴」和「心」的差别。
说白了,这正是心理学和计量里常用的偏好测量手法:Thurstone 式配对比较。心理物理学家 Thurstone 上个世纪初就发现,问人「哪个更响」比问「响多少」可靠得多。人不会打分,只会比大小,那就别让他打分,让他比。市调、选品、选举偏好,都靠这套吃饭,连手机里的推荐算法也在偷偷用。
但人的配对偏好大致稳定,模型的会漂移。同一个违规行为,正面措辞问一遍、负面措辞再问一遍,相对胜率能整个反过来。人至少有个大致固定的排序,它连这个都没有。翻译一下:模型对「谁更坏」没有立场,只有语境;换一段语境,它就换一副脾气。
取平均为什么是个陷阱
看到这里,一个直觉会冒出来:单次答案不稳定,多问几遍取平均,总该稳了吧?论文说,这是全篇最危险的一个直觉。平均能抵消噪声,前提是噪声对称地分布在真值周围——物理测量里成立,道德判断里不成立,因为模型错得并不对称,它有方向,不是抖动;抖动能修,偏斜得先找到歪在哪儿。
平均还藏着另一层假设:不同场景下的「坏」可以互相换算。道德判断恰恰不能换算——见死不救和背信弃义不是一个单位,约不了分。把不可比的东西强行平均,就凭空造出一个层级:一个模型自己都不认识的价值体系,却被当成它的「价值观」写进报告。
对没有坐标系的答案取平均,得到的不是共识,是化了妆的噪声。噪声化完妆,看着还挺体面。
而这个陷阱,正好是评测报告、AI 对齐、招聘筛选最爱干的事。给模型发一堆道德题,求均值,排出「最有道德感的模型」;用模型筛简历、评候选人,把输出当稳定的人格标签。尺子本身在晃,读数却煞有介事地精确到小数点,而按平均值排出的名次,最像那么回事。
这对 AI 价值观对齐意味着什么
对齐的本质,是把模型的价值判断校准到某个方向。这篇论文戳的正是软肋:模型没有稳定排序,你校准的靶子就在动。打靶要先保证靶子不动,这个前提被默认了太多次,偏偏它不成立;靶子一动,越努力越偏。
对齐工作的真正敌人不是模型「坏」,而是模型「散」。一个排序随措辞漂移的模型,你都不知道该把它往哪个方向拉;拉之前得先知道它站在哪儿,而它拒绝站住,站住了也会挪,挪完还坚称自己没动过。
更麻烦的是,评测本身会制造幻觉。分数榜上的「价值观排名」,很可能只是把一堆情境化答案平均后得到的合成人格:一个从不存在的模型,看起来却无比真实。榜单越精确,越像在给不存在的东西量尺寸,量出来的尺寸还会被当成行业标准引用。
注意,这不是说大模型是张白纸。它有倾向,只是倾向高度依赖上下文,像一把没有刻度的尺子:当场比两件东西的长短,绰绰有余;想把它放进坐标系,门都没有。它连「标准」两个字都理解成「当下的平均看法」。
别让模型替你回答道德题
对企业的启示就一句话:拿模型的道德输出去支撑决策,等于拿一把会晃的尺子量工程精度。晃动不是故障,是这种工具的出厂设置;不把晃动算进工艺里的判断,迟早要返工,返工单上还写着「AI 优化」,仿佛锅另有其人。这里没有谁想害你,只是工具本身没长刻度。
招聘筛选、客服仲裁、内容审核,凡是把模型输出当「结论」落地的场景,都值得先问一句:这个结论对措辞敏感吗?换个问法还成立吗?不成立,你手里握着的就不是结论,是情境——拿情境当结论,锅只能自己背。
模型可以当陪练,不该当裁判。它的价值是逼你把道德问题想得更清楚,而不是替你把答案定下来;把道德判断题交给一个没有坐标系的选手,这本身就该是一道题,一道它答不稳、你必须想清楚的题,想清楚之后,答案还得你自己签字。
但这里有个前提:论文读的是成对比较和 next-token 概率,换任务、换模型、换提示词,具体数字会变。方法的方向立得住,「你家的模型有多不稳」这个数,各家未必认账,评测榜也未必敢复现——毕竟,谁愿意承认自己家的道德尺子是歪的?

