车间里,一双手在拧螺丝。拧紧、松开、换一个位置、再拧紧。这样的动作一天里要重复几百遍,没有人会为它按下录制键。
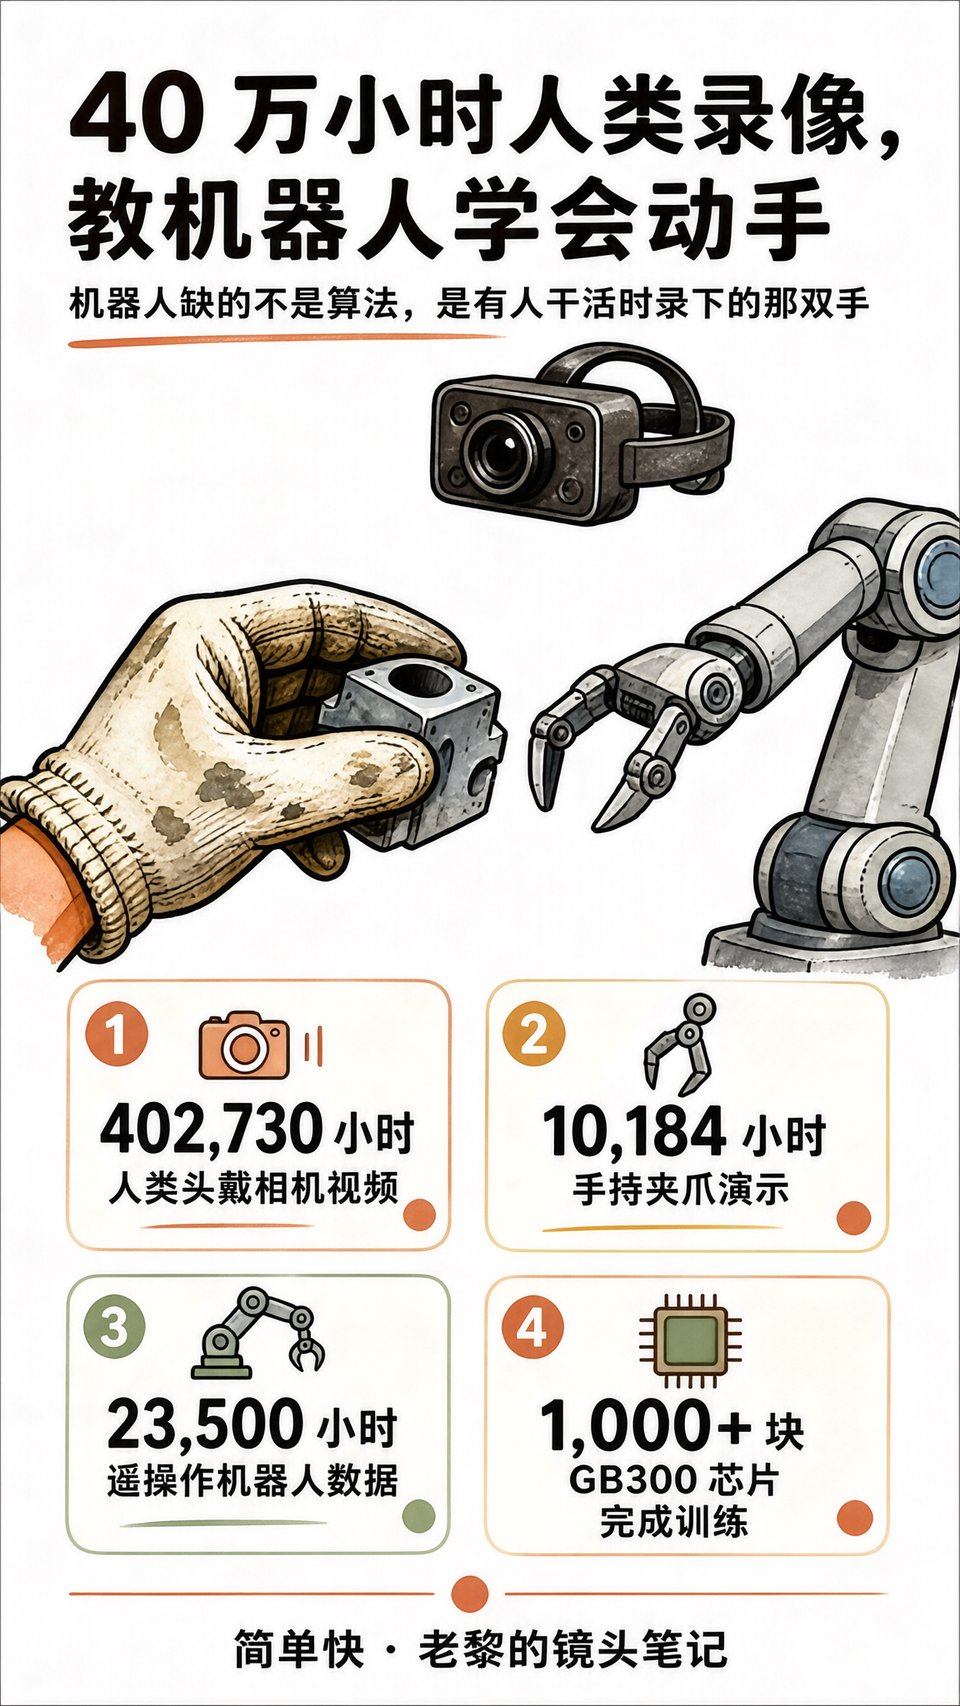
可正是这些没人当回事的重复,成了机器人今天最缺的教材。NVIDIA 发布的基础模型 GR00T 2,用了 402,730 小时人类头戴相机视频去学动作。我的判断是:这一轮机器人往前挪的一步,关键不在算法,在“人的录像”这种新原料。
一双手的四十万小时
402,730 小时是什么概念?一个人不睡不休地看,要看四十多年。这些画面不是电影,不是直播,是有人戴着头戴相机,在车间、仓库、厨房里干活时顺手录下的第一视角。
镜头里多半没有戏剧性。手伸进去,拿起一个零件,转个角度,放进卡槽。指甲盖上有油污,袖口蹭到台面,手指在犹豫的那半秒里微微停住。人动作里的笨和稳,都藏在这些地方。
机器人缺的从来不是力气,是这种琐碎。它得知道手指在哪一刻松开,而不是只知道“抓起一个物体”。四十万小时的意义,在于它足够啰嗦。
这些画面里绝大多数,在拍摄者自己看来毫无价值:一次没抓住,一次放歪了,一次手抖。价值是后来才被人算出来的。
谁在戴着头戴相机上班
录像不会自己长出来。得有人在上班时头上多戴一个东西,还得让它一直开着。数据来自真实的劳动现场:工厂、仓储、家庭服务,以及各种要靠手完成的工序。
除了头戴视频,GR00T 2 还用了 10,184 小时手持夹爪演示。人握着带夹爪的手柄,像用自己的手一样去抓,机器记下每个关节的角度变化。这种数据更贴近机器,场景却更窄。
所以这批数据是分层的:最像人的那部分最多,最像机器的那部分最少。而过去很多年的研究路径,一直反过来。
一个人一天的工作,被切成几万个能回放的瞬间。它不再是“老师傅的经验”,而是能被统计、被切片、被反复调出来比对的东西。这一步跨过去,手感才开始有形状。
遥操作录像为什么那么贵
从前教机器人,主流办法是遥操作——人拿着控制器,一步一步带机器人做动作。GR00T 2 的训练里,这类数据只有 23,500 小时,不到头戴视频的十分之一。
不是不想多录。遥操作要一个人、一台机器、一段时间,一对一地耗着。人停手,录制就停;机器坏了,数据就断。成本按小时算,产量按人算。
头戴视频的成本却接近“顺手”。人在干活,相机在录,一份劳动出两份东西:产品,还有数据。这是它能在数量上压过遥操作的原因。
我在车间里见过这样的场面:一个人守着两台设备,一下午只做出几十次有效动作。这样的产出节奏,喂不饱一个要练手的模型。
机器人学的是动作,还是习惯
这是我看到这些数字后最想问的一句。四十万小时里,很多动作并不是最优解:有人习惯先转半圈,有人喜欢用左手扶一下,有人明知有更快的路径,还是照老办法来。
机器学下去,学到的可能不是“正确的手”,而是“这一群人的手”。它会把某个车间的习惯,当成整个世界的规律。
这不一定坏。人的动作里本来堆着大量被验证过的经验,那些看着多余的小动作,常常是在避坑。可要是数据只来自一种产线、一种工种,机器人学到的就是偏科的手。
判断:数据规模决定它会不会干,数据来源决定它像不像人。后一件更难补。
先想后做,比一个大模型更管用
同样的道理,在另一组实验里摆得很清楚。MBZUAI 基础模型研究所的开放世界模型 PAN 2,先用语言模型做规划,再由 29B 的扩散模型把动作的后果渲染成一小段视频。
把语言模型拿掉,只留渲染,多步任务里只有 8.7% 的步骤是对的,计划根本走不完。两者配合,步骤正确率 75.1%,完整完成 34.0%。
数字不算漂亮,方向很硬:先想,后做。单一大模型再大,也替不掉一个“先规划再执行”的结构。
GR00T 2 的世界动作模型是同一个路数——它同时预测下一步动作和未来一小段视频。伸手之前先“看见”结果,和人抬手前那半秒的预演,是一回事。
新原料在产线上
算法是公开的,论文会发,权重会放出来。真正难复制的是那四十万小时。
我判断,找这种数据、把它攒成规模,会慢慢变成一门比调模型更值钱的营生。过去我们说“得数据者得先手”,多少带点空想;这回,产线和录像摆在一起,看得见。
要拿到这种数据,得有真实的生产场景,有愿意配合的工人,有能一直录下去的管理流程,还得有处理海量第一视角视频的算力——GR00T 2 的训练用了一千多块 GB300 芯片,据 Rohan Paul 转述、The Decoder 报道。
位置因此变了:谁有产线,谁就有数据;谁有数据,谁的手就更像人。这比谁家模型参数多,现实得多。
回到那双手
回到开头那个车间。那双手还在拧螺丝,还在重复,还是没人给它录像。
区别是,现在有人开始在意它了。不是因为它值得被拍成电影,而是因为它身上那些说不清的熟练,恰好是机器最难学走的东西。
四十万小时听着像个大数字。拆开看,就是一双手一双手,在各自的工位上,把同一件事做了一遍又一遍。机器人要学的从来不是“手”,是手背后那些年。

