先说结论:这类端到端实时音视频模型,真正值钱的地方不是「听得懂」,而是它开始会抢话——在你还没开口的时候,先把画面里那个不对劲的地方指出来。做语音助手、陪伴类应用、带摄像头的智能硬件的,值得马上试;只想把会议录音转成文字、或者只做文本问答的,这套东西对你几乎没有增量。
11 月 19 日,火山引擎把 SeedRealtime 1.0 的 API 全量放出来。我把官方文档来来回回翻了几遍,按接入示例拉了个 demo,装在客厅那台吃灰的旧平板上,断断续续试了两天,中间还翻了一次车。
以前是几个人接力,现在是一个人全程跟
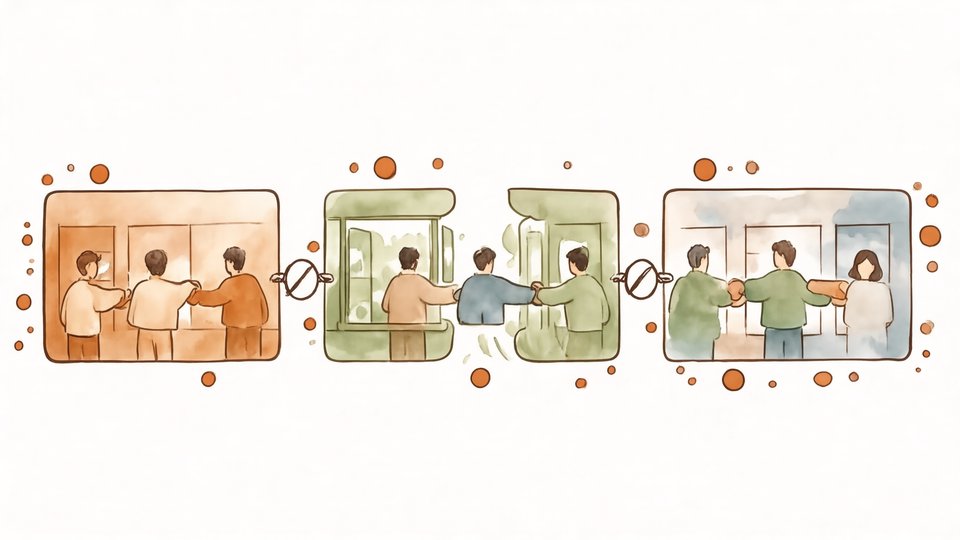
传统方案是把活儿拆开干:ASR 负责听,VLM 负责看图,TTS 负责把字念出来,几个模块串成一条流水线。每过一道手,延迟就叠一层,信息也损耗一层——你说话时的语气、画面里刚发生的那点变化,传到下一环往往已经变形了。
SeedRealtime 换了个思路,把声音、画面、时序、表达塞进同一个端到端模型,在一条连续的多模态信息流上跑。它不等你把问题问完整才开始想,而是持续跟着场景走,自己判断什么时候该接话、什么时候该闭嘴。
官方给的场景都很生活化:多人聚餐时能分清谁在跟它说话,顺手把旅行方案按人定制;看到整颗咖啡豆被倒进手柄,会提醒你先研磨;学习画面翻到指定章节,会主动把学习率、动量、权重衰减报出来。机场那个例子更能说明问题——过滤掉旁人闲聊,抬头看大屏航班信息作答,再认出指示牌给你指路。
我拉了个 demo,放在客厅的旧平板上
接入走的是 WebSocket,音频仍旧 20 毫秒一个包往上推,视频帧最多 2 FPS。我把平板架在茶几上对着客厅,第一个问题问得很笨:桌上那个杯子在哪。它没有把杯子当成一个孤立物体,而是连着我放下杯子的动作一起看了,回答里带着「刚放下的那个」。
第二个测试更接近真实用法。我说「把它挪到左边」,它接住了前一句的指代,知道「它」是杯子,不是旁边的遥控器。同音词也没那么容易带偏,因为它有画面兜底。官方口径是相比级联模型,对话节奏问题少了一半,一次对话完整顺畅聊完的概率明显提升——具体数字我没法验证,但体感上确实比去年那批语音助手顺得多,不用反复「你再说一遍」。
多人场景我挑了最难的版本:电视开着,两个人在旁边聊天,我插进去跟它说话。它没有被背景闲聊勾走,也没把电视里的台词当成我的提问。官方举的机场例子是过滤无关闲聊、看大屏答航班,我这儿没有机场,但客厅这点嘈杂算是同一道题的折扣版。
2 FPS 这件事,得说清楚它限制了什么
官方文档写得很不客气:客户端推视频帧最多 2 FPS,不可调,超了直接丢帧,而且不按帧数计费。拆开看有两层意思——一秒只来两张,它看到的是「场景变化」,不是你手指的精细动作。
所以指望它盯着你拧螺丝、跟踪手势轨迹、判断你翻书翻到了第几行,是不现实的,这是物理上的不够看。它真正擅长的是「桌上多了一杯水」「人从站着变成坐下」「屏幕上的页面换了」这种量级的变化。做产品的时候,镜头该给全景和场面,别怼特写。
它开始抢话,这事儿好坏参半
主动开口是这个模型最不一样的地方。它不是等你问了才答,而是觉得该说就说。放在陪伴类和智能硬件里,这是拟人感最直接的来源;放在需要精确控制的流程里,这就是风险源。
所以客服、会议、任何要求模型别乱插嘴的场合,你得自己配开关和阈值,别指望默认行为刚好合你的流程。文档里还有个容易被忽略的变化:打断机制换了,旧版客户端主动 cancel 那套已经废弃,改成服务端 VAD 检测后下发 response.canceled;播放状态只看 response 事件,ASR 事件跟状态机解耦。看着琐碎,本质是把「谁来决定开口」从客户端交回给了服务端。
适合谁、不适合谁
适合的:语音助手、智能硬件、陪伴式应用,以及实时客服里那段需要「先看懂场面」的环节。不适合的:纯录音转写、纯文本问答、任何要求模型保持绝对安静的流程。还有一类要谨慎——如果你的画面信息本身很稀疏,比如只拍一张桌子,那 2 FPS 的代价你付了,收益却拿不到。
我的判断是,别把它当成一个更聪明的语音助手,它更像一个坐在你旁边、眼睛一直睁着的人。价格和配额我不在这儿瞎猜,以官方页面为准。真正该先想清楚的是:你的场景需要它看「场面」,还是需要它看「动作」——想明白这一条,再决定要不要接。

