一句话:它没训练机器人,也没做专门的视觉-动作模型,而是把语言模型当操作员——模型看相机画面、调用工具,工具在机器人上执行,模型再挑下一步。
11 月 18 日,UCSD Hao AI Lab 把这套叫 ORA v0.1 的框架开源了,GitHub 同名仓库 fast-rua/ORA,许可证是 Apache-2.0。门槛被压低的点就在这儿:不炼丹,换接口。
说白了,原来要一个专门的 VLA 模型,端到端学「看画面出动作」;现在换成通用语言模型加一套手写工具。模型不负责出力,只负责选。
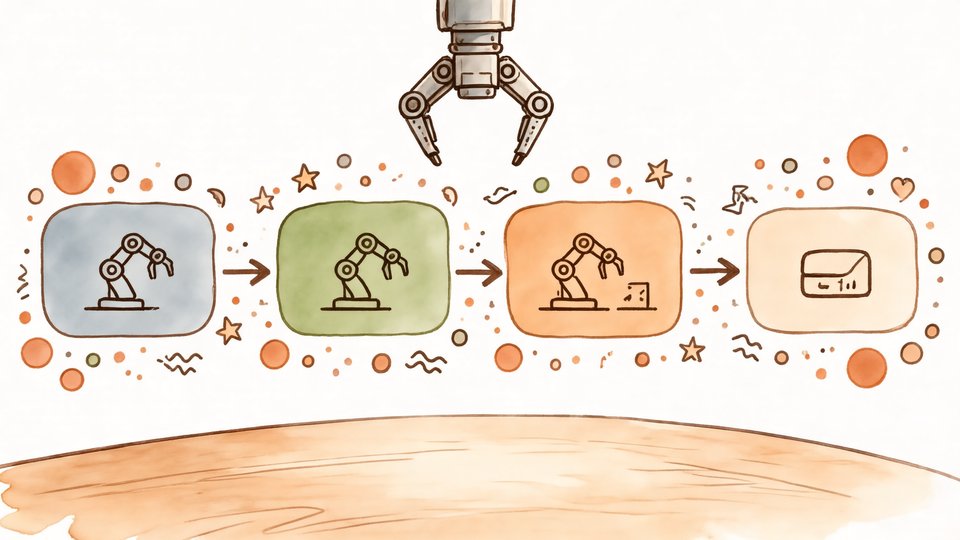
它怎么转起来:模型看画面,工具去动手
循环很短。相机拍到一帧,模型拿到画面和当前任务,挑一个工具:夹爪开合、机械臂移到某点、按下按钮。工具在真机上执行完,新画面回到模型眼前。
据作者描述,模型每一轮只做一件事——决定下一步,然后等结果。它的智力不花在算关节角度上,花在「看懂现在发生了什么、下一个该干嘛」上。
划重点:这套设计把「机器人策略」和「通用推理」拆开了。推理交给模型,精度交给底层控制器。模型不需要会逆运动学,只需要会判断现在该抓还是该推。
为什么能这么干?因为这类「调工具」的活,语言模型在写代码、调接口上早就练熟了。把它换个执行端,从改文件、查网页换成移手臂、开夹爪,只要接口规整就能跑。
代码模式强在哪:瓶颈是往返次数
旧式工具调用,模型一次只能发一个动作,等机器人执行完、画面刷新,再发下一个。一次动作一次往返,中间全在等机器。
ORA v0.1 换了个玩法:每轮让模型写一段 Python 程序,一次调用同一批工具,一轮最多带 12 个动作。实测同一个回合平均带 3.6 个机器人动作,旧式工具调用只有 1.1 个。
说白了,3.6 对 1.1,差的不是模型变聪明了,是浪费在往返上的时间变少了。一段程序能表达「先过去、再对准、再夹住、再抬起来」这种序列,一次一个的工具调用只能挤牙膏——瓶颈通常在往返次数,不在智力。
成绩单:RoboDojo 那一跳
动作规划是第二处升级:集成 cuRobo,按深度相机建的地图给每一步算路径。因碰撞而中止的动作,RoboDojo 从 14.1% 降到 7.0%,RoboTwin 从 18.4% 降到 6.8%。
成绩单用的是 DeepSeek-V4.1-Flash,零样本、一次机会:RoboDojo 从 10 月预览版的 5.2% 升到 39.9%;RoboTwin 从 71.5% 升到 79.6%;LIBERO-Pro 87.5%;RoboLab 79.2%。
钱也得算。按 DeepSeek 低峰 API 价估,平均每个成功任务 0.13 美元;按基准用例算、含失败重试,约 0.30 到 0.35 美元一个成功用例,不含 GPU 与仿真开销。
哪些数字不能横着比
RoboDojo 那一跳是七倍多,说明 10 月预览版确实差;RoboTwin 只涨 8 个点,说明底子本来就不低。同一个模型、不同基准,涨幅差这么远,本身就有信息。
这提醒一件事:零样本跑新基准,分数低不一定是方法差,可能是任务分布离模型见过的更远。RoboDojo 起点 5.2%,那个环境对「语言模型加工具」这套组合不友好;RoboTwin 起点 71.5%,已经踩在舒适区里。
成本同理。0.13 美元只算成功的那些任务,0.30 到 0.35 才把失败重试摊进去,还不含算力和仿真。拿 0.13 去跟别的方案对账,账本身就算错了。
还有个细节值得抠:12 个动作是上限,实际平均只带 3.6 个。上限的存在说明每轮写出来的程序长短不一,短的三五个动作,长的一口气十来个,全靠模型自己判断这个活要几步。
作者自己写下的那串限制
这一节全是作者自己列的,不是我加的。一回合中位数 14 到 25 分钟,大部分时间在等模型思考;仿真在模型思考时暂停,所以这些数字说明不了实时控制。暂停的意思是机器人在这二十来分钟里是冻结的,现实里没人等你这么久。
工具集是手写的,ORA 还不能自己迭代工具。绝大多数结果来自仿真和一个模型;真机上只演示过两次,每次动作还要人工批准。
判据也有水分。用的是基准自带的成功判据,有些比指令宽松,比如「摇晃瓶子」只检查瓶子被抬起来。作者逐条回看 46 个成功回合,发现 7 个其实没做到指令要求。
46 个里 7 个,差不多每 6 个成功就有 1 个是判据放水。判据松一点,分数就虚一点,这不是造假,是复用别人基准时的常见毛病——这个比例是作者自己写出来的,比任何一句「效果惊艳」都值得记住。
但这里有个前提:仿真里的分数不算数
前提有三条,缺一条结论就得打折。头一条是时间:14 到 25 分钟一回合,机器人中途是停着的;它更像「想好了再动」,不是实时控制。
第二条是场景。绝大多数分数来自仿真,真机只跑过两次。仿真里没有摩擦力漂移、没有光照突变、没有线缆缠住夹爪,这些到了真机上全是事。
第三条是泛化。结果全来自一个模型、一套手写工具、一套判据。换个模型、换台机器人,这串数字没有理由原地复现,代码模式在别的模型上管不管用也得另测。
所以别把它读成「机器人通用智能来了」。它更像一次接口实验:通用模型加手写工具、加代码模式、加路径规划,在仿真里跑出一个不丢人的分数。这条路能不能走到真机、走到实时,作者自己也没给答案——这就是它现在还只是 v0.1 的原因。