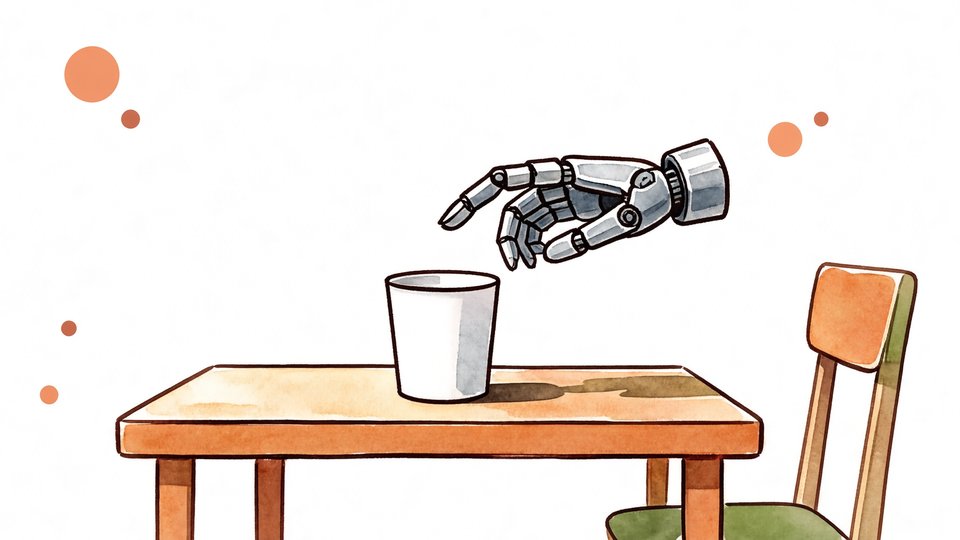
把画面停在这一帧:一只机械手从桌面抬起,缓缓伸向半米外的纸杯。镜头能看清杯口的椭圆,却读不出那个椭圆离指尖是四十厘米还是八十厘米。对一台要干活的机器人来说,这一帧里藏着两个绕不开的问题——我在哪,它离我多远。2026 年 11 月 18 日,地平线在北京发布了一个叫 LoFT 的模型,想替这类问题打地基。
一台机器人伸手之前,得先量一次距离
人伸手拿杯子,几乎不用想。眼睛扫过桌面,手腕自动调好角度和力度,误差落在几厘米内。这套动作背后是几十年长出来的空间感:桌子多高,杯子多大,手臂伸出去会先碰到什么。
机器人没有这套本能,它只有像素。像素是平的。画面里一只远处的真杯子,和一只近处的小杯子,投到感光元件上可能一模一样。单张照片天生缺一把尺子,学界的说法叫尺度歧义——同一个画面,既可能是一米外的大物件,也可能是几厘米前的小物件,除非有别的线索替它定夺。
要补上这把尺子,得同时知道三件事:相机在哪、朝哪看,镜头本身的焦距和畸变,画面里每个点离镜头多远。三样凑齐,像素才变回一间可以走进去的屋子。
视频比照片多出来的那一维
照片是时间的切片,视频是时间的连续。人往前走两步,同一只杯子在画面里挪了位置;挪了多少,取决于它离你多远。这个差值就是视差,几何学里最古老的距离测量法之一。
所以视频里那一维不是多出来的画面,是多出来的约束。相机一动,尺度从猜变成算:近的物体在画面里跑得快,远的跑得慢,两条视线一交,深度就落下来了。单帧给不出答案的东西,几帧连起来能给。
LoFT 做的正是这件事。它吃进一段普通 RGB 视频,同时吐出相机位姿、内参,还有每一帧的深度图。没有激光雷达,没有深度相机,只有一台普通摄像头拍下的连续画面。
它怎么把三个问题一起答了
按官方描述,LoFT 用的是双循环的 Transformer。一层在单帧里反复推敲:这张图的深度大概是什么形状,哪些像素可信,哪些是反光、天空或者糊掉的边缘,置信度一并标出来。另一层在帧与帧之间来回校准,让相邻画面的位姿接得上,深度不互相打架。
训练数据是约 297 万条有效序列、9.62 亿帧图像记录。这个量级的意思是,模型见过的「相机怎么动、场景跟着怎么变」的组合,比任何一间实验室能拍完的都多。
评测放在 SpatialBench、ClassicBench、VRBench 三个基准上,多项深度估计指标到了 SoTA。翻成人话:在这几张考卷上,它比先前的模型更会把一段视频拆成三维结构。
榜单第一,和车间地板之间还有一段路
考卷多是室内、仿真、结构规整的场景。车间不是。地面有油,零件在传送带上走,不锈钢护栏把顶灯反成一条条白线,摄像头还得跟着机械臂一起晃。
动态物体是第一个坑:这套方法假设场景大体静止,靠相机运动反推深度;一个走过的人、一台开过来的叉车,会把这份假设撕开。反光表面是第二个坑:镜面不返回纹理,只把别的方向的光送回来,深度在这里没有唯一解。
第三个坑更日常,叫标定漂移。机器人跑一天,镜头被震得偏了零点几度,内参变了,先前算出的三维就整体歪掉,昨天还能避开的立柱今天会撞上。模型能给出置信度,但置信度低的时候,下游该降速、该重拍还是该停下等人,是工程问题,不是论文问题——考卷上不会考这两件事怎么接。
这是地基活,不是又一场发布会
过去两年,大模型的热闹多在语言和图像上:会聊天,会画图,会写代码。这些本事落在屏幕里,错了重来一次就行。机器人不一样,它伸手够不到杯子,杯子就掉在地上,碎片还得有人扫。
所以「几何基础模型」这类东西,位置很靠下。它不负责决策,也不负责人格,只负责把一段视频还原成一个可以丈量的空间。导航、抓取、避障站在它上面,具身学习也站在它上面。
LoFT 是不是那个标准答案,现在没人能说。它证明的是一件更朴素的事:视频里多出来的那一维时间,正在被当成尺子用。等它稳到能在车间里跑一整天,机械手停在纸杯前的那一刻,大概就不会再犹豫。