先说结论
AWS 这次放出来的不是单纯的省钱工具,而是一只沙盘:把编码智能体的试错关进本地,让「失败」变成一件可以承受的事。账单省下来只是顺带的结果,真正变化的是智能体敢不敢试。这句判断比省钱重要。
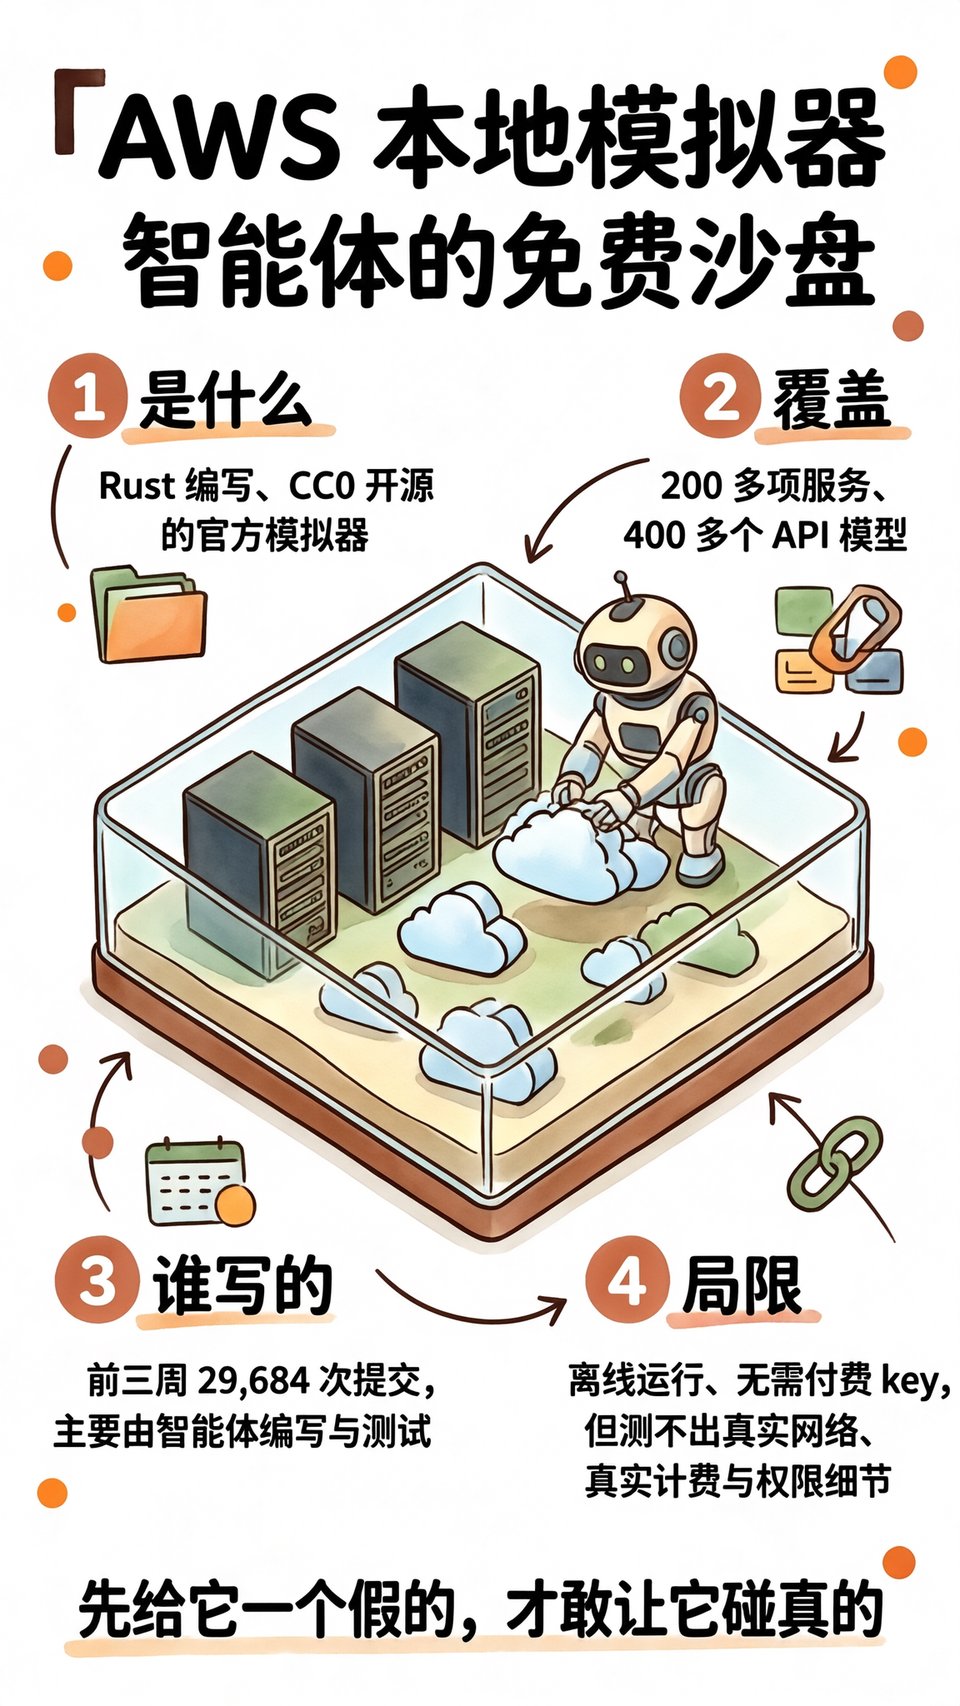
据 AWS 官方博客的说法,aws-emulator 能在本地离线跑一份 AWS 副本,覆盖 200 多项 AWS 服务。编码智能体不用付费 key、不连真云,就能把代码完整跑起来,验证一轮。它交出来的是一份会回应的环境,不是一叠文档。
过去让 AI 在真云上反复试错,麻烦有两层。调用一次接口烧一次钱,一个晚上跑几十轮,账单第二天就失控;更危险的是它可能误删、误改真实资源,一次手滑就是一次线上事故,还得有人半夜上线去补。
我的判断是,它最值钱的地方不在账单,而在节奏。智能体之所以敢大胆试,是因为试错的代价被压到了接近零;错了重来就是,没人需要在旁边掐着预算替它担心。试错空间被放开,产出才会变。
三周近三万次提交
据项目仓库的数据,前三周这个库产生了 29,684 次 commit,而且绝大部分由智能体自己编写、自己测试。这个数字比任何宣传语都有说服力,它是被智能体的手速一轮轮推出来的,靠人手写不可能到这个量级。
一个在自我迭代的智能体,一天要试几十上百次。这些尝试全落在沙盘里,不进账单,也碰不到任何生产资源;失败的成本只剩一点电费和几分钟等待,于是它可以把同一个问题翻来覆去试到通,这正是沙盘的价值。
代码用 Rust 写,以 CC0 释出,谁都可以拿去改、拿去商用,没有附加条件。底座是 400 多个 API 模型,撑起了 200 多项 AWS 服务,这份覆盖度已经接近日常开发真正会碰到的那一圈,想自己补一层服务也不算难。
AWS 的 Swami Sivasubramanian 在 Werner Vogels 的博客上交代了来龙去脉。读下来很清楚:这不是给人类开发者省事的玩具,是给智能体准备的一块练习场,先在里面积累手感,再放到真云上跑,这个顺序别反。
拿它干什么
它的定位很直白:本地起一个端点,把 SDK 指过去,代码照常写。S3 建桶写对象、DynamoDB 建表查记录、SQS 收发消息,这些调用都能得到回应,返回值也像模像样,端到端走一遍不用申请账号。
我在一台旧笔记本上把整套流程跑了一遍。把 endpoint 改成 http://localhost:4566 这种本地地址,业务代码一行没动;aws configure --profile local 是唯一需要多记一步的命令。
对智能体来说,这意味着它可以自己造数据、自己验证、失败了自己重来。不用谁在旁边掐着账单看,也不用担心碰坏别人的线上环境;一个安全的试验场,比一叠漂亮的文档有用得多。
我的判断是,沙盘真正的产出不是「代码能跑」,而是「敢跑」。智能体的能力上限,很大程度取决于它被允许失败多少次;把失败次数卡住,等于提前削掉了它一半的上限,这条判断在沙盘这件事上尤其成立。
它测不出的东西
边界必须说清楚:它只覆盖 API 的形状与基本行为。真实网络延迟、IAM 权限细节、配额与限流、真实计费,以及某些服务的边缘行为,它都测不出来,这部分只能回真云上验证,别指望它替你回答。
「本地跑通」和「上线没问题」之间隔着一条很宽的沟。这条沟恰恰是模拟器最容易抹平的那部分现实,也是最容易让人放松警惕的地方,因为一切都太顺了,顺得不像真的,跑通了先别庆祝。
我的判断是,模拟和真实之间的差距,就是上线事故最常见的来源。本地一切正常,上了真云才发现权限少一条、限流早触发、超时预算不够,这类事故几乎每个团队都遇过一次。
更隐蔽的是计费口径。沙盘里没有钱,你也就不会去想,一次批量任务到底扫出多少读请求;等账单出来,才发现代码里藏着一层套一层的循环,而测试环境从没提醒过你,只有真实账单会说。
我的用法建议
我自己的做法是三段。日常开发和 CI 全跑模拟器,快、免费、可以放手让智能体折腾;真云只留一小段流量做验证,专门看权限、看延迟、看配额,发现问题再回沙盘改,顺序别倒过来。
危险操作单独一道关:删表、改策略、动生产资源,一律先在沙盘里走一遍。把它当「防手滑的第一道门」,成本是一分钟,收益是不用半夜起来处理一场本可以避免的事故,省下的不是钱,是睡眠。
适合谁:手上有一批智能体在写云上代码、又不想每个 PR 都烧一次真钱的团队;还有那些想给智能体放开手脚、又怕它一上来就闯祸的个人开发者,先跑沙盘是划算的,边界清楚,用法也就清楚。
不适合谁:要压测真实延迟、要对账计费口径、要验证 IAM 细粒度策略的场景。这些沙盘给不了答案,还得老老实实回真云,用最小流量付费确认一遍再上线,这道工序省不掉,别拿沙盘当验收。

