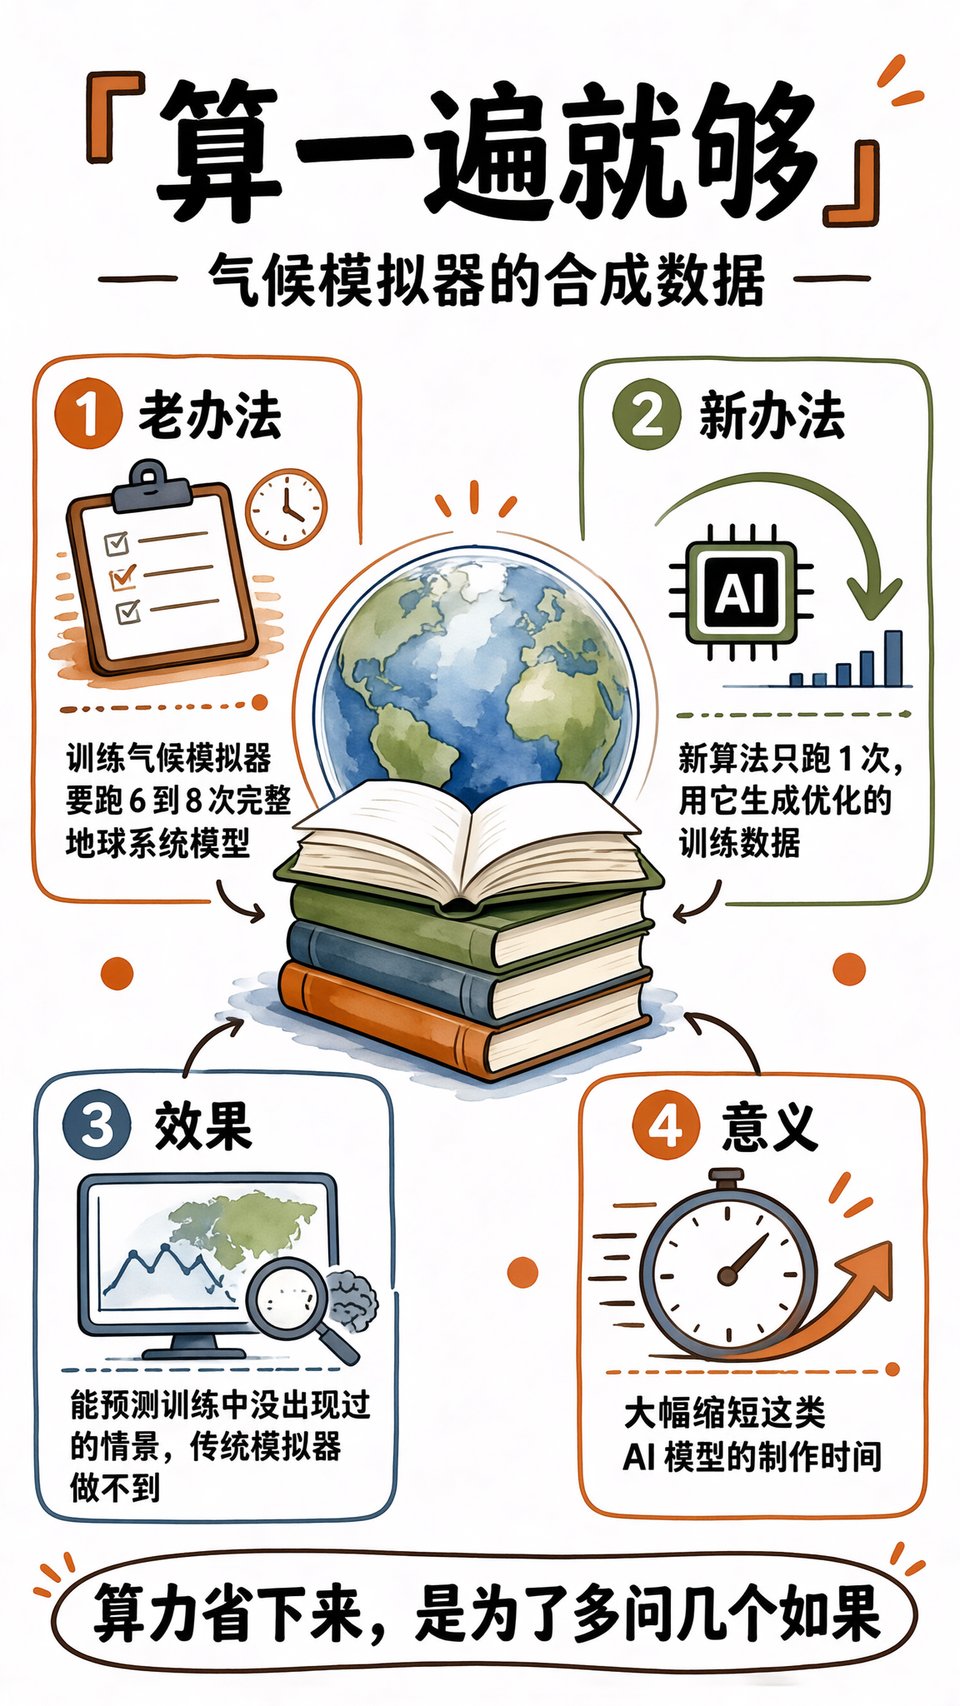
先看一个越来越慢的进度条:一次地球系统模型的完整运行,要在超级计算机上连续跑好几个星期,中途还不能断电。MIT 的研究者想了一个省事的办法:只跑一次,就够教出一个能应付陌生未来的气候模拟器。
一个地球仪和八本厚书
桌上放着一个地球仪和八本厚书,这个画面大致就是今天气候模拟的格局。地球仪是所有人真正想要的东西,手指一拨,答案就转出来了;八本厚书是得到它的代价,一本比一本难读,而且必须整本读完才算数。
厚书指的是地球系统模型。它把大气、海洋、陆地、冰盖和碳循环耦合成一套物理仿真,每一页都是方程,翻页得靠超算。它不做插值,也不查表,而是从某个初始状态出发,一个时间步一个时间步地往前推,推到几十年、上百年之后。
地球仪指的是气候模拟器,学界也叫代理模型。它的本质是学一个便宜的快版自己:拿地球系统模型的输出当教材,学会之后就把老师替换掉,原本几周的计算被压成几秒,代价是精度和可信度都要打折。
折扣写在说明书的小字里。快版只认得教材里出现过的东西,教材之外它会安静地把差异抹平,而且不告诉你它抹了。这一点在气候问题上格外要紧,因为人们真正想问的,往往正是那些谁也没见过的情景。
一次跑完,八次省下
传统做法像让学生把八本厚书通读一遍再去考试。据 MIT 的研究描述,要凑够训练一个模拟器所需的数据,通常得跑 6 到 8 次完整的地球系统模型,每一次都是几周量级的机时,中间还要有人盯着。
新算法把这件事压到 1 次。跑完那一次之后,研究者用算法生成一批精选过的合成数据,专门去补模拟器最需要练的地方,而不是把原始输出一股脑丢进去,让它自己在海量文件里找规律。
这里要分清一件事:合成数据不是造假数据。造假的目的是让模型看起来对,合成的目的是让模型学到对的规律。区别不在数据真不真,而在它教的是规律还是巧合,规律能撑住新情景,巧合一换条件就散架。
同一个道理在别的领域也常见。让学生做十道精心挑过的题,常常比让他把一千道题抄一遍更有效;前提是出题的人清楚这道题在考什么,而不是闭着眼睛随机撒点,然后指望数量解决问题。
没见过的情景才算数
真正决定这套方法成色的,不是它把训练集拟合得多像。论文更看重另一件事:拿训练里从没出现过的情景去问它,看它答不答得上来,也看它答错的时候是错得离谱,还是错得有限、还能用。
用新方法训练出来的模拟器,在这些没见过的未来上依然准确;而传统模拟器一碰到教材外的情景就开始跑偏,适应不了。差别不在误差表上,在误差表之外,也就是在那些没人给它打过分的格子里。
这也说明代理模型的验收标准该怎么定。拟合误差低,只证明它把答案背下来了;外推站得住,才证明它学到了规律。前者是考试的分数,后者才是能不能拿去用的依据,而这两件事经常被混为一谈。
外推为什么会失败,可以想象成一张被拉伸的地图。地图在中间很准,往边缘拉得越远,海岸线就越变形;模型在训练范围里被数据按住,一出去就只能靠它自己猜,猜得顺不顺,取决于它学到的是形状还是比例。
为什么气候模型这么贵
贵有贵的道理。地球系统模型要在三维网格上同时推进大气、海洋、陆面和冰盖,还得让它们互相交换热量、水和碳;任何一处算错,都会顺着耦合关系传到别的圈层去,越往后越难纠正。
时间步不敢放大,因为快过程决定稳定性;空间分辨率也不敢随便降,降下去之后云和对流就糊成一团,而那一块恰恰是最难算、也最影响结果的部分。这两条约束是物理给的,不是工程上偷懒。
模型越接近真实,网格就得越细,步长就得越小,算力需求涨得比线性快得多。这解释了一件看起来奇怪的事:计算机快了几十年,单次完整运行的时间仍然要以周计,没有变成几分钟。
一次运行几周,烧掉的是电费和机时,还有排队的时间。所以这里说的省,省的不只是账单上的数字,还有一整个研究周期被拖长的那些月份,对赶着做评估的人来说,后者往往更贵。
省下来的算力去哪
省下来的算力不会消失,它会换成问题。原本只能问一种如果,现在可以问八种;原本要等一个月才有答案的情景,现在当天就能排上队,问得越多,越容易碰到那个真正要紧的分支。
对做风险评估和工程规划的人来说,差别在这里:先用便宜的快版把明显不靠谱的情景筛掉,再拿完整的地球系统模型去核对剩下的那几个。快版负责铺开,慢版负责定案,位置不能颠倒。
分工也要守住。凡是结论要写进报告、要拿去做决定的,都得回到慢版上复核一遍;快版的用处是让候选清单变短,不是替代最后一次确认,也不是替人背书。
回到开头那个进度条。它还是那么慢,只是不必再走八遍。剩下七遍的时间,被换成了七个还没人问过的问题;而这些答案值不值得信,最终取决于一件事,它教给模拟器的是规律,还是巧合。

