
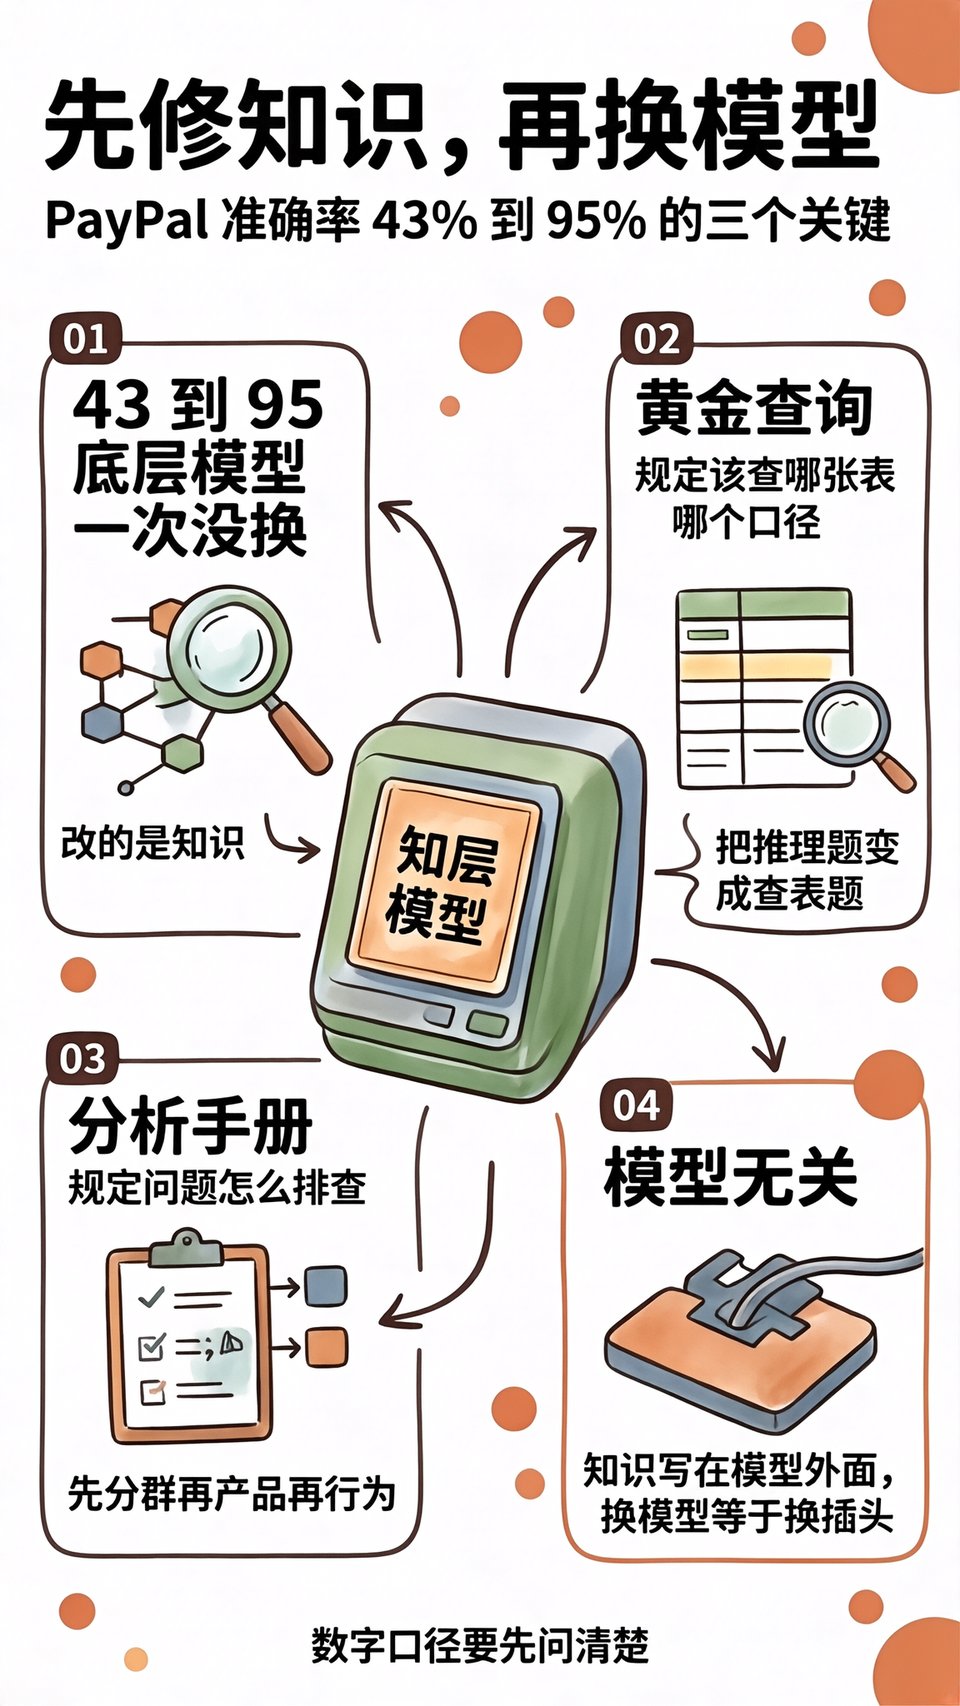
先说结论:PayPal 把内部数据助手的准确率从 43% 提到 95%,这中间一次底层大模型都没换。
据 VentureBeat 2026 年 11 月 10 日的报道,PayPal AI 产品副总裁 Ren Zhang 在 10 月 8 日的 AI Impact Series 上讲了这件事。她给的答案很朴素:提升来自一层经过审核的业务上下文。
说白了,先修知识,再换模型。反过来做,换多贵的模型都是往一个漏的桶里加水。
43% 到 95%,中间换了什么
43% 是什么状态?一个内部数据助手,你问它新账户有多少,它能连上表,能写出语法正确的 SQL,但跑出来的数业务方不敢用。
95% 是什么状态?同一个问题,它取的是业务方认可的那张表、认可的那个口径,结果拿过去就能进报表。
这两组数字之间的差距,不是模型能力的差距。模型没换,就说明模型本来就能取到账户记录,能写对查询结构。
Ren Zhang 举的例子很具体:问「新账户」,agent 能正确找到账户记录,却会用错「新」的定义。
「新」是注册七天内,还是首笔交易未完成,还是没绑支付方式?每种定义对应一套不同的过滤条件,也会跑出不同的数。
这种定义不在训练数据里,也不在表结构里。它在业务方脑子里,是一条口头约定,模型猜一百次也猜不准。
所以那几十个百分点里,相当一部分不是「算错了」,是「答非所问」。数是对的,口径是错的,这种错误在报表里最难被发现。
我的判断是:大多数被归到「模型不准」的故障,其实是「词的定义不在模型里」。模型不是笨,是没人告诉它你们公司怎么用这个词。
划重点:黄金查询和分析手册
他们把补上的知识拆成两层,名字很工程化:golden query 和 analytical playbook。
黄金查询管取数。针对某个具体目的,它规定该查哪张表、用哪个字段、按什么条件过滤。它是一份被审核过的标准答案,不是让模型现场发挥。
说白了,黄金查询把「怎么查」从一道推理题,变成了一道查表题。模型不用再猜业务方建表时的那些习惯。
分析手册管思路。一个问题该怎么排查,先看哪个分群,再看哪条产品线,再看哪种行为,这顺序写在手册里。
她的例子里提到登录失败和 passkey 使用:这类问题不是查一张表能答的,得按一套固定顺序往下走,走错一步就归错因。
划重点,这两个东西防的不是同一种错。黄金查询防「取错数」,分析手册防「思路跑偏」。前者约束 SQL,后者约束分析流程。
两层都不需要动模型参数。写成文档、写成可执行的查询,挂上去就生效,改一条规则的成本是改一段文本。
合起来看,这其实是给模型配了一本《这家公司怎么理解自己的数据》的说明书。厚度不重要,被审核过才重要。
知识为什么必须放在模型外面
PayPal 明确说这套设计是 model-agnostic,与模型无关。我认为这几个字比 95% 那个数字更值钱。
道理不复杂:模型半年换一版,业务规则也在变。知识写在外层,换模型就是换个插头;知识焊进权重,换模型时知识跟着一起丢。
微调就是把知识焊进权重。你今天用 A 模型调出一版懂「新账户」定义的权重,明年底座换成 B,这版权重带不过去,得重调一遍。
而且微调出来的知识不可审。你没法指着某几个参数说「这条规则在这里」,也没法在规则过时的时候单独把它摘掉。
写在文档和查询里的知识是可读的。业务方能逐条核对,能指出这条三个月前就废了,能补一条新的,还能在代码评审里被看见。
所以知识层真正的价值不是提了多少个百分点,是可迁移。能迁移的东西应该写成文档和查询,不该写成权重。
这也解释了一个反常识的现象:越是把知识放在模型外面的团队,越敢换模型。因为换模型对他们来说不叫迁移,叫替换。
他们为什么反而少微调了
报道里有个容易滑过去的细节:正因为这套知识层与模型无关,PayPal 反而收缩了微调。
这个转向值得琢磨。前两年行业里的本能反应是,模型答不好就攒数据做微调,好像参数一动,什么都解决了。
微调的账其实不便宜。要标注,要建评测集,要防灾难性遗忘,每次换底座还得从头再来一遍,而且做完了没人说得清它到底学会了什么。
知识层是一次投入、多次复用。模型升级的时候它不用重写,评测的时候它还能当标准答案用。
说白了,微调是在教模型这家公司的常识,知识层是把常识放在模型伸手就能拿到的地方。前者贵,还会过期;后者便宜,能版本管理。
我不认为微调没用了。语气、文风、固定格式的结构化输出,微调仍然是合适工具。
但「这家公司的业务口径是什么」这类知识,塞进权重是最贵的一种存法。它变得最频繁,也最需要被人核对。
收尾:口径、口径,还是口径
Ren Zhang 自己提了两条保留意见,我觉得它们比 95% 更该被记住。
第一条,测试条件可能和生产环境不一样。第二条,问答量大不等于生产力高。
她提到的消费者端失败信号是:同一个问题反复问、问到一半放弃。她说这些只能当线索,不能当证据。这话说得很克制,也很诚实。
这两条其实在说同一件事:数字的口径。
43% 和 95% 是在哪套测试集上量的?题目分布和生产流量一样吗?谁判的「答对」,业务方还是模型自己?报道没给这些细节。
所以我能确认的是「提升很大」,不能确认的是「这几十个百分点在生产环境里同样成立」。这两句话差别很大,别混着用。
还有一个更根本的问题:43% 这个起点本身就在提示,他们的数据接口原来就不顺。
如果取数链路清楚、口径有文档,一个能写 SQL 的模型不该只有 43%。起点这么低,说明病灶有一半在数据层,不在理解层。
所以动手之前先分清两件事:是取数问题,还是理解问题。取数问题去修表、修权限、修指标定义;理解问题去补知识层。
补错了地方,你会一直觉得模型很笨。补对了地方,你会发现它从来就不笨,只是没人给它那本说明书。
下次再听到「我们的 AI 准确率不行」,先问一句:是它查不到,还是它不知道你在说什么。这两个答案,修法完全相反。

