一只灵巧手拧不开一个塑料瓶盖。它捏出了三道白痕,然后停住。
蚂蚁灵波公布的对照是这样的:同一只 Sharpa Wave 灵巧手、同一套 T-Rex 动作模型,不给触觉信息,成功率 56.25%;把触觉接进去,90%。
这 34 个百分点,讲的不是手变得更灵活,是手终于知道自己在用多大力。
捏碎东西的手,缺的不是眼睛
机器人拧碎东西这件事,这些年被归错了很多次原因。有人说是夹爪太硬,有人说是力控做得不好,有人说是模型不够大。
一个更朴素的解释是:它看不见力。相机能拍到指腹贴上了瓶盖,拍不到那层塑料正在承受多少牛顿。
老式夹爪的逻辑很直白:设一个力,合上,等一个时间,松开。物体硬一点就压碎,滑一点就掉落,中间没有商量的余地。
瓶盖这种活儿,从头到尾都是连续量。接触面积在变,法向力在变,切向摩擦在变,还有一件最难的事——打滑。打滑是渐变,先是微微转动,然后突然脱手。
人的手指怎么处理这些?指腹皮下有一层感受器,一直在报数。人拧瓶盖的时候并不知道自己用了多大力,但手指知道,而且每一毫秒都在修正。
触觉的麻烦:每只手指说的方言不一样
触觉落后视觉,原因不在传感器不够灵敏。
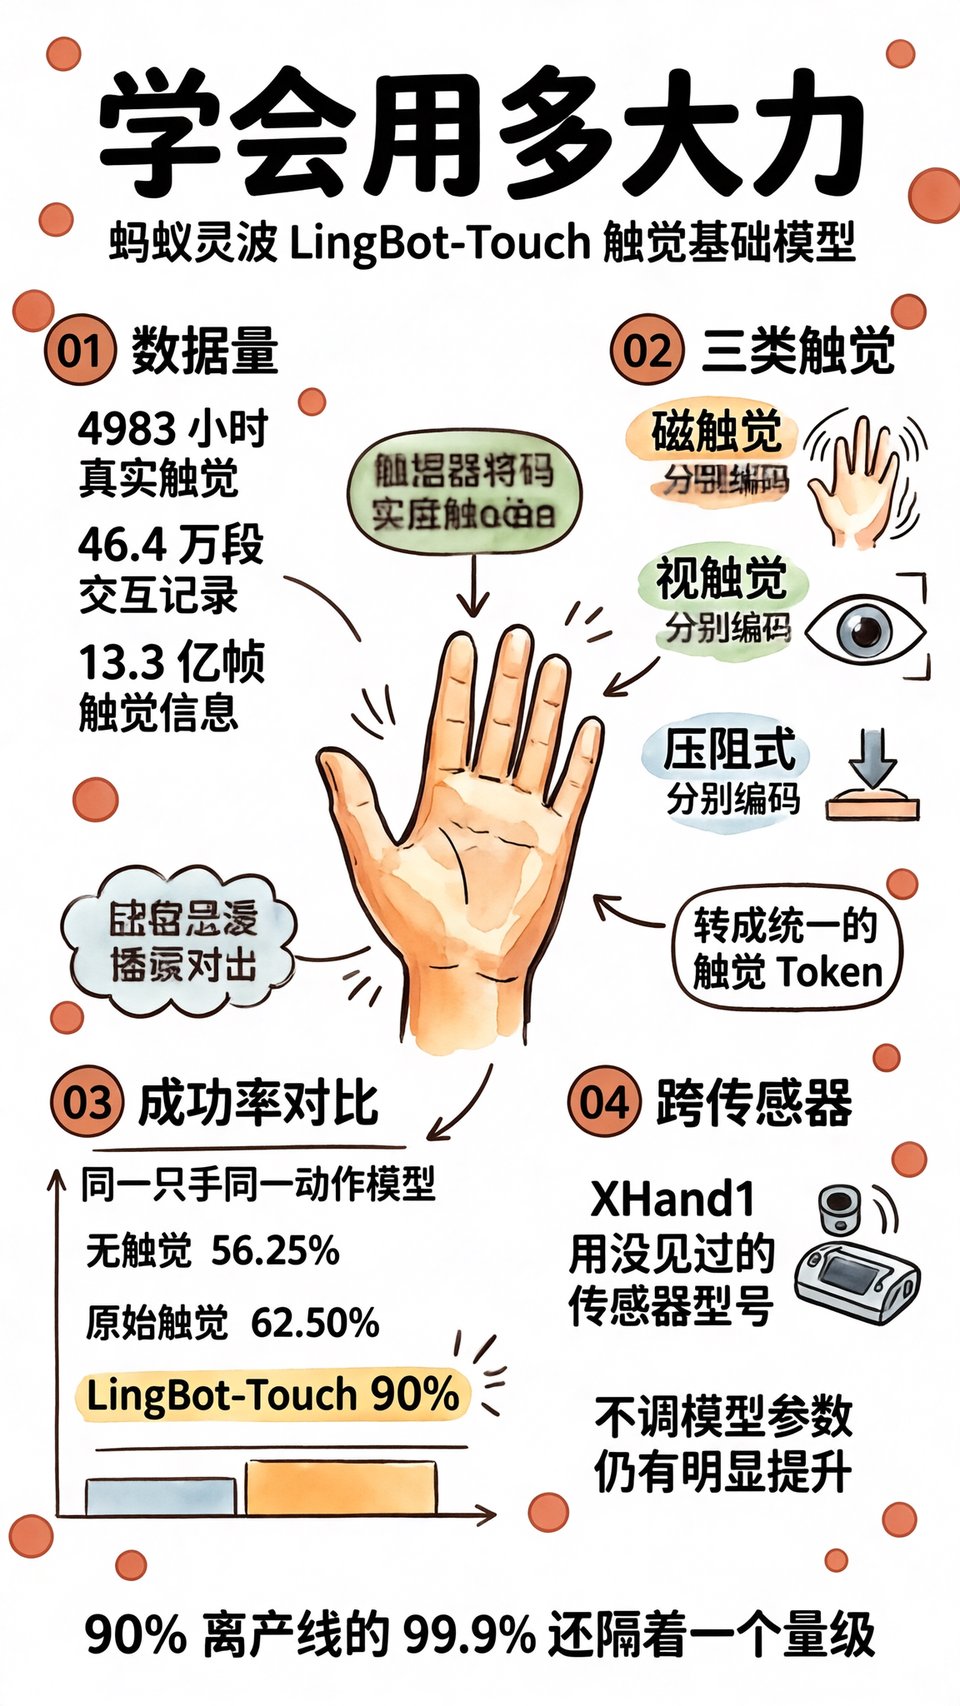
现在主流的三类触觉方案,物理原理完全不同。磁触觉测磁场变化,视触觉用相机拍软胶的形变,压阻式靠材料受压后电阻改变。
它们吐出来的东西也不一样:一串电压、一张图像、一片点阵。采样率不同,噪声不同,量纲不同,连标定的方式都不同。
过去十几年,每个实验室自己搭一条数据管线,模型和自己那套传感器绑死。传感器换一代,模型基本重训一遍。
对比一下视觉就明白了。全世界的相机都输出 RGB 像素,这套表征用了六十年还在用,一个模型在 A 公司的数据上训完,搬到 B 公司的相机上仍然能跑。
触觉从来没有过这样一个公约数。所以它卡住的地方不是硬件,是没有共同语言。
三类信号,拧成一种 Token
LingBot-Touch 做的事,一句话能说完:把三类触觉信号分别编码,再转成统一的「触觉 Token」。
从这串 Token 里,模型要提取三样东西:接触发生在哪里,受力怎么分布,这两者随时间怎么变。
说白了,模型学的不是「这颗传感器的电压是多少」,而是「这里接触了、这么大力、正在这么变」。前面那句是设备方言,后面那句是物理事实。
我认为真正的突破在这里,不在 90% 那个数上。90% 是结果,Token 是原因。原因是可复用的,结果是会过期的。
这个区别很实在。如果只是把某个传感器训到高分,那是一次工程胜利,换个手就归零。如果表征本身和传感器解耦了,那后面每多一类传感器,都是在给同一套语言加词汇。
4983 
小时,多数来自戴手套的人
官方给的数据量是这样的:4983 小时真实触觉数据,约 46.4 万段交互记录,13.3 亿帧触觉信息。
拿这三个数互相除一下,能得到两个有点意思的刻度。13.3 亿帧摊到 4983 小时,平均每秒约 74 帧;46.4 万段摊到 4983 小时,平均一段 38 秒左右。
也就是说,这套数据不是长镜头的连续记录,是几十万段几十秒的短动作拼起来的。拧一个盖子,抓一次杯子,插一次插头。
数据有两个来源:遥操作的机器人灵巧手,和人戴着触觉手套干活。
第二种来源值得多说一句。机器人采数据很贵,一小时的动作要人遥控一小时,采完还要清洗。而人本来就在干活,装配、拧螺丝、包装、开瓶,手一直在产生触觉信号。
戴手套等于把人的手改造成采集器。这条路子把数据成本压下来了,代价是引入了一个新问题:手套测到的力,和机器人指尖测到的力,位置、刚度、贴合方式都不一样。
这个代价,后来变成了这批实验里最硬的一次考试。
56.25%、62.50%、90%,中间那 34 个点
回到那个瓶盖。实验设计了三档,只改一个变量:触觉信息以什么形式进入模型。
第一档完全不给触觉,56.25%。第二档把原始触觉数据直接喂进去,62.50%。第三档经过 LingBot-Touch 转成 Token,90%。
中间这一档最耐看。原始数据只买到 6 个百分点。
原因不难想。原始触觉是高维噪声,策略网络得同时学两件事:这串信号到底什么意思,以及手该怎么动。样本有限的时候,它大部分容量都花在第一件事上。
换成 Token,第一件事由表征层做掉了,策略网络只负责第二件。34 个点里,很大一部分不是新数据给的,是翻译给的。
还得说一句这套实验的干净程度。同一只手,同一套动作模型,只换输入形式,这种控制变量在具身智能的研究里不算常见。多数工作一次改三样,最后谁也说不清是谁起的作用。
26 项任务,和一场没复习过的考试
范围放大之后,官方给的是这样一组:Sharpa Wave 与 XHand1 两款灵巧手,四种动作模型,26 项真机任务。接入 LingBot-Touch 之后,每一种组合的平均成功率都高于直接喂原始触觉的方案。
单看 XHand1 的六项任务:π0.5 的平均成功率从 48.00% 提到 74.17%,LingBot-VLA 从 57.21% 提到 75.04%。
跨传感器那组更值得盯。训练用的磁触觉数据全部来自人类触觉手套,而 XHand1 用的那款磁触觉传感器,型号此前没在训练数据里出现过。
做法是不调模型参数,只针对具体任务训策略。结果机器人仍有明显提升。
这就是前面那笔账的答案:手套和机器人指尖之间的差距,被表征层吃掉了。模型学到的是接触这件事本身,不是某颗传感器的脾气。
得把话说全。这叫零参数调整,不叫零数据。每个任务还是要单独训策略,至于要多少条示范、和以前比省了多少,公开材料里没有。这一块留白,恰恰是工程上最要紧的那块。
90% 到 99.9%,差的不是 9.9 个点
90% 听起来已经很能打。落到产线上,它的意思是十次错一次。
一条线一小时拧一千个盖,就是一百次失误。失误的形态还要紧:捏碎的盖子卡在传送带上,停线,等人来清。停线一分钟的账,比那只手贵得多。
实验室的成功率也不该被当成一个精确值。26 项任务取平均,是一个数;每项跑多少次、跑出来波动多大,公开材料没说。这个 90% 后面没有误差棒。
工厂要的东西是另一种:不是多数时候成功,是十万次循环里力的一致性。夹爪会老化,车间有温差,瓶盖上有残液,来料有公差。这些长尾一个都不在 26 项任务里。
所以 90% 值得记一笔,但它离产线隔着一个量级。把 90% 读成「机器人会干活了」,是这两年最常见的一种误读。
反过来说,56% 到 90% 这一段也不是白走的。它证明了一件事:给机器人装触觉,重点不在装传感器,在给触觉找一种能跨设备读懂的说法。这条路上,跨传感器的迁移比单个成功率更能说明问题。
回到那只拧不开瓶盖的手。
人做这个动作的时候不计算,手指知道。机器人现在有了一个数字,也有了把数字翻译成动作的办法。
眼和手的差别不在精度。眼睛告诉你发生了什么,手告诉你还能不能再用力一点。这中间的那段距离,就是剩下的 9.9 个点。

