先说结论:豆包工作这次多塞进来几个别人家的模型,能力上的变化不是重点,计价方式变复杂才是。
以前你只需要知道自己套餐里有多少额度。现在你得知道,同一个额度花在不同模型上,能买到的东西不一样。
这笔账以前平台替你算,现在摊到你面前了。它没坑你,但它也不再替你省心。
这次到底上了什么
据豆包官方公众号 2026 年 11 月 12 日的更新,豆包工作的模型列表里多了第三方选手:Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash,官方后面还带了个「等」字,意思是不止这三个。
原来就在的豆包 2.1 Lite 和 2.1 Pro 还在。所以现在是自家模型和别家模型并排站在同一个下拉框里。
官方同时提了一句限时优惠:工作日和节假日的指定时段,用参与活动的模型,额度消耗有优惠。另外豆包 2.1 Lite 和 DeepSeek V4.1 Flash 的额度消耗倍率已经下调。
新用户登录电脑版,能免费领 30 天订阅权益。这条对还没装的人是好事,对已经在用的人没什么用。
信息就这么多。具体倍率数字没公布,模型单价没公布,优惠时段表也没公布。
一个工作台塞三家模型,图什么
官方没解释原因。我的判断是两条:一是留人,二是补短板。
留人这条好理解。以前用户会因为某个模型写代码强、某个模型中文顺,在工作台之间来回跳。现在一个下拉框里全有,跳的理由就少了一半。
补短板也直白。豆包 2.1 Pro 再强,也不可能每项都压过所有对手。把 Kimi、GLM、DeepSeek 摆进来,等于用别人的长板补自己的空位,成本还比自研低。
所以这件事最大的受益方其实是平台自己,不是你。你多的是选项,少的是判断依据。
额度倍率到底是什么东西
很多人把「额度」和「token」混着用,这是理解这套价目表的第一个坎。
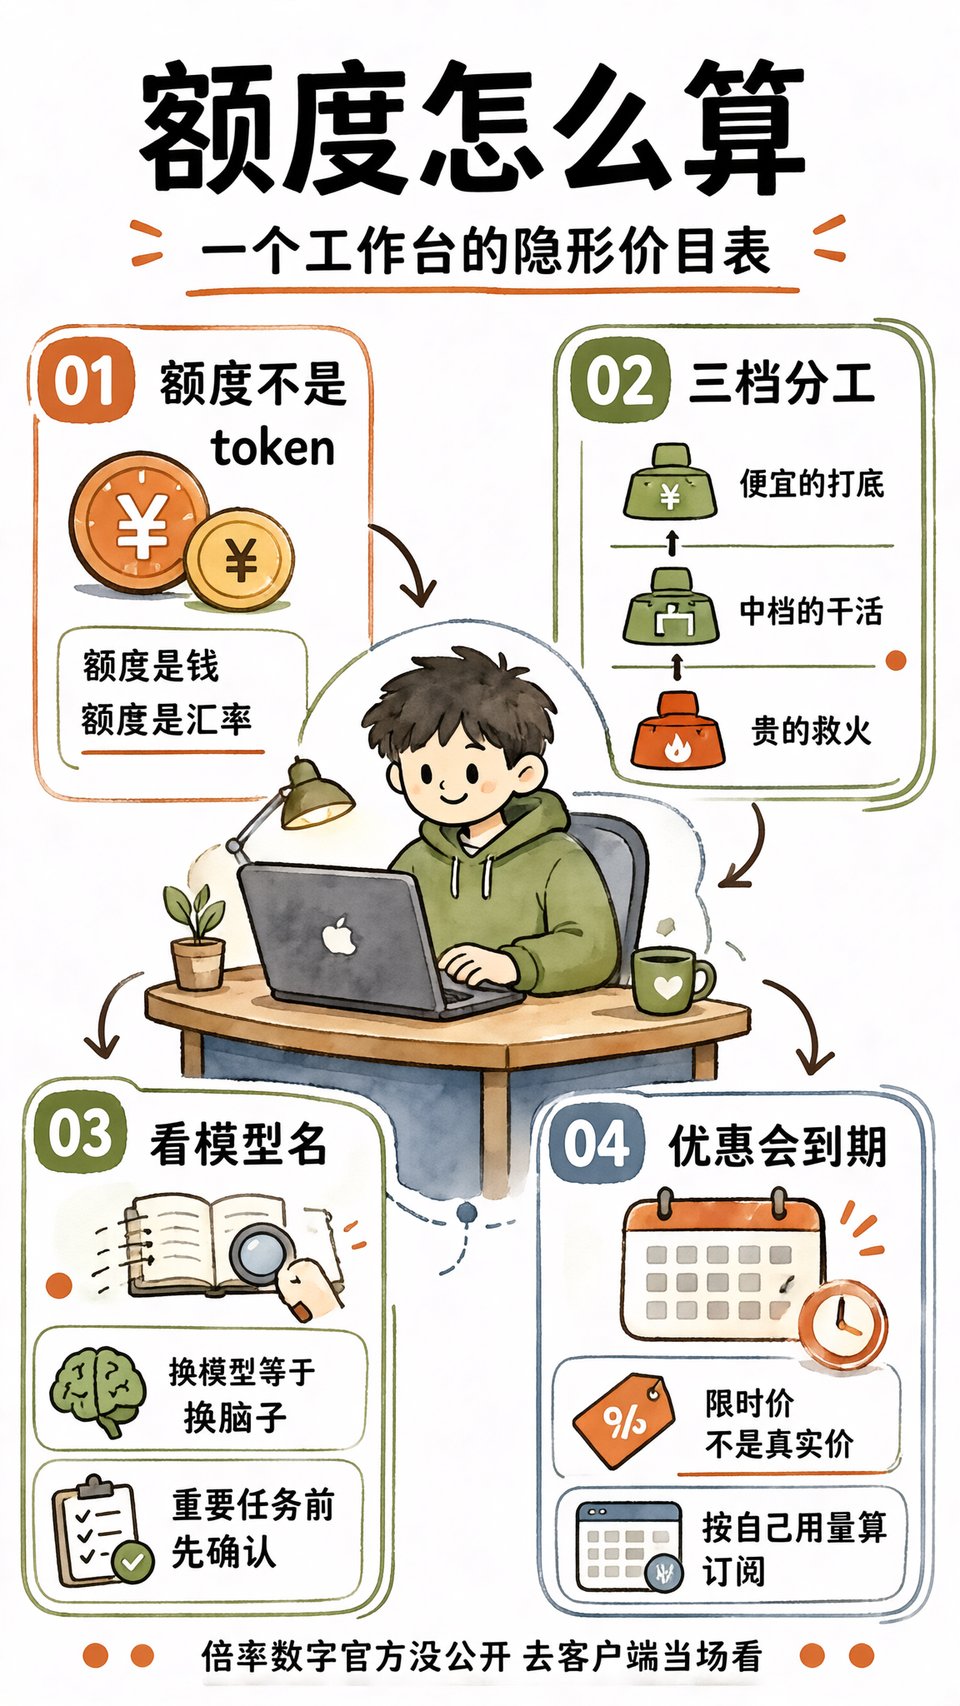
token 是模型读写的字数单位,额度是你套餐里能花的钱。两者之间要乘一个系数,这个系数就是额度消耗倍率。
翻成人话:同样的额度,在 A 模型上能买到一万字,在 B 模型上可能只买到三千字。额度是钱,token 是货,倍率是汇率。
倍率 1 是基准价,倍率 2 就是同一件事贵一倍。你花掉的额度一样多,拿到的输出长度差一截。
有人会想,贵的是不是一定更好。不一定。但官方敢定高价,通常是自己判断这个模型在这个价位上有人愿意买单。
麻烦的地方在于,倍率具体是多少,这次官方没公开。你只能在客户端的模型选择页上,当场看那个数字。
我把这句「没公开」当成信息点,而不是当成缺陷。它意味着选模型这件事,以后得变成三个动作:打开列表、看一眼数字、再决定点谁。
怎么搭配着用:三档分工
如果我自己上手,我会按「打底、主力、救火」三档来排,而不是每次都点看起来最贵的那个。
打底用豆包 2.1 Lite 这类。官方已经下调了它的倍率,说明它被放在便宜量大的一档。整理会议记录、把一段话改通顺、批量翻译短句,这些活儿用它就够了。
主力是日常写稿、做表、看长文档,用中档的。这一档是性价比的主战场,也是你一天里待得最久的地方。
救火才换贵的。代码报错查不出来、逻辑绕不明白、方案要一次成型,这时候贵模型的贵是值的。
关键是别让救火的模型干打底的活儿。用高倍率模型去改错别字,等于打车去买菜,钱花了,菜也没新鲜多少。
反过来也一样。该救火的时候舍不得,拿一个便宜模型反复追问,问十遍的时间成本比那点额度贵得多。
场景还原一下:早上把昨天的语音转写丢给便宜的整理成纪要,中午让中档的改一版对外文案,下午写脚本卡住了,再切到贵的那个。同一天里换三次,很正常。
三个提醒,比模型名单更要紧
头一个,限时优惠是拉新的价格,不是真实价格。官方写的是「指定时段」和「参与活动的模型」,两个限定词都在,说明优惠收得回去。优惠结束那天,你原来的用法可能突然变贵。
第二个,第三方模型进来,意味着你习惯的那个能力可能被换掉。以前豆包工作里写代码大概是豆包自己在干,现在列表里多了几个写代码的强手,默认选项说不定就换了人。
所以我现在的习惯是,让模型做重要的事之前,先看一眼模型名。名字变了,结果就可能变,这不是玄学。
第三个,订阅制的东西,得按「你一个月到底用多少次」来算。30 天免费听着香,但免费期结束那天,你要决定的是续不续,而不是用不用。
一个月只用三五次,买单月或者按次可能更划算;每天都在用,订阅才省钱。这个账每个人的答案都不一样,别照抄别人的。
多模型同台还有个隐性好处:同一个问题换个模型再问一遍,两个答案不一样的地方,往往就是这个问题真正的难点。这招我经常用,比反复追问一个模型有效。
回到开头。多模型同台给你的不是更多能力,是更多选择,而选择是要花时间成本的。
我的态度很明确:把便宜的那档设成默认,把贵的当工具,别把最贵的当默认。至于倍率具体怎么算,官方没写,你就自己去那个页面上看一眼。看一眼的成本,比事后心疼账单低多了。

