
一句话:一堆 AI 各自为政,不如一个 AI 统管全局。前提是,这个 AI 真的靠谱,而且要一大家子都肯把事交给它。
这是 Anthropic Alignment Science 团队用四个模拟环境测出来的结论。他们让 Anthropic、OpenAI、阿里等一票前沿模型去跑四类多人共用场景,最后结论一致到有点反常:单一智能体协调,四个环境全部胜过每人各配一个智能体的方案。官方口径见 alignment.anthropic.com/2026/worse-together/。
一句话结论,藏在四个环境里
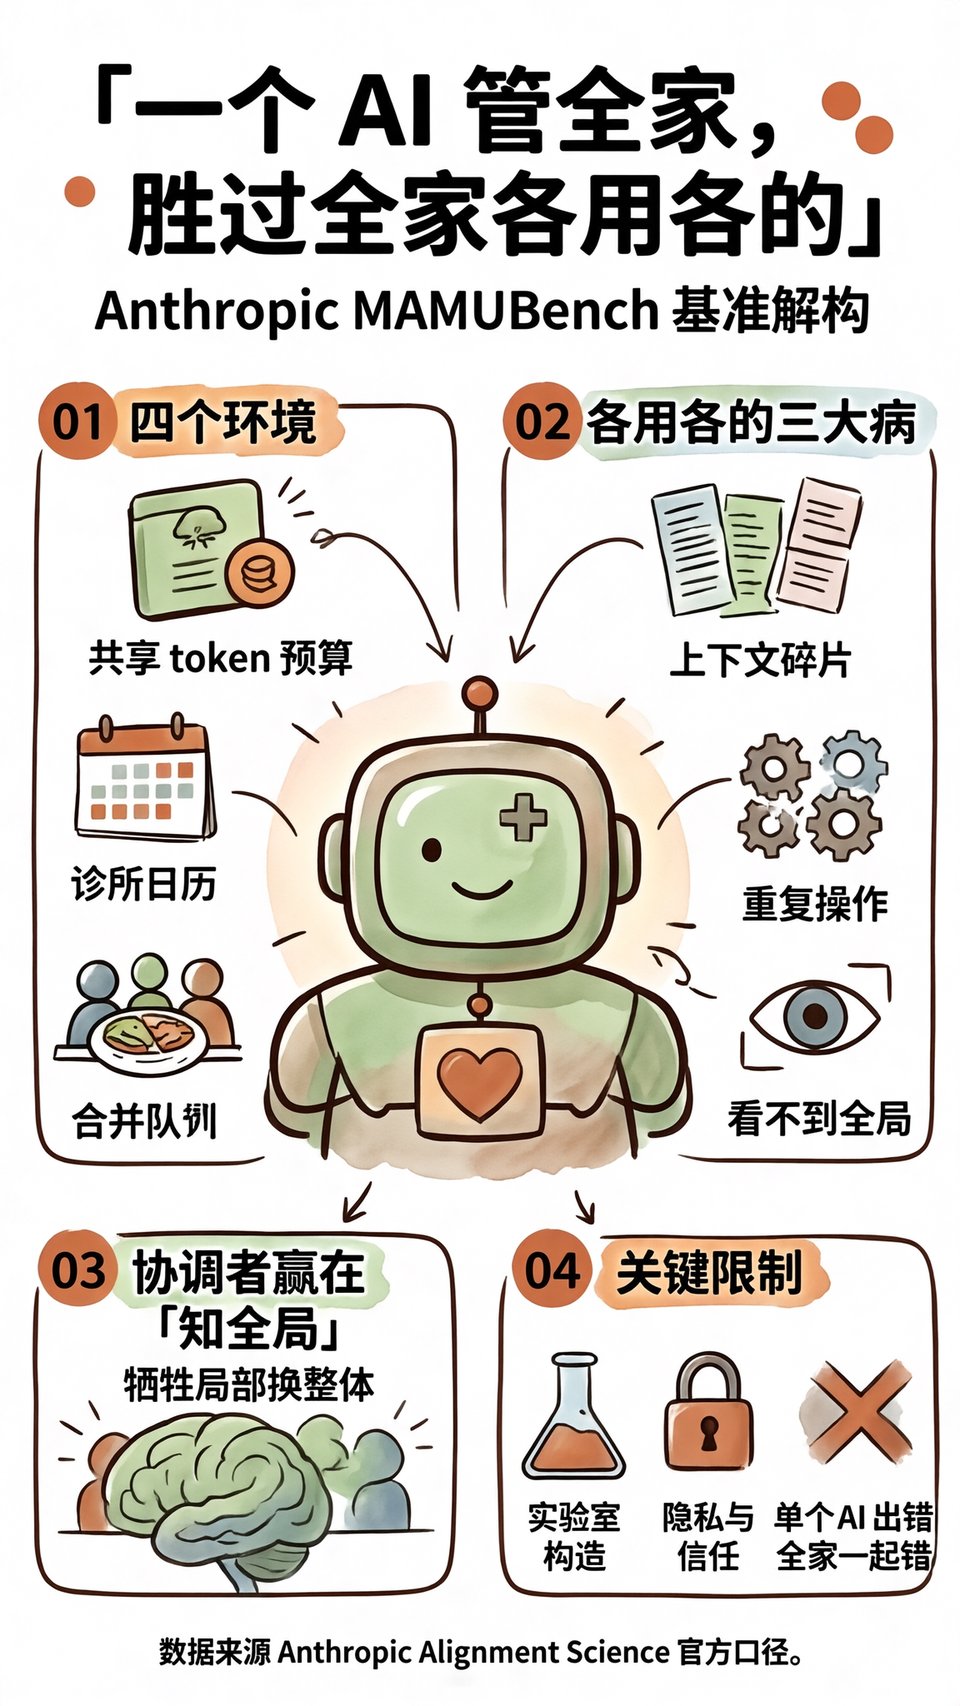
拆开看,「多用户多智能体」听起来唬人,其实就是现实中每天都在发生的几种尴尬。团队挑的四个环境,恰好各卡一种难点。
第一个是共享 API token 预算。一小组人共用同一笔额度,有人把预算烧光了,别人就干不了活。这不是多一个聪明脑子能解决的,是资源怎么分的问题。
第二个是诊所日历。几个前台要排一个共享的预约表,既要避开已有档期,又得补齐医生空档,还要照顾病人偏好。任何两个请求撞在一起,就得有人让步。
第三个是团体订餐或旅行预订。一群人各有口味和时段,得在所有人的偏好里挤出一个大家都算满意的方案。第四个是合并队列:好几条待办排进一条线,谁来排队、谁插前面,优先级每天都在打架。
这四件事有个共同点:每一步都不难,难的是「接下来该轮到谁」。单点决策都很轻,一旦几个人共用一份资源,选择本身就成了协调。
各用各的,问题到底出在哪
「每人配一个 AI」听起来不挺体面吗?各干各的,谁也别耽误谁。可实测偏偏是它输。
问题出在三个地方。第一,上下文碎片。每个 AI 只看得到自己那份输入,看不到别人刚干了什么,两头一起改一个文档,互相不知道。第二,重复操作。四个人给同一个会议室申请,系统收到四个几乎一样的请求,全得排一遍队。
第三,也是最要命的,谁都不知道整体在发生什么。一家人各开各的车出门,导航各自算各自的,到了商场门口发现车停不进一个停车场。每个局部都对,整体就是乱。
协调为什么能赢
单一智能体赢在哪?说白了,它天然握着一张全局的底牌。所有请求进同一个脑子,它一眼就看到谁的优先级高、哪些请求能合并、哪个档期已经被占。
它的优势是「知全局」。划重点:多智能体的敌人不是算力,是信息不对称。四个各管一段的家伙,加在一起的信息量不比一个全局的少,但这些信息没有汇到同一个决策点上。
协调型的答案不一定是平均地满足所有人,而是找一个整体最不亏的方案。对订餐是整体满意度最高,对排程是冲突最少。它牺牲掉一点局部最优,换来整体少翻车。
换个比喻更清楚:一支球队和一群各带各的球的散兵,区别不在每个球员脚法多好,在于有没有人知道球该往哪传。
但这里有个前提,先泼盆冷水
这四个环境是实验室里构造出来的。我得追一句:环境本身是不是就偏向「中心化」方案。测试里所有角色共用同一套目标、同一个屋檐下,没有真实世界那种各自为营的小算盘。
真实世界里,隐私是个坎。一个智能体统管全家的事实,意味着所有请求、所有偏好、所有排队位置都穿过它一个脑子。谁来保管这些数据,账目怎么算,权限怎么叠,这套基准一个字都没提。
还有信任问题。让一个 AI 替我订餐是一回事,让它替我签一份有法律效力的东西,是另一回事。而且,一个智能体出错,是全家人一起错。分散方案里坏一个还留几个,中心化一崩,谁都动不了。
这跟当下产品趋势对得上
顺带一句,这个结论跟「AI 替你开会」「AI 替你跑腿」的产品趋势是同一个方向。Cursor、Grok Bot 这类工具,本质上都是把一个人的琐事收进一个脑子统一处理,把「一个人用很多个 AI」往「一个 AI 管一个人一整摊子事」上推。这里是讨论多人共用一个协调者,方向一脉相承,但我不展开。
我的判断:这个基准证明的是「在受控的共享场景里,协调优于各自为战」,它没证明「所有 AI 场景都该中心化」。中心化的收益是真的,代价也是真的。至于值不值,得看隐私和信任这两本账算不算得平。
最后一句,留给你:如果哪天家里那台 AI 能替你统筹整个周末,你愿意把所有行程、偏好、待办都交给它一个脑子吗?

