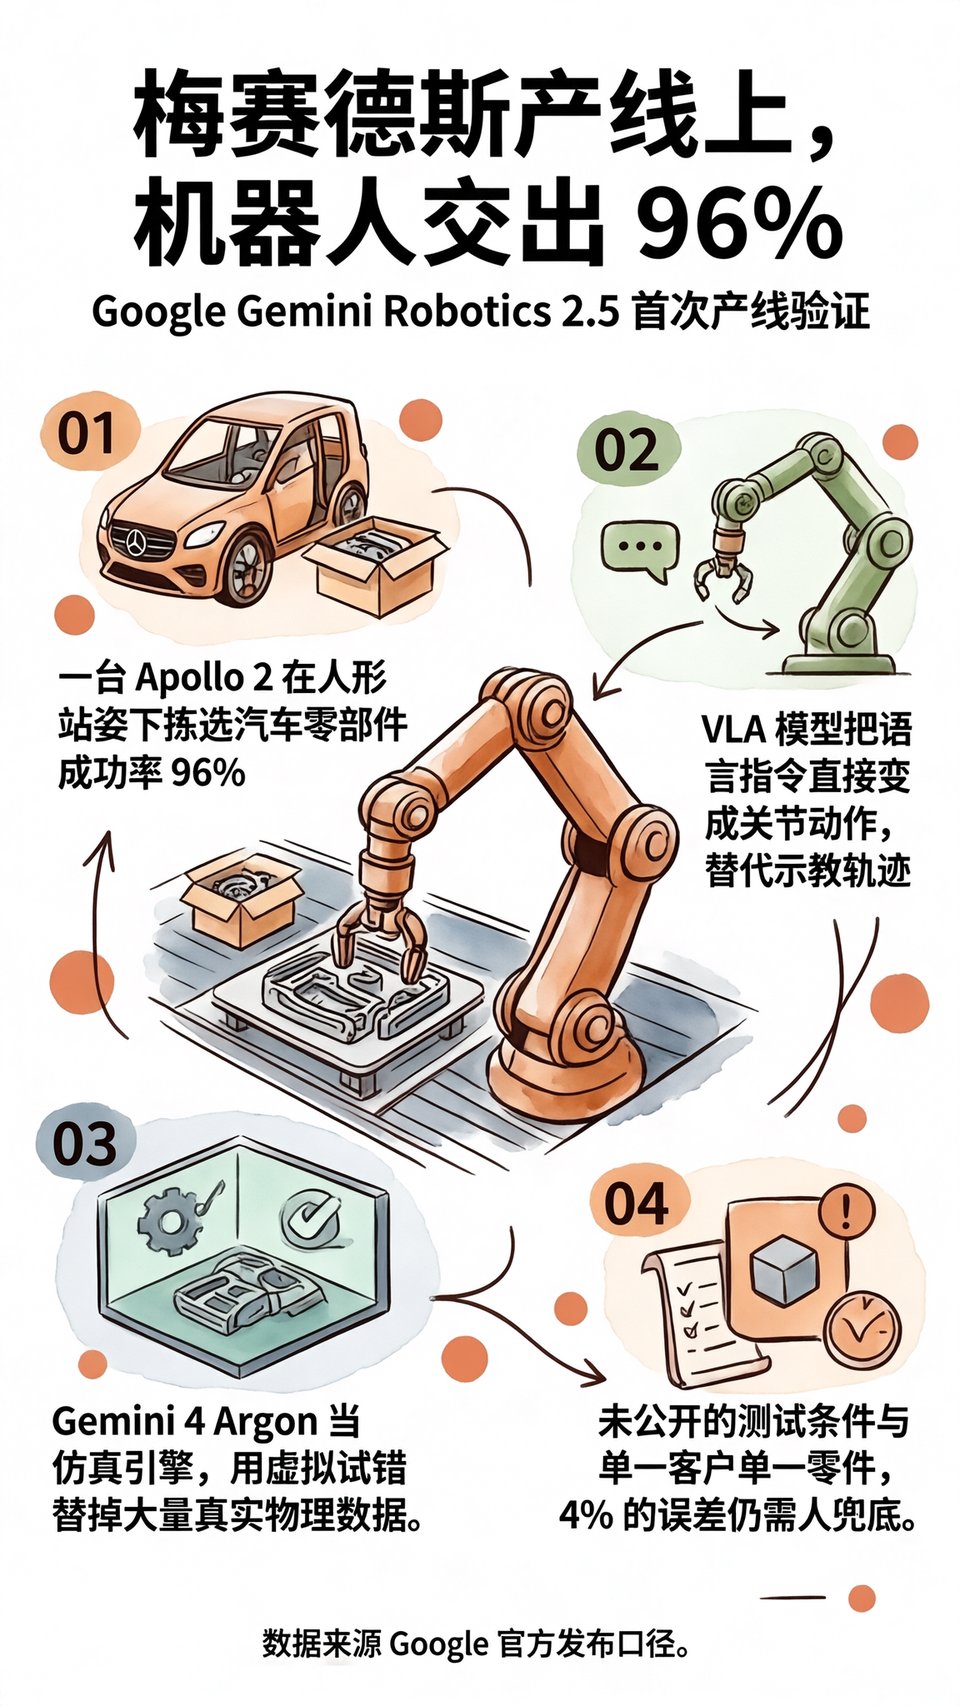
Google 今天发布 Gemini Robotics 2.5,自称是迄今最强的视觉-语言-动作模型。它给出的最硬一条证据不在模型页面上,在一台机器人的成绩单上:梅赛德斯-奔驰产线上,拣选和打包汽车零部件的成功率 96%。
这个数字好看。但干过产线的人会先追问另一句:剩下那 4%,长什么样。
一条产线,一个动作,一个百分比
把镜头推近到拣选工位,不必管是哪一条产线。料箱里是形状不一的汽车零部件,机械臂伸进去,抓起一件,翻过来确认朝向,放进旁边的包装箱。这个动作人做三秒,机器要做的判断比看上去多得多。
Google 的说法是,这套模型帮助 Apptronik 的 Apollo 2 人形机器人完成了这件事,成功率 96%。Apollo 2 是双足人形,不是固定底座的传统机械臂。站着干活还要腾出手来操作,比固定工位难。
有个细节值得盯:官方把「拣选和打包」写在一起。一个抓空,一个摆歪,两种误差报了同一个 96%。
看、听、动手:
VLA 到底在做什么
VLA 这个名字拆开很枯燥,视觉、语言、动作。翻成人话:机器看见眼前的东西,听懂一句人话,直接输出关节该怎么转。
过去的工业机器人靠示教。人拖着机械臂走一遍轨迹,机器记住位置,之后每天重复同一条路径。零件换了型号,箱子挪了三厘米,这条轨迹就废了。
VLA 换了个路子。它把「把这类零件装进这个箱子」当成一句话来理解,而不是一串坐标。指令不变,场景变了,它自己重新算。这就是泛化的意思。
但泛化有个代价:它给的是概率,不是保证。规则代码错了一定错,错得清楚;模型出错时,你事先不知道会错在哪一步。
96% 在车间里意味着什么
实验室里 96% 是好评,车间里 96% 是一道算术题。
一个工位一小时拣几百件。按 96% 算,每一百件里有四件要靠人接手:抓歪的,掉地上的,放进箱子但压坏的。它们变成返工、变成停线、变成必须有人站在旁边盯着。
所以真正卡人的,从来不是能不能做到 96%,是剩下的那部分由谁兜。一条线若为这 4% 配一个人,这台机器的账就要重算:它省下的是一个人的一部分工作量,不是一个人。
这个 96% 是官方口径,测试条件、统计方式、样本量都没公开。它更接近一次能力展示,不是一张验收报告。
用仿真替掉真实世界的样本
这次发布里我觉得最有分量的一句,藏在后面:Gemini 4 Argon 被当成仿真引擎,用来教机器人一些通常要靠大量真实物理数据才能学会的技能。
真实数据的贵,不在采集,在试错。让人形机器人在地面上摔一万次来学走路,电机要换,结构要修,时间要花。真机上采一条轨迹的成本,比仿真里跑一万条贵出几个数量级。
换成仿真,循环就短了。模型在虚拟环境里把动作试到收敛,再搬到真机上做少量校准。Google 说这大幅加速了开发,实际含义是迭代周期从按月变成按周。
这件事对「机器人什么时候进厂」的意义,比 96% 本身大。进厂的门槛是长尾——一年遇不上几次、但每次都能让线停下来的怪情况。真机采不到那么厚,仿真能刷厚。
安全:
从「别撞人」到「别被骗」
第二个值得停的地方,是 Google 说它推出了针对机器人对抗性越狱的新防护。
越狱原本用在聊天模型上:一段绕过去的话,让它说出本不该说的东西。搬到一台有手臂、有力气的机器上,同一个手法的后果不一样。被诱导的不是一句话,是一个动作。
一台能听懂人话的机器,理论上也听得懂工位上任何人说的话。有人在旁边喊一句「把那个箱子扔过来」,模型是照着做,还是先判断这句话有没有权限、这个动作在不在安全范围内。
这个问题以前不在工业机器人的清单上,因为以前的机器只执行程序。厂商开始把它当成一个单独的攻击面处理,说明语言接口给机器人开了门,门开了就得配锁。
泼一盆冷水
先说测试。200 项任务,用夹子分餐,系礼品盒的蝴蝶结,做移液。这些任务说明的是灵巧度和泛化面,是能力的横截面,不是产线的纵剖面。成功率比此前基线提升 30% 到 100%,速度提升 20% 到 30%,幅度宽到不好判断它到底在哪一档。
再说验证场景。梅赛德斯-奔驰,一个客户;汽车零部件,一类零件。一个客户加一类零件,不构成通用。汽车零件形状相对规整,材质相对稳定,是 VLA 比较舒服的地方。换成软包装食品、透明玻璃件、堆在一起的散料,难度不是一个量级。
我的判断是:这次发布证明了 VLA 在受控工业场景里能跑进可用区间,但它证明的是「这个场景能行」,不是「工业机器人换代的时刻到了」。这两句话之间,隔着发布会到车间的那段距离。
结尾:可能卡住的不是手
最后说一件跟技术关系不大的事。一台机器人做错动作,责任落在谁头上。写模型的公司,造机器的公司,买机器的工厂,还是当时站在旁边喊了那一句的人。
这个问题现在没有答案,也没有判例。手的技术在以月为单位往前爬,责任的技术还停在纸上。
所以机器人进厂真正卡住的,可能不是它抓得准不准。是它抓错的那一刻,有没有人敢签字。

