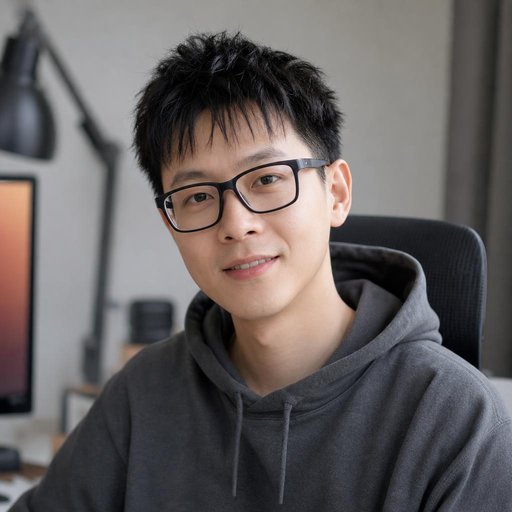
先说结论:Gemini Decision 1 不是「更便宜的 Gemini」,它是一台专门用来做判断的机器——你给它一批选项,它还你答案加一个置信度,一次最多一千个问题。输入每百万 token 0.10 美元,输出不收钱。
它不是聊天模型,是判卷机
大部分模型干的是「生成」的活:写文案、写代码、把一句话扩成三段。Decision 1 干的是「判断」的活:这条评论要不要拦、这份表单能不能过、这个工单派给哪个组。
据 Google 11 月 11 日的 Gemini API 更新日志,Decisions API 支持是非题、选择题和量表评分三类问法,单次请求最多 1,000 个问题,每个答案附置信度分数。输入可以是文本、图像、音频、视频、PDF,上下文 256K,延迟官方说 150 到 250 毫秒。
OpenRouter 首日就上了。对一个刚发布的模型来说,这意思很明确:Google 没打算把它关在自家控制台里。
封闭式决策在业务里长什么样
「封闭式」这三个字是关键。答案在你给的选项里,不需要模型自由发挥。是非题就是是或否,选择题从最多两百多个选项里挑一个,量表题就是打一到五分。
想象一个电商后台,堆着三千条商品标题,你要判断三件事:有没有违禁词、类目对不对、主图和标题是不是同一个东西。以前是三个人干两天的活,现在是一次请求的事。
它更像质检员,不像写手。质检员不需要文采,只需要每条都打勾,而且打得一致。聊天模型干这活儿的毛病是话多——它总要解释两句,你还得写正则把解释剥掉。
一毛钱改的是成本结构
0.10 美元一百万输入 token,输出不计费。Google 自己的说法是,在共享基准测试套件上,它的成本效率比走 Interactions API 的 Gemini 3.5 Flash-Lite 高近 5 倍。据同花顺 11 月 12 日的快讯,这一定价也是对外公布的核心卖点。
这个价格的意义不在省钱,在于把「敢不敢全量跑」这件事翻了过来。以前一万条数据得抽着看,现在可以整批扔进去。
一个判断的成本低到可以忽略,人的做法就会变:不再是「挑重要的看」,而是「全都过一遍,只看可疑的」。
背景补一句:同一天 Arena 上 Meta 的 Muse Ember (Max) 拿了高效模型第一,每任务约 0.02 美元。决策这条赛道上,现在比的不是谁更聪明,是谁更便宜。
适合谁:手上一堆待打勾的活
三类团队最该看它。一是内容平台,评论审核、内容分级、违规判定,量大且标准统一。二是电商和 SaaS,类目归类、字段校验、工单路由。三是做 Agent 的,流程里那些「要不要调下一个工具」的分支判断。
共同点是:你手上有一批格式统一、答案有限、量还特别大的判断。这类活儿最难的地方从来不是聪明,是一致。
如果你的业务每天有上千条这种判断,花半天接一下接口是值的。如果是每周几十条,说实话用现在的聊天模型加个提示词就够,别为它改架构。
不适合谁:别拿它写东西
需要长链条推理的,别用。它不逐 token 生成,你没法让它把思路摊开给你看。需要多轮对话的,别用,它没有那套东西。要写内容的,更别用。
最常见的误用是把它当成 GPT 的平替。它不是。它是流水线上的一个工位,不是一个能陪你聊半小时的助手。
还有一类也不合适:答案本身是开放的。比如「这条差评该怎么回」「这个方案好不好」,这类问题连量表评分都救不了,因为没有公认的标准答案,模型给的分数也只是它的口味。
泼冷水:它判错了不会举手
校准置信度听起来很美,但置信度高不等于对。一个模型用 0.95 的把握给你一个错误答案,比它犹豫不决更危险。
第三方评测机构 Artificial Analysis 已经出了 Decision Index,Gemini Decision 1 在 v2.1 上拿 66 分。这个榜单本身很新,66 分放到你的业务里是什么水平,没人能替你换算——榜单测的是公共题目,你的业务是私有分布。
最大的风险是安静地错。聊天模型胡说八道时你一眼能看出来,因为那段话读着别扭;决策模型的输出就是一个字段,一个 0,一个 1,流程照常往下走,没人会停下来问它一句「你确定吗」。
先拿五百条历史数据对一遍
给个能落地的做法:从你自己的库里抽 500 条已经有人工结论的历史数据,把人工结果当标准答案,跑一遍。看三件事。
整体准确率是多少。错的那些有没有规律,是集中在某个类目,还是集中在写得模糊的那批。置信度低的那批,是不是真的错得更多。
三个都过关再谈上线,最好先做成「模型判 + 人复核可疑项」的灰度,别一上来就替掉人工。决策模型最贵的地方不是 token,是它判错之后你得花多久才发现。
最后一句话:一毛钱一个判断确实便宜,但便宜的判断错了,赔的是你的流程。新工具最好先让它证明自己配得上那一毛钱。

