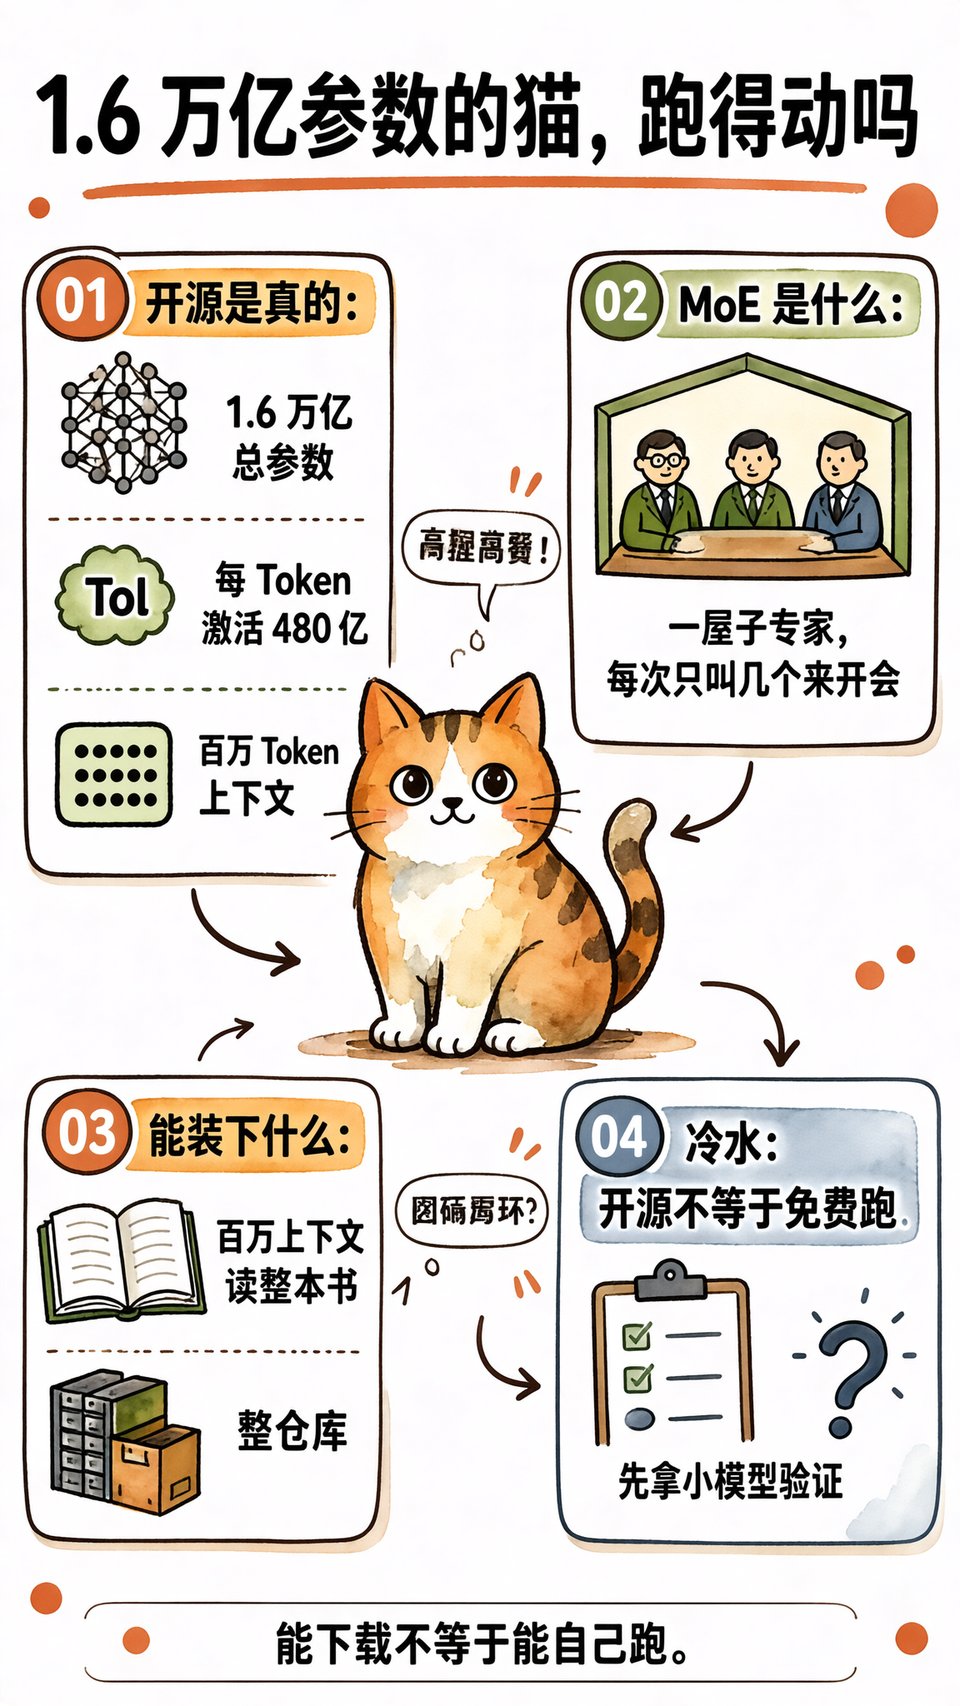
先说结论:值,但别急。美团开源了 LongCat-2.5 多模态大模型——1.6 万亿总参数、每 Token 激活 480 亿、支持百万 Token 上下文。据 AITNT 全球AI新闻日报 2026-11-12 报道,它四项公开测试成绩位列第一,可商用。
但「能下载」和「能自己跑」是两回事。这篇不吹参数,只说人话:它靠什么撑起 1.6 万亿,百万上下文实际能干嘛,多模态又解决了什么问题,以及你家那台电脑能不能碰。
能下载,不等于能自己跑
开源的意思很实在:权重和代码放出来,谁都能下。但下回来以后呢?1.6 万亿总参数,光把模型文件读进内存,就不是普通笔记本接得住的活儿。
这是我想先泼的一点冷水:开源解决的是「有没有」,不解决「跑不跑得动」。两件事常被混着说,混完就容易失望。
顺带说一句,LongCat-2.5 是多模态模型,文字和图像都能吃。听着新鲜,但它不降低硬件门槛——图像输入叠上长上下文,资源消耗只会更凶。
1.6万亿参数,一屋子专家
1.6 万亿听着像天文数字。但关键在另一头:每 Token 只激活 480 亿。模型走的是 MoE,也就是混合专家路线——全量参数很大,每次推理只叫一小部分上场。
打个比方,一屋子专家坐那儿,开会不用全员到齐,每次只叫相关的那几个来。人还是那屋人,但每次开会的开销小得多。
所以「1.6 万亿」不等于「每次都要算 1.6 万亿」。部署成本没有数字看着那么吓人,这也是大模型厂商普遍爱用 MoE 的原因。
判断一个 MoE 模型贵不贵,别只盯总参数。总参数决定它「装了多少知识」,激活参数决定它「每次干活出多少力」。这两个数分开看,账才算得清。
百万Token上下文能装下什么
百万 Token 上下文,通俗讲就是一次能「读」进去的东西特别多。一本厚厚的专业书、一整个中型代码仓库,可以整本整仓喂进去,让它从头看到尾再回答你。
适合的场景很具体:长合同比对、研究报告提炼、在大型代码库里找调用关系。这类活儿以前得切块喂、反复追问,现在一次到位。
但我的判断是:日常聊天、写个通知、改两句文案,用不上这么长的上下文。为用不上的能力付硬件钱,不划算。
另外提醒一句,上下文长不等于记得牢。百万 Token 是「能塞进去」,塞进去之后中间部分会不会被忽略,得按自己的任务试过才算数。
四项测试第一,别当绝对真理
官方口径是四项公开测试成绩位列第一。听着提气,但评测得看口径:哪四项、对手是谁、题目怎么出,都会影响「第一」的含金量。
我更看重另一个数:据同一报道,它的 OpenCode 代码库累计 Token 用量已经破千亿,1090 亿 Token。这是真有人在持续用,比榜单实在。
评测口径厂商心里都有数。公开榜单一向挑对自己有利的科目报,所以「四项第一」值得听,但别拿来跟别家模型简单比高下。
所以我的态度是:榜单看一半,真实用量看另一半。官方说第一,我信;信的是「它不弱」,不是「它最强」。
先看适合谁,再看不适合谁
适合:天天跟长文档打交道的,比如法务、研究、咨询;维护大代码库的技术团队;想做多模态应用的创业公司。官方说了可商用部署,拿它当底座,方向是对的。
反过来,如果你的活儿就是每天处理几十页 PDF、十几万行代码,那这类模型省下的时间,可能比云账单更值钱。
不适合:日常聊天、做图、写周报的普通用户,能力过剩;没有云资源或 GPU 预算的个人玩家,硬件门槛是真高。
冷水:开源不等于免费跑
开源不等于免费。权重公开了,但推理 1.6 万亿的模型,哪怕每次只激活 480 亿,显存需求也不小;百万上下文更是内存大户。个人电脑跑不动,基本得靠云,云上的账是持续的。
还有社区的成熟度。新模型刚开源,部署文档、踩坑帖、工具链适配都得等市场慢慢补齐。急着上生产,容易卡在没人踩过的坑里。
还有个现实问题:商用授权。官方说可商用部署,但具体条款——能不能闭源打包、能不能改名卖服务——得逐条读许可协议,别看到「可商用」三个字就上线。
想试的话,建议很具体:先去官方仓库把部署文档读一遍,再拿一个小模型跑通自己的场景,确认需求真实存在,再考虑 LongCat-2.5。别一上来就冲最大的。
一句话收尾:1.6 万亿是真本事,但你的场景值不值得为它买单,才是真问题。

