
先把结论放最前面:同时开三个 AI 写同一件事,结果更乱,不是你运气差,是你把「并行」当成了「协作」。论文给的答案很干脆——同样的算力,分成多个共享笔记的小组,比堆成一个大组更管用。
再收紧一点:多智能体的胜负手是结构,不是数量。下面把这个结论拆成三个能单独检验的变量,再给一份能直接照做的分工清单。
我上周碰到的那件怪事
上周要写一份产品说明的开头,我图省事,同一个提示词同时丢给三个 AI,让它们各写一版,我再挑最好的一版。听起来是标准的「三个臭皮匠」。
结果是三版风格互不相容,术语各叫各的,我挑完还得手动统一口径。花了三倍时间,得到零点八份稿子。更乱的不是文字,是我自己——我得同时记住三套逻辑。
我起初以为是模型不行。后来发现不是:三个 AI 各自都写得不错,它们乱在我这个「人肉总线」上——所有信息都要从我脑子里过一遍,而我带宽有限。
把「更乱」拆成三个能验证的假设
与其抱怨,不如把它当成可测的事。我拆出三个假设:一,如果三个 AI 拿到同样的信息预算,乱是因为它们没共享;二,如果它们能往同一份笔记里写字,重复劳动会减少;三,如果有台机器能给每版稿子打分,我就不必亲眼看三遍。
这三个假设对应三个变量:等算力预算、共享论坛、验证器。巧的是,Duke 和 Princeton 的那篇论文把这三个变量都动过一遍。
论文的设局方式:先让算力一样
这类比较最容易作弊的地方是算力。三个 AI 对三个 AI,谁多跑几轮谁就赢,那就测不出结构的作用。论文的第一步是把预算钉死。
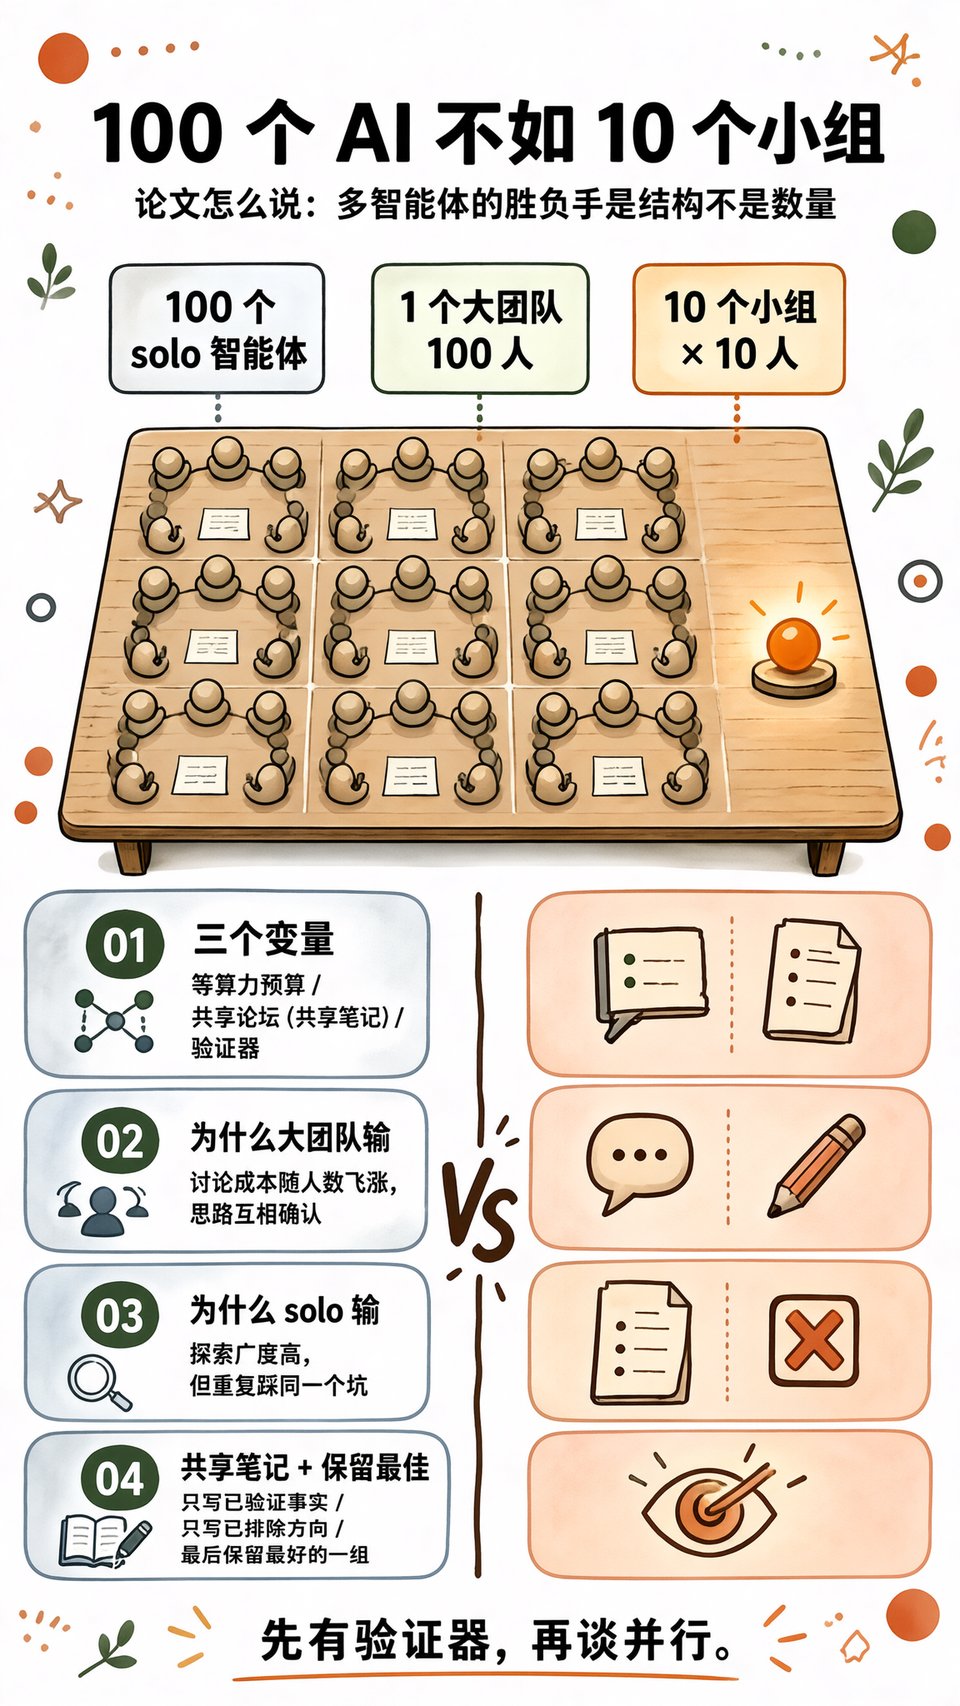
总预算给到 100 个智能体,然后切成不同形状。一种是 100 个单干的智能体,各自独立做完,最后取最好的一个(best-of-N);另一种是一个 100 人的大团队,全部塞进同一个协作池。
第三种才是重点:把 100 个拆成 10 个小组、每组 10 个,各组内部有共享论坛,组与组之间并行、互不打扰,最后保留最好的那一组结果。
结果:十个小组赢了两头
结果和直觉不太一样。10 个 10 人小组,每组带共享论坛、最后取最佳,同时赢了 solo 的 best-of-N,也赢了那个 100 人的大团队。
拆开看并不玄。100 个单干的智能体,探索广度拉满了,但每个都在重复踩同一个坑,产出 100 份互不相干的答案,你得花力气去捞。
100 人的大团队则相反:信息共享得最彻底,可每次发言都要被所有人消化,讨论成本随人数飞快上涨,最后大家挤在同一个思路上互相确认。
10 人小组是中间态:组内共享,把重复踩坑的损耗压下去;组间隔离,让十种不同思路同时活着。这是我的第一个判断——分工的本质不是人多,是给不同的假设留出互不干扰的跑道。
共享笔记为什么能省钱
共享论坛(说白了就是一份大家都能读写的笔记)在这个实验里不是便利贴,它是省钱的装置。
没有它,十个智能体各自重新发现同一件事:同一个接口的返回格式、同一个已被排除的方案、同一句已被否掉的措辞。这些重复劳动不会报错,只会悄悄吃掉预算。
有了它,第一个踩坑的人把结论写下来,后面的人直接跳过。代价是每次读写都要一点开销,所以论坛不能无限大——这正是为什么 10 人组的论坛有效,100 人组的论坛会堵。
通信成本与探索广度在抢同一笔钱
三个变量最后其实在争同一件东西:预算怎么分。给通信多一点,大家口径一致、重复劳动少;给探索多一点,思路更多、更容易撞上对的答案。
团队规模就是那根滑杆。人越多,通信成本涨得越快,因为对齐几乎是两两之间的;而探索广度的边际收益越来越低。
论文给出的答案不是「越小越好」,而是「小到共享还便宜,多到思路还不重样」。10 这个数字别当咒语,它更像是那个实验里刚好落在甜点区的取值。
验证器是这套结构的前提
作者还有一句容易被忽略的建议:当验证器能给智能体的工作打分时,才把预算拆成多个共享笔记的小团队,并保留最佳答案。
这个前置条件很要命。多个小组并行的前提,是你能判断哪一组更好;如果验收全靠感觉,十个组只会给你十份都舍不得扔的稿子。
所以验证器不是加分项,是入场券。能自动打分的活(跑测试、过格式校验、算指标)最适合这套打法;只能靠人拍板的活,先把验收标准写出来再谈并行。
如果要验证,我会这么设
我没有跑过这套实验,所以下面只是设计,不是结果。要在我自己的写作流程里验一次,我会这么设。
变量一,预算:固定总调用次数(比如说 30 次),三种形状各跑一遍——30 个单干、1 个 30 人大组、5 个 6 人小组。除了形状,别的一律不动,否则测的还是模型。
变量二,共享:小组之间开一份共享笔记,只允许写「已排除的方案」和「已确认的事实」两类,避免笔记变成长篇讨论,字数上限也钉死,逼着大家写结论。
变量三,验收:开工前写死三条评分标准(事实有没有出处、结构是否完整、有没有废话),每版按三条各打 1 到 5 分,总分最高者胜。跑五轮取平均,别拿一轮定胜负。
还要记一项成本:不是 token 数,是我本人花的时间。三种形状各记一次,那张表通常比分数更说明问题。
怎么用:拆组、共享、验收
任务怎么拆:按「可独立验收的单元」切,不要按字数切。一份稿子的开头、中段论证、配图说明可以拆,因为它们各自能被单独判好坏;而一个论证的两半拆开就散了。
拆完给每组一个明确产出物和一句边界:写什么、不写什么、跟谁不重叠。组与组之间不共享中间稿,只共享结论,否则等于把大团队搬回来了。
笔记怎么共享:只写两类内容——已验证的事实(带出处)、已排除的方向(带一句为什么)。禁止在笔记里讨论,讨论留在组内。
怎么定验收标准:三项以内,每项可判真假,开工前写死。先按硬指标筛掉不合格的,再在剩下的里面挑,别一上来就凭喜好选。
工具侧也在往这个方向挪
一句话的参照:Anthropic 的 Claude 在发布当天就把办公套件(Sheets、Whiteboards、Data)推向团队协作场景。工具在往「多人加多智能体一起干」靠,结构问题会越来越常见。
也意味着以后判断一套 AI 工作流好不好,不能只看它调了多少个模型,得看它怎么分组、怎么记笔记、怎么验收。调用数是宣传页上的数字,后三样才是你每天要面对的东西。
我的判断
第二个判断:多智能体的瓶颈通常不在模型,在协调。模型能力是买来的,协调结构是设计出来的;前者加钱就有,后者加钱只会更乱。
第三个判断:能自动验收的任务会被拆得越来越碎,只能靠人拍板的任务会继续留在一个模型手里。因为并行的收益,全靠「能判断哪个更好」这一件事来兑现。
回到开头那三个 AI。它们不是不该并行,是我少做了三件事:没给共享的笔记,没写死验收标准,也没让它们彼此不重叠。数量我加对了,结构全错。
所以下次再想「多开几个 AI 会不会更快」,先问一句:它们的笔记在哪,谁来打分。这两问答不上来,开三个和开一个的区别,只是你更累。

