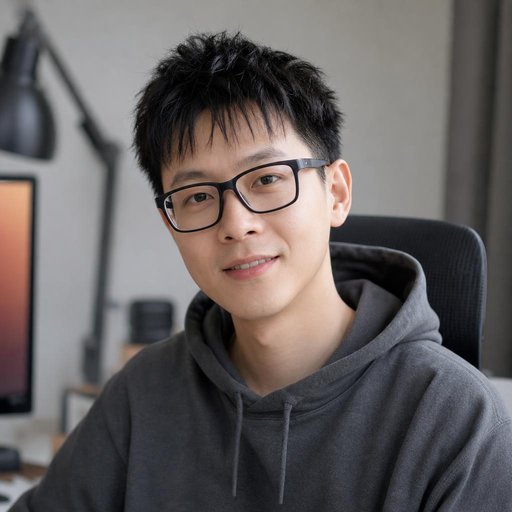
结论先摆在最前面:Gemini 4 Carbon 确实是这一轮最能扛复杂活的编码模型之一,但它不是「更聪明的 Gemini」,而是一台愿意多想几步、也愿意多烧几倍钱的机器。所以真正该问的不是它强不强,而是你手上这活值不值这个价。
先说清楚这 9 美元是怎么来的
谷歌 11 月 10 日正式开放了 Gemini 4 Carbon。官方的定位很明确:它是 Gemini 4 Argon 的补充,不是替代品,主攻复杂多步编码、调试、开放性科研和网络安全这类硬活(据 The Decoder)。
麻烦的地方在于价格结构。两者 token 单价相同,但 Carbon 在推理阶段会消耗更多 token,所以实际总成本可能更高(据 The Decoder)。单价一样,账单不一样,这个差别后面会反复出现。
Cursor 已经宣布接入 Carbon。它的高努力档位在 CursorBench 上以 60.4% 排到首位,官方配图里给出的成本是 9.22 美元(据 Cursor 员工的 X 帖)。所以「9 美元」不是一个标价,是一次高努力任务的账单。
我这周把它塞进两个日常活里
上个周末整理旧项目时翻出一堆半死不活的脚本,我索性拿 Carbon 试了两件平时最烦的事:一件是把一个老脚本层层嵌套的报错链路理清楚,另一件是给一份结构混乱的数据文档补测试用例。
第一件事它做得漂亮,中途没有绕回原点,读完报错就能顺着调用关系往下走。第二件事我把档位调到了高努力,它想的东西明显比我要的多,输出的方案比我自己动手还细。
这里要说清楚:我没有跑分,也没有截图对账。我看到的只是体感——它花的思考时间和它给出的东西,大致是匹配的;而这两件活的差别,恰恰决定了该不该请它出马。
它到底强在哪,强得值不值
Every 的 Vibe Check 评测给了一个挺具体的描述:Carbon 的编码能力明显强于 Argon,能生成立体度更好的 3D 物体,而且可以少监督地连续工作几个小时。最后半句才是关键。
ARC Prize 也已经把 Carbon 的 ARC-AGI (Verified) 成绩收录进了排行榜(材料里没给分数,我就不替它报数)。上不上榜说明它进了这个级别,说明不了它适合你手上的活。
我的判断是:它的强项不在「一次答得对」,而在「能连着干很久还不散架」。这对需要多步推进的任务是加分,对一句话就能问完的事是纯浪费。
判断力比智力更省钱
Every 的评测里还有一句更值得琢磨的话:Carbon 的判断力跟不上,它不知道自己该在什么时候停。编码能力强,但对「什么时候该收手」没有感觉。
放在聊天框里,这只是啰嗦。放在 agent 里,这是钞票。一个不会自己停的 agent,错的往往不是答案,而是它一直在花钱:多读几个文件、多跑几轮验证、多改几版方案。
所以我第一个判断是:在 agent 场景里,判断力比智力更省钱。会自己停下来、知道「这活已经够了」的模型,比一个更聪明但停不下来的模型更划算——因为账单是按时间乘以调用次数长的。
该用贵的:三类活
第一类是答错代价高的活。线上故障定位、数据库迁移脚本、发出去就收不回来的批量操作,这类事一旦错了,兜底要花的人力比模型费贵得多。这种活我不省。
第二类是需要连续多步、中间状态可以验证的活。重构一段老代码、补一套测试、把一份乱文档整理成结构,中间每一步都能对一下,它那点「能连干几小时」的优势才真正兑现。
第三类是一次性、做完就结束的开放性探索。摸清一个陌生代码库、判断某个技术方案行不行,你只做一次,贵一点没关系,因为它给你省下的是你本人的半天。
该用便宜的:三类活
第一类是高频重复的活:改字段名、统一格式、搬数据、写样板代码。这类事一周要做几十次,贵模型在这里的边际收益几乎为零,账单却是几十倍。
第二类是你自己已经有明确写法的活。模板、规范、现成的示例都摆在那儿,模型只需要照着填,这时候选贵的等于给填空题请了个专家。
第三类是对错一眼能看出来的活。翻译一段文案、生成一条正则、改一句注释,错了你扫一眼就知道,兜底成本接近零。顺带说一句,Arena 的数据显示 GPT-6.1 Sol 的成本大约是 Carbon 的 0.54 倍,这类活用它够用。
按任务算钱,别按 token 算钱
Arena 的 Agent Arena 分析给了几个很能说明问题的倍率:典型任务下,GPT-6 Astra 的成本是 Carbon 的 3.4 倍,Claude Opus 5.5 是 3.9 倍。而 GPT-6.1 Sol 大约只要 Carbon 的 0.54 倍。
更有意思的是极端情况:在最难、成本最高的那 5% 会话里,Carbon 的成本优势反而更明显。也就是说,活越难,它相对越划算;活越简单,它相对越贵。这跟大多数人的直觉是反的。
所以我第二个判断是:记账单位要换成「单次任务成本」,而不是「每百万 token 多少钱」。给每类活记一个平均单次花费,一个月下来你自然知道哪类活该派谁去,单价对比只能拿来砍采购价。
具体做法不复杂:把手上活分成硬骨头、常规活、重复活三档,各挑一件记下花费和返工次数。两周就够看出规律,比任何榜单都贴近你自己的钱包。
同一天还有另一条消息
11 月 10 日这天,Anthropic 给所有 Pro、Max、Ultra、Team 用户发了一次免费的全量额度重置,额度在 12 月 10 日前可用,界面也改成了显示确切的到期时间。
这条消息和 Carbon 没关系,但指向同一件事:额度是有保质期的资源。把那点免费额度当成配额用,专门留给答错要花大力气兜底的活,而不是当成默认选项随手消耗。
适合谁,不适合谁
适合的人:每天都要啃硬骨头、返工一次就要赔上半天的开发者;在做多步 agent、宁可多花点钱也想让它少跑偏的人;偶尔要摸陌生代码库、只想一次问明白的人。
不适合的人:日常主要是改文案、调样式、搬字段的人;预算按次计算、每次调用都要交代清楚的团队;以及把「最强」当成默认选项、从来不记单次花费的人。
最后一句实话:Carbon 值不值 9 美元,取决于这 9 美元替你省下了什么。省下一整天排障,它便宜得离谱;只省下十分钟改字段,它贵得没道理。模型不分贵贱,活分。

