
新闻里经常出现两个词:训练、推理。听着像同义词,其实是两件完全不同的事,成本差着几个数量级。
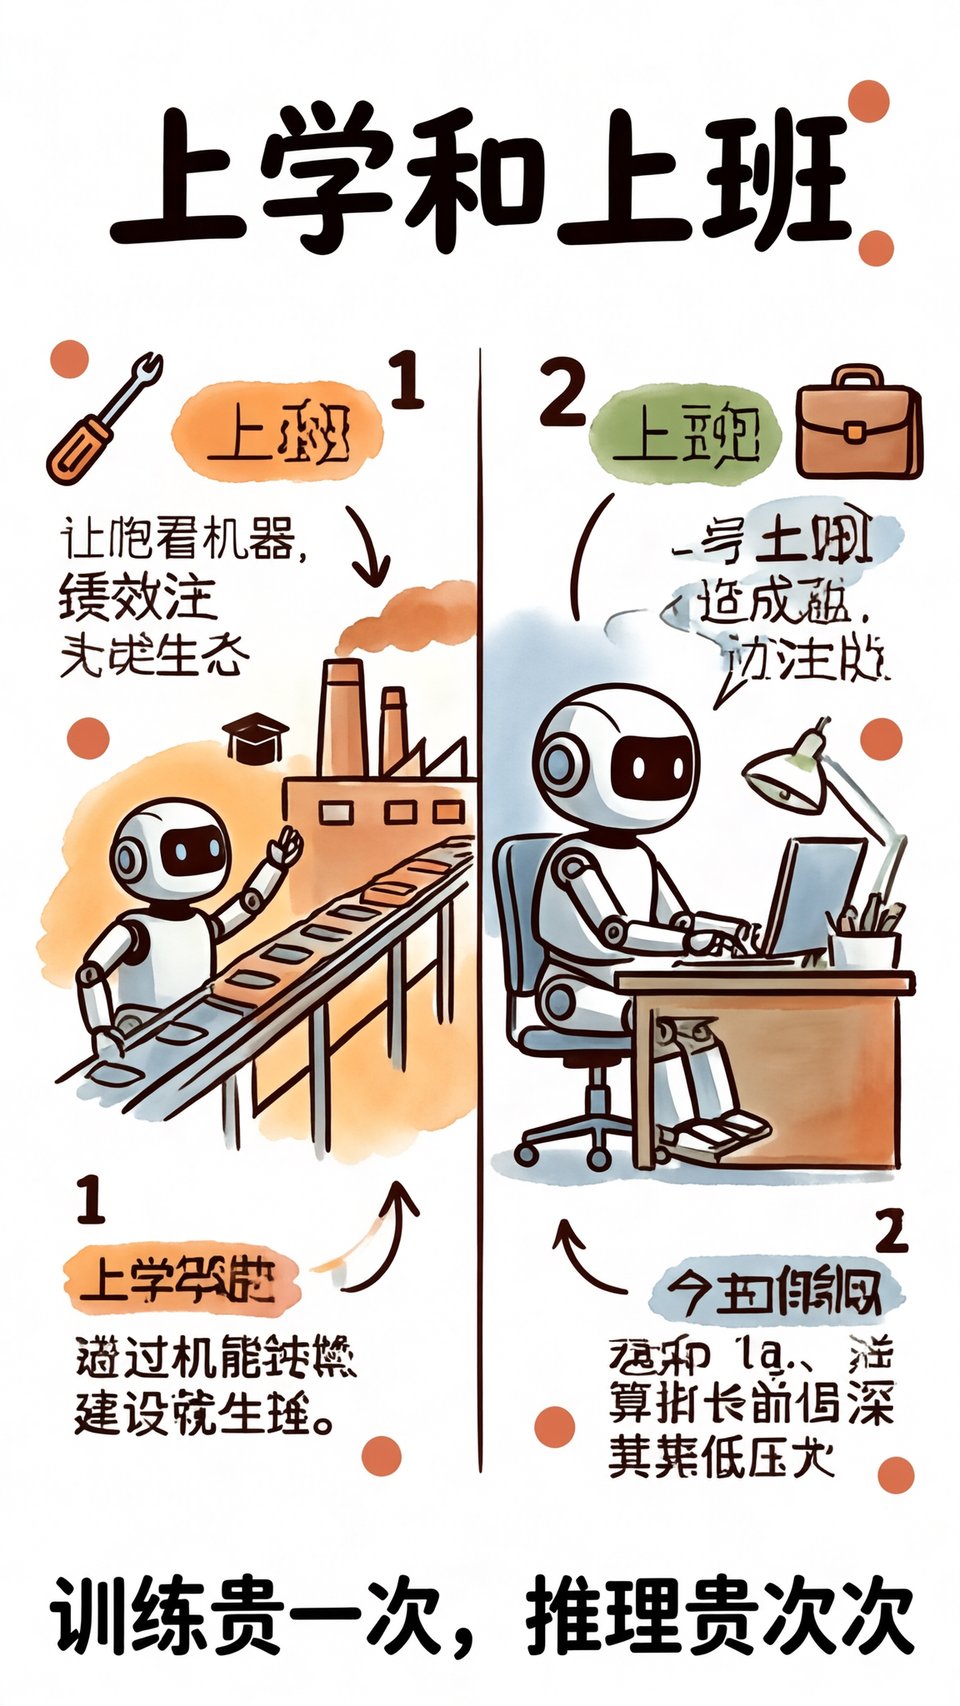
训练:花几个月,烧几千万,造一个「毕业生」
训练就是 AI 的"上学"。
把海量文字喂进去,让它一遍遍猜下一个词,猜错了就调参数。这个过程要走几十万亿个 token,用几千张显卡同时算,跑上一两个月。
花多少钱?一个像样的大模型,一次训练的硬件和电费,动辄几百万到几千万美元。这也是为什么全世界只有少数几家公司玩得起。
训练完的产物,就是一批"凝固"的参数文件。这个文件就是模型本体,可以下载、可以拷贝、可以塞进硬盘。
关键点:训练是一次性的、昂贵的事。模型训练完就定型了,你不重新训练,它不会自己变聪明。
推理:每次回答,都在花小钱
推理就是 AI 的"上班"。
你输入一句话,模型跑一遍计算,吐出一段回答。这一遍就叫一次推理。
推理很便宜,单次几分钱甚至几厘钱,但架不住次数多。一个日活千万的产品,一天推理上亿次,账单就是天文数字。
关键点:推理是持续的、按次计费的事。用户越多、用得越久,花的钱越多。
为什么这个区分重要
因为行业里所有的商业故事,几乎都绕着这两件事转。
训练贵,所以模型公司要融资、要比谁的显卡多。新闻里"某公司采购十万张卡",说的就是训练和推理的基建投入。
推理贵,所以产品公司要想办法优化:用更小的模型、更快的芯片、更省的调用方式。你看到的"价格又降了三成",基本都是推理侧的优化。
还有一个词你可能听过:微调。它是在已经训练好的模型上,用小规模数据再教一教,成本比从头训练低几个数量级,效果是让通用模型更懂你的行业。后文单独讲。
一个类比记住这两件事
训练 = 供一个学生读到大学毕业,花二十年、几十万。
推理 = 这个学生毕业后每天上班干活,按天发工资。
学生只有一个,但活可以一直干。所以模型公司卖的不是"模型",是"让学生干活的时间"。
普通人用得上的两点
第一,你付的钱,99% 花在推理上。所以想省钱就优化"用"的方式,跟训练没关系。
第二,别信"用了就越来越聪明"。模型不会因为跟你聊得多就学会新东西——除非厂商拿你的数据重新训练,那是另一回事,而且通常要你同意。
一句话带走
训练是一次性造人,推理是天天用人。
前者贵在门槛,后者贵在规模。
看懂这个词的区别,一半的 AI 商业新闻你就能读懂了。
下一篇:AI 幻觉——它为什么一本正经胡说八道,怎么一眼识破。
