
你问它菜谱,它答得头头是道。你问它写代码,它真能写出能跑的。你问它安慰人,它比某些朋友还会说话。
一个软件,凭什么什么都会?
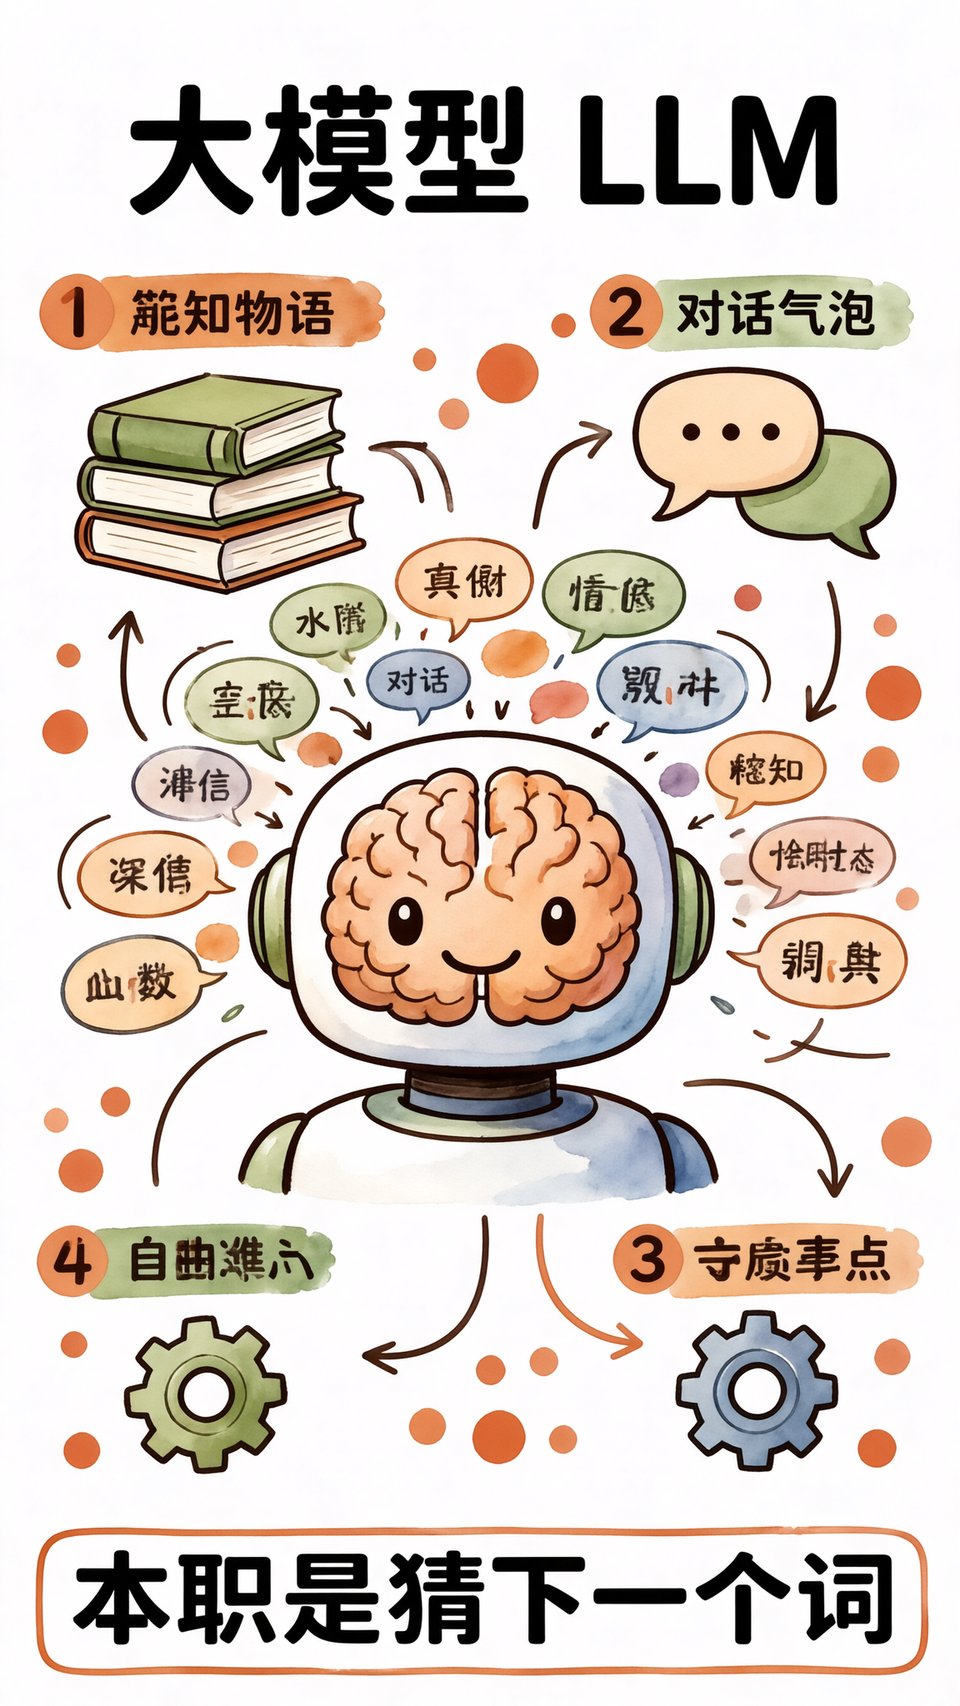
答案可能让你有点失望:它的本职不是"回答问题",而是猜下一个词。就这一件事,做到了极致。
它的正经名字:大语言模型
大语言模型,英文 Large Language Model,缩写就是常说的 LLM。
拆开看三个词。语言——处理的是文字;模型——一堆参数构成的数学结构;大——参数多、喂进去的文字多。
它学的东西特别朴素:给定一段话,猜下一个词最可能是什么。
"今天天气真___",你会填"好"。它干的也是这个,只不过它读过的东西多到吓人——书籍、网页、论坛、代码、新闻,人类公开在网上的文字,几乎都进了它的"肚子"。
读得多,猜得准。猜得准到一定程度,就长出了我们现在看到的各种本事。
它怎么从"猜词"变成"会聊天"
光会猜词,那只是个高级输入法。它真正翻身,靠的是第二步:学会"接话"。
训练的时候,人类把海量的"问—答"配对喂给它,还专门雇人标注哪些回答更好、哪些更差。它慢慢就摸清了规律:你问一件事,什么样的回答让人满意。
于是它学会了顺着你的话往下接,接得像个懂行的人。写文章、改代码、做总结、翻译——本质上都是"接着往下写"的不同姿势。
为什么它会一本正经地胡说
因为它的目标从来不是"说真话",而是"说下去像真的"。
它没有查证的习惯,也不知道自己哪句有把握、哪句在瞎编。它只是按概率往下接,接到一个通顺的句子为止。
所以它编起假人名、假论文、假法条来,语气跟真的一模一样。这个毛病有专门的名字,叫幻觉,这个专题后面单独讲。
这也是为什么:把它当"懂行的助手"用,别把它当"百科查证工具"用。
普通人该怎么理解它
说三句实在的。
第一,它是个读过很多书的聪明人,但没上过班。知识和表达它都有,具体到你的行业细节、你公司的规矩,它不知道。
第二,它不会主动想。你不问,它不说;你问偏了,它就顺着偏的方向答。它是镜子,你给什么它照什么。
第三,它记性有限。一次对话能记住的东西有上限,聊太长了它会"忘"前面的事。这个也有专篇讲,叫上下文。
一句话带走
大模型不是知识的仓库,是个把"接话"练到极致的天才。
它强在表达、归纳、模仿、改写;弱在查证、算数、记长期的事。
知道这个分界线,你就知道什么活放心交给它,什么活必须自己盯。
下一篇聊:参数上百亿,就一定更聪明吗?那些数字到底在说什么。
