
翻开任何一个 AI 模型的介绍页,第一行几乎都是数字:70B、200B、671B。
B 是 billion,十亿。70B 就是 700 亿个参数。
数字越大越强吗?一半对,一半错。
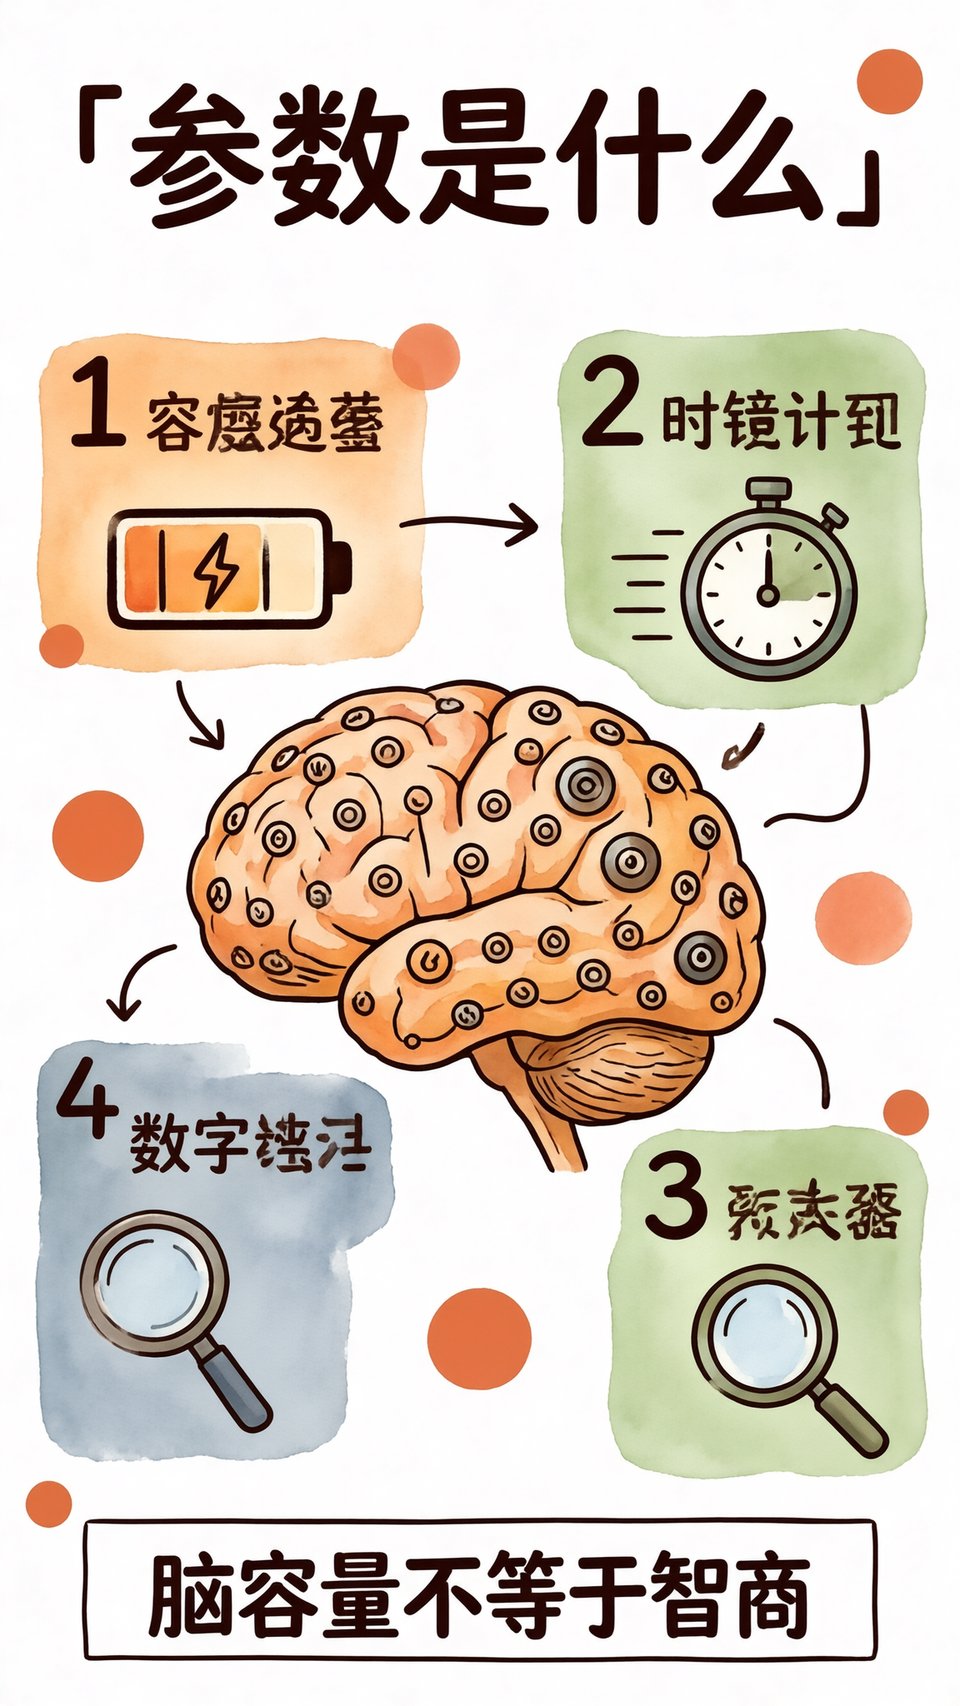
参数到底是个啥
你可以把参数想成模型脑子里的"旋钮"。
模型内部有几亿、几千亿个可调的旋钮,训练的过程,就是不断拧这些旋钮,直到它输出的话越来越像人话。
旋钮越多,能表达的东西越复杂、越细腻。所以参数确实跟能力有关系。
但旋钮多,不等于拧得好。
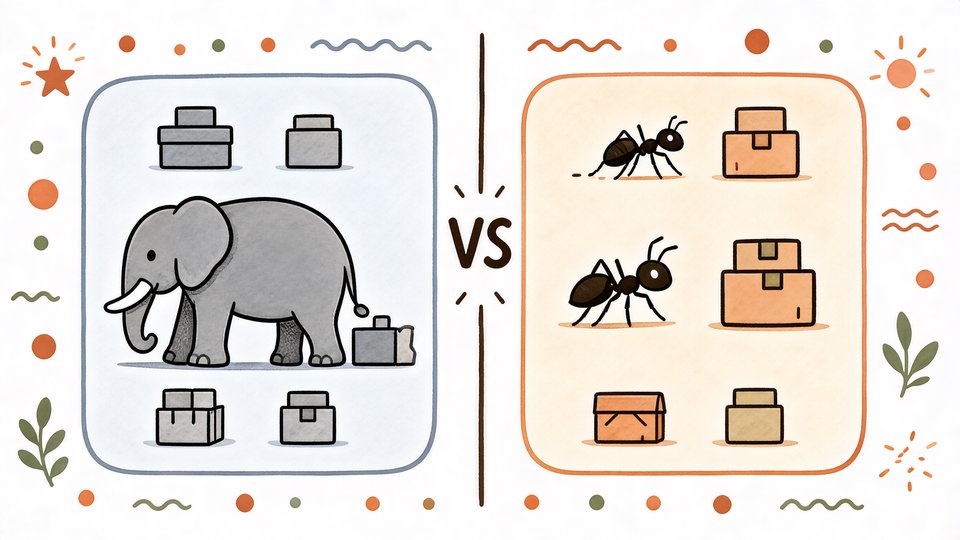
同样的参数,能力能差很远
有两个 700 亿参数的模型,一个考试能考九十分,另一个可能刚及格。
差在哪?差在喂给它的数据、训练的方法、后期的调教。就像两个学生脑子一样大,一个读了十年好书,一个刷了十年短视频。
所以看到参数数字,正确的反应不是"越大越好",而是"这只是个门槛指标"。
参数大,还有两个代价
第一个,吃硬件。旋钮多,跑起来就费显存、费算力。一个 700 亿参数的模型,想在自己电脑上跑,家用显卡基本没戏。
第二个,慢。同样一句话,大模型要想更久。手机上那种秒回的小助手,基本都是小参数模型。
这就是为什么现在流行"小模型":参数砍到几十亿,专门干某几类活,又快又省,够用。
那些字母缩写怎么看
现在市面上的模型名字越来越花,记住几个常见的就够:
- B:十亿参数。7B=70 亿,70B=700 亿。
- MoE:混合专家。看着参数巨大,但每次只用其中一小部分,所以又快又省。现在主流大模型基本都用这套。
- 量化:把参数从高精度压成低精度,比如 4bit、8bit。代价是一点点精度,收益是能塞进小显存。本地跑模型全靠它。
普通人判断模型的三个实在标准
别看参数,看这三样:
一,你手上的活它干得怎么样。找个你熟悉的题目亲自试,比看任何榜单都准。
二,跑得快不快、贵不贵。同样效果,响应快一半、价格便宜一半的,就是好模型。
三,更不更新。知识截止日期太老的模型,问它新闻全是过期答案。
一句话带走
参数是脑容量,不是智商。
同参数的两个模型,喂的数据和调教方法不同,能力能差出一大截。
挑模型别数零,拿你自己的活去试——试十分钟,胜过看十篇评测。
下一篇:Token 是什么?AI 的收费、字数和记性都绕不开它。
