一句话:艾伦人工智能研究院(Ai2)11 月 19 日接进科研 Agent 平台 Asta 的 Theorizer,干的不是回答问题,是提出假说——AI 头一次被摆到了「出题」的位置上(据 Ai2 公布,代码已开源)。
假说不是结论,实验才算数
划重点:论文里那个词翻译过来是「候选解释」,不是「发现」。它的最低门槛是可证伪——能被一次实验推翻,否则连假说的资格都没有。这个区别不是文字游戏,它决定了这东西该被当成线索还是当成事实。
真实案例能看出边界在哪。一位研究肺腺癌的肿瘤医生用它理出了 DREAM 复合体与 CDK2 之间的候选通路;一位神经科学家在 VIP 中间神经元文献里,一次拿到 50 个候选理论,而他原本只预期一两个(据 Ai2 公布)。他手上多出来的是一份「值得去试的清单」,不是结论。
还有秘鲁马铃薯中心的研究员,用它去翻气候重建数据里的异常值。异常值被指出来,不等于原因被找到——中间隔着取样、仪器、统计口径好几层,每一层都要人去核。
Ai2 反复强调这层边界:给的是假说提案,验证仍然是研究员的事。说白了,它交的是题目,不是答案。
拆开看:它到底怎么干活
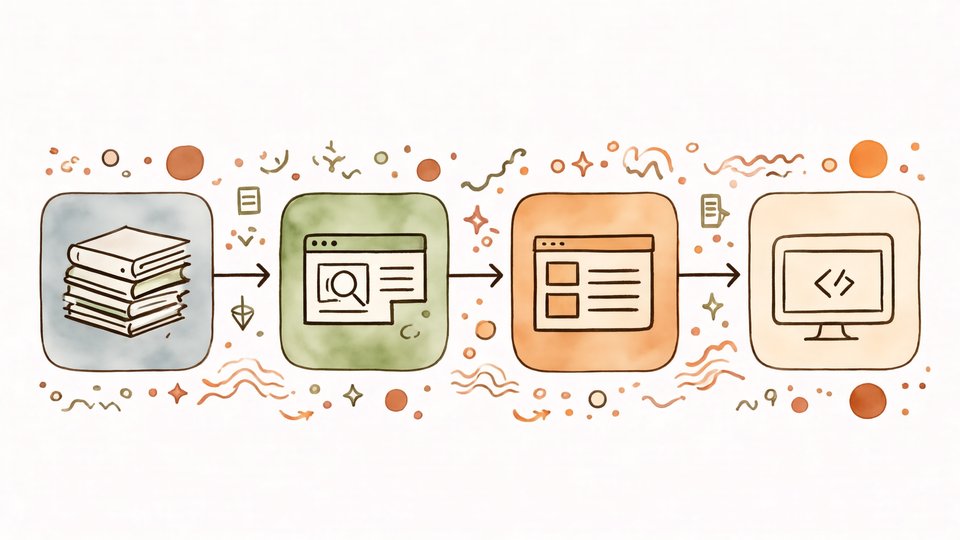
流程不复杂,三步:按研究问题检索文献,从每一篇里抽出关键发现,再把这些发现综合成带引用的候选解释。第三步里的「带引用」是关键——每一条假说都能顺着引用倒回原文,不是凭空冒出来的。
规模上有个数字值得盯:论文显示,这套方法用 13,744 篇论文合成了 2,856 个理论(据论文)。除一下,平均不到五篇文献撑起一个理论。这个比例说明它做的不是拼接,是归纳压缩。
同批开源的还有 AstaBrief 8B,写带引用的研究报告比基于 Claude 的方案快 3.5 倍,用户认可度相当(据 Ai2 公布)。速度这一项是硬指标,质量这一项只能说「相当」,不能加码。
顺带说一句,这两件事被放在一起并不偶然:一个负责把材料读成结论,一个负责把结论读成问题。前者提速,后者换方向。
为什么出题比答题更难
答题有标准答案,模型交完能被判对错,训练信号是现成的。出题没有这层监督——判断「这个问题值得问」,得知道领域里哪些路已经被堵死、哪些方向还没人碰过。这类判断过去只长在资深研究者身上。
价值也在这里。答案的边际收益在往下走:同一篇论文的方法,谁都能检索到,谁都能照做。而一个好问题能开出一条实验线,够一个课题组做上几年。问题比答案稀缺,这是学术圈的老规矩。
所以 AI 的角色确实挪了位置:从「你问我答」变成「我先递一批可验证的猜想,你再挑」。挑这个动作仍然在人这边,而这恰恰是最难外包的一步。
瓶颈只是换了地方
读文献曾经是硬瓶颈。一个人一年读几百篇就到顶,跨领域基本读不动。检索和抽取被机器接走之后,这条河道通了。
但实验室没有变快。细胞要养,动物实验要过伦理,临床要排期,一个循环按月甚至按年算。50 个候选理论摆在桌上,一个组一年能做的可能只有一个。前面那 49 个不是没用,是排不上队。
成本结构也跟着变了。读文献几乎零边际成本,做实验每一步都在烧钱烧人。前端无限加速、后端原地不动,整个系统的速度由后端决定。
所以「AI 让科研变快」这句话,目前只在文献这一环站得住。硬要说它改变了什么,是把瓶颈从「读不完」挪到了「做不完」。
普通人能抄的那套流程
把这套流程搬出实验室同样成立:先按问题检索资料,再从每份材料里抽关键结论,然后把结论综合成几个候选解释,最后给每个解释标出处。四步,一步都不能省。
写选题时最好用。先找 20 篇同类文章,抽出各自的核心判断,看哪几条互相打架——打架的地方就是还没人讲清的地方,选题从那里长出来,比凭空想靠谱得多。
做调研同理。结论必须能倒推回原文,做不到就是拍脑袋。带出处这条规则比任何提示词都管用,因为它逼着你承认哪句话是别人的、哪句话是自己的。
但这里有个前提:假说多了不等于科学快了。真正稀缺的从来不是候选答案的数量,而是能验证它们的实验台和愿意做验证的人。AI 把题库撑大了,判卷的仍然是我们。