画面里只有一只手。五指张开,停在桌沿上方,停了一秒,然后一根一根往下收,指尖先碰到杯壁,再稳稳把杯子端了起来。动作顺得像一个人做过很多遍。
镜头退开,你才看清那不是人的手:关节是金属,指腹上有传感器,手腕连着一台机器。这段视频由 NVIDIA 的 Jim Fan 发在 X 上,没有剪辑,一倍速播放。
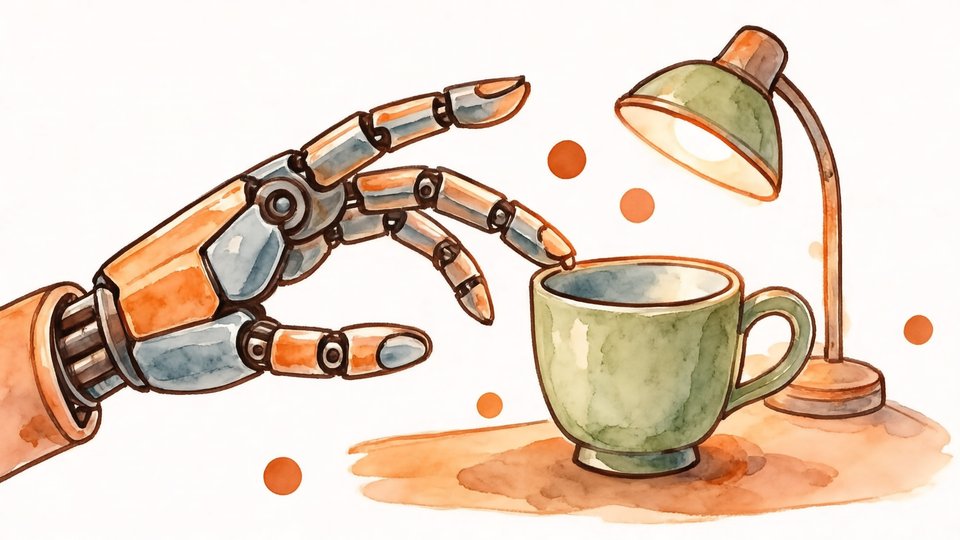
一只机器手在干活
视频里它在做的事,不是抓起一个方块再放下。它要按顺序走完一串动作:找准位置、调好抓握的力度、把杯子挪开、再放回原处。多步,连续,中途不能断。
多数机器人演示到抓起来那一步就收了。抓取是所有环节里最容易的一环,难的是后面那几十秒:东西在手里换了姿态,手指要跟着换用力方式,还要记住自己刚才做到哪儿了。
端到端,它自己看自己动
GR00T 2 的定位是开源的 System One 模型。System One 是行内对一类模型的叫法——不经过上层规划拆解,看到画面就直接输出动作,中间那层先想再做的代码它不要。
少一层转手,就少一次等待。杯子偏了一点,手当场就调,不必等云端算完再回话。这条路上省下的不是算力,是时间,而时间在灵巧操作里就是成败。
据 Jim Fan 的说法,它完全跑在机器人自身的机载算力上。这句话的分量比开源两个字重。车间里很多地方没有稳定的网,一台得靠云端才敢动的机器,本身就不容易被允许上岗。
五分钟里,一步都不能滑
材料里给了两个数字:二十步以上,五分钟以上。这两个数字放在一起,难度不是相加,是相乘。
五分钟的操作,中间要经历二十多次判断。这一次抓握的角度偏一点,下一次就得补回来;补不回来,整段任务就废了。短任务可以靠运气,长任务只能靠稳。
更麻烦的是手指。两根手指夹东西,只要一个闭合方向;五根手指要配合,每根都有自己的力度和时机,一根早到一拍,杯子就歪。人做这件事不用想,机器得一步一步算。
换一台机器,它还认这门手艺
另一条容易被略过的信息是 X-Adapt。人穿着设备采下来的动作数据,加上仿真里练出来的经验,可以零样本搬到不同型号的真实机器人上。零样本的意思是没在新机器上练过,直接上手。
在人身上采数据这件事,说起来轻,其实绕开了一道大坎。真机上直接练,撞坏一次就是钱;穿戴采集,摔的是人自己的动作,不是机器。数据先在人身上长出来,再搬给机器。
这一条决定了它到底是一个模型,还是一台机器的说明书。换一条产线、换一款手,重新采数据重新训练,成本比机器本身还高;能搬过去,才谈得上复用。
它会犯错,也会自己改
它还能跟前沿的 Agent 接起来。接上之后,机器不只是执行动作,还能在动作出岔子时判断这一步不对,然后退回去重来。
这件事在实验室里是加分项,在车间里是入场券。没人愿意守着一台一出错就得人工按停的机器。
我的判断很简单:机器能不能进车间,说到底不看它演示时多漂亮,看它出错之后能不能自己收拾。会重来的机器,人才敢放手。
为什么要强调没剪辑
视频下面标着未剪辑、一倍速。这不是废话。抽帧加速能把慢吞吞的动作放成一气呵成,剪辑也能把十次里成功的那一次挑出来。一倍速加上不剪,意味着你看到的那几分钟,就是机器真实花掉的几分钟。
这也是我愿意信这条消息的地方。看一个机器人灵不灵,先看它敢不敢让你看完整段。
当机器真的用手
很长时间里,工厂里的自动化更像是把人的手换成一个吸盘。吸盘好用,因为它只干一件事:吸住,放下。它不挑形状,可它也学不会新活。
真正的手不一样。手能拧、能捏、能托、能一边转一边放。这些动作过去只能靠人教,教得慢,一个人带一个人。现在有一段视频在说,机器可以自己学,学完还不必连网。
我不觉得这意味人手会退出车间。更实际的变化是,那些因为太碎、太杂、不值得上自动化而被搁下的工位,第一次有了被重新考虑的可能。
镜头回到开头那只手。杯子放下,五指慢慢张开,停在半空,像是在等下一件事。灯还亮着。