一句话:视频模型和机器人之间隔着的,就是「动作」这两个字,而 Runway 这次把它填上了。
据 The Decoder 与 Runway 官方消息,Runway 以 Apache 2.0 许可开源了 Praxis-1 的权重和代码:可商用,含微调代码,能在自有硬件上运行。对机器人圈来说,这是一条先学物理、再学动作的完整路线,不是又一个视频生成展示。
视频模型为什么能教机器人
先说个反直觉的点:教机器人最贵的是数据,而视频是最便宜的。真机器人采数据,得有人守着机器一条一条录;视频不用,人手上的活随手就能拍。据 hermes-ai.net 汇总,它训练的第一步是视频预训练,覆盖 12 类生成任务,底座是 Runway 自家的视频基础模型。
说白了,这一步学的是规律:物体怎么运动、手怎么抓握、任务进行到一半时画面长什么样。这些内容本来就写在视频里,不需要任何机器人参与,模型看完海量动作,先当了一回物理观察员。而且视频里什么都有:人搬箱子、车过减速带、机器换产线,全是带物理反馈的真实轨迹。
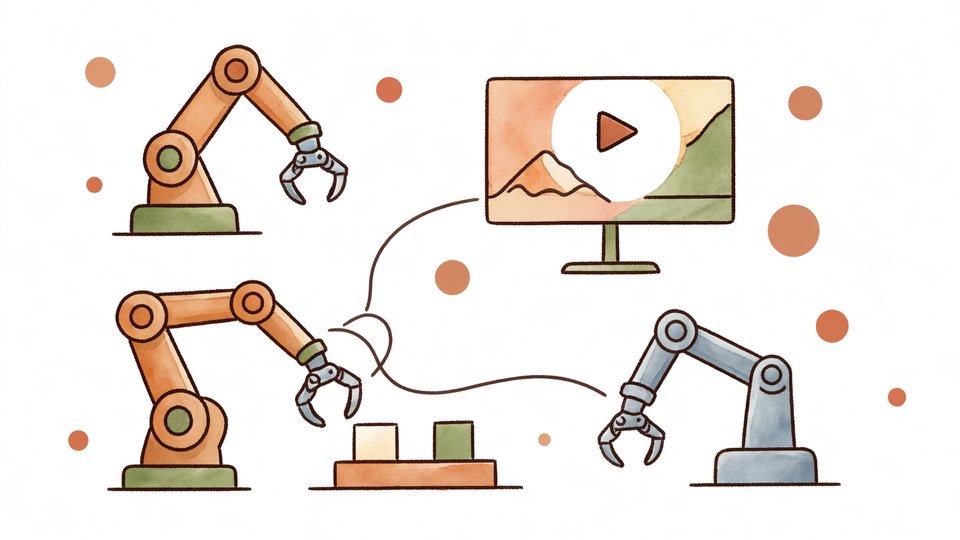
划重点,这一步的关键价值在跨本体。先在视频上学世界规律,换到机器人本体就有起跑优势:物体怎么动不依赖具体的机械结构,换了躯壳也认得。这也是它叫世界动作模型的原因,而不是又一个针对单一机械臂的策略网络。底座可以共用,躯壳随便换。
所以「视频是机器人最好的老师」这句话不夸张。数据便宜、覆盖广、天然带物理规律,视频等于一种免费的世界模拟器。机器人行业苦数据久矣,过去训一个策略网络,光数据这块就能吃掉大半年预算,这条路把最大的成本项直接砍掉了。
27B 的「世界动作模型」怎么搭
对数字较真的人看这里:Praxis-1 是 27B 参数的 MoE 扩散 Transformer:26.9B 视频骨干加 16 层动作专家,总计约 27.2B,但每个 token 只激活约 2.8B。说白了就是人多但轮流上班,参数存知识,激活省算力,实际开销比同规模稠密模型低一个量级。
训练的第二步,是叠加机器人专属训练,把视频预测学到的知识映射到物理动作上。运行时,模型同时读三样东西:相机图像、文本指令、机器人位置信息,先预测环境接下来会怎么变,再算出对应的控制指令。视频骨干负责看懂世界,动作专家负责决定怎么动。
对结构敏感的人还会注意到一个比例:总参数约 27.2B 里,视频骨干占 26.9B,16 层动作专家只是后挂上去的一小部分。视频知识是主体,动作是接口,接口换掉的代价不高,跨本体设计的底气就藏在这些数字里。
还有个细节容易被忽略:它最终输出的是控制指令,不是下一帧视频。视频预测在这里只是手段,动作才是交付物。这跟用视频模型当世界模拟器、再在模拟里搜索动作的路线不是一回事:那边要自己搭仿真、自己定义奖励,Praxis-1 是把视频知识直接压进动作生成,少绕一圈。
一张 80G 显卡就能跑起来
据 AI Weekly 汇总,Praxis-1 的 bf16 权重包约 54.4GB,一张 80GB 显卡装得下。注意,是装得下,不是跑得舒服——这个量级的模型,推理速度还得看具体怎么部署。但对实验室和个人研究者来说,门槛已经从机房级别掉到了工作站级别,不用排机房的队了。
再叠加许可条款:Apache 2.0,权重代码可商用,微调代码给全了,还能跑在自有硬件上。对研究团队来说,省下的不全是钱,更是时间——不用从零训底座,直接站在一个看过海量视频的世界模型上,做自己场景的微调。
顺带说句部署的现实问题:权重包只是内存账本上的下限,推理时还有激活开销,跑起来有没有富余,要看序列长度和批大小怎么配。这些工程细节官方没展开,等实测说话。真机上的抖动、延迟、失效模式,一个都躲不掉。
但这里有个前提
到这里,逻辑链摆齐了:视频预训练学物理,机器人专属训练映射动作,单卡可跑可商用。但这里有个前提:视频里学到的物理规律,落到真实机器人身上折损多少,公开材料里没看到系统的对打数据。跨本体有起跑优势没错,可起跑不等于撞线,视频是上半场,真机才是下半场,这段路还得拿真机数据验证。
还有一个更现实的问题:Apache 2.0 意味着竞品也能站在同一个底座上微调,技术领先的时间窗口不会太长。对 Runway 来说,这步棋的价值在技术影响力和路线卡位,商业账要另算。至于跨本体到底稳不稳、换个躯壳要补多少数据,看第三方实测就有答案。
把问题留给读者:视频教会了它见过的世界,可世界比视频大。新环境、新物体、没拍过的故障,模型全得现学。世界动作模型听着霸气,它到底能走出视频多少米,接下来几个月的第三方实测会给出第一轮答案。