把镜头对准湾区一间普通仓库,你会看到一列机器人正在货架间来回搬运。动作不算快,但每一趟都精准。大约一周前,Fortune 报道了一件事:把驾驭这些机器人当作本职的专门团队,被 OpenAI 解散了。解散本身只是一句话。同期的另一条线索是,公司的通用模型开始直接驱动机器人本体。两件事叠在一起,像一条只说了一半的新闻,中间的留白比报道本身更长。
一条只说了一句话的新闻
报道很短,细节很少。专门面向机器人的团队被撤编,官方的解释没有展开,团队去向也没有交代。真正值得看的,不是「谁走谁留」,而是这个动作本身的分量。机器人做了几十年,此前几乎默认要做一件事:给机器人单独训一套大脑。感知、规划、控制,各占一块,像给一台机器配一个专属的神经系统。这套路线的成本高、周期长,换一个场景就要从头再来。
OpenAI 没有否认这条消息,也没有像处理重大产品线那样发布长篇说明。它只是把团队拆掉,把位置让给了通用模型。行业里「通用模型驱动机器人」正在变主流——Google 的 VLA 模型上了产线,NVIDIA 的 GR00T 也在推进。这条新闻最冷的地方在于:它什么都没多说,行业却已经听懂了。
沉默本身就是一种信息。一家公司的解散动作,如果足够重要,通常会伴随解释;足够不重要,又轮不到媒体单独拎出来写。它被写了,但说得这么少,说明动作的分量不在解释里,在动作本身。撤掉一个专门团队,比发布一个新产品要克制得多,可它传递的信号,反而更干净:方向变了。
机器人不需要专属大脑了
过去给机器人训大脑,是典型的慢功夫。专用数据集要自己攒,控制策略要反复调,芯片、传感器、机械臂要层层适配。一套班子伺候一台机器,成本压在每一个项目头上。现在通用模型的能力爬到了那条线上:能读、能看、能规划,顺带把动作也接了过去。同一个大脑,既能陪人聊天,也能驱动机械臂抓取。
OpenAI 这次撤掉专门团队,等于公开站队:机器人不再需要一套专属大脑,而是和所有任务共用一颗通用大脑。Google、NVIDIA 的动作是「加」,往产线里塞新模型;OpenAI 的动作是「减」,把旧编制撤下来。一加一减,方向却指向同一处。专才的大门正在合上,通用模型的赛道正在变宽。
成本是这场拐弯最实在的推手。专有大脑意味着专属团队、专属数据、专属维护,每一样都是固定开销,项目一多就互相挤占。通用大脑把固定开销变成公共开销:模型训练一次,机器人、客服、代码谁都能用。钱花在一处,效益摊到各处,账面上先赢下的,是成本这一关。
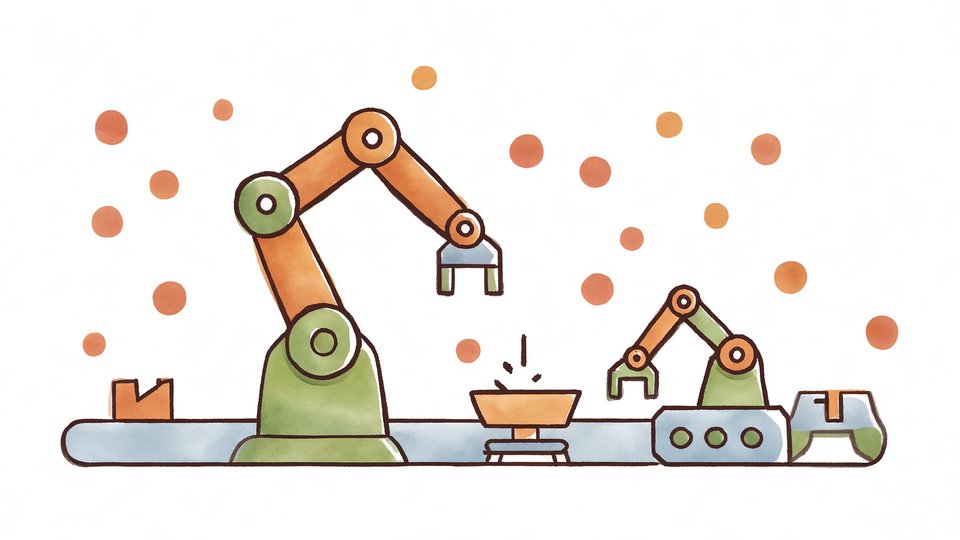
一条产线,一台通用机器人
产线变了。一台通用机器人站在工位上,没有专属团队在背后值守,一个模型同时处理语言、视觉和动作。新任务来了,看一遍演示、读一遍说明就能上手,不必为它重训一套系统。产线上的数据回流到模型,训练成本被摊薄,机器人从某个项目的专属资产,变成随时可以调用的通用工具。
但产线也有不讲情面的一面。通用模型的知识来自互联网,产线要求的是确定性:同一个动作,第一千次和第一次必须一样。机械臂的精度、安全冗余、故障恢复,这些属于物理世界的硬边界,模型管不到,还得靠硬件和工程兜底。软件向前迈了一大步,硬件的账仍然要一笔一笔算。
拐过一个弯,前面还有坡
给机器人训专属大脑的年代,眼看要翻篇了。通用模型接过方向盘,拐过了这个弯,但前面的路还有坡。对新入场者,门槛确实低了:通用大脑摆在明面上,不必再从零攒一套。竞争被推回两处——把机器造得可靠,把运行数据握在手里。谁能拿到真实的产线数据,谁就握着下一条产线的钥匙。
风险的账也要算清。通用大脑连着一整个知识网络,它知道的太多,产线只允许它做对。一次误判,在对话框里是一句废话,在流水线上可能是一次停线。模型擅长的是大概率,产线要的是零容忍,这两件事之间的缝隙,得靠一层层的安全约束去填。这些事,报道不会写,模型也不会说,只能留给时间去检验。镜头停在这里,不急着拉远。

