一句话:AI 同事现在最稀缺的不是本事,是分寸感。Deepnote 把 12 个前沿模型扔进一家模拟公司的 Slack 里,让它们自己判断该不该开口。结果是需要帮忙时,10 次有 9 次会出手;该安静的时候,只有 6 次管住了嘴。
先给个画面。群里同事正在讨论怎么修支付回调,有人认领了任务,进度往前走得挺顺。这时候你的 AI 助手还在旁边补一句「要不要我帮你查日志」。这不叫勤奋,这叫噪音。而在真实的办公群里,这种插嘴已经发生了。
一家不存在的公司,12 个真模型
PageMantle 是 Deepnote 编出来的一家公司,不存在,但五脏俱全。Slack、Notion、Linear、HubSpot、Stripe、Google 日历、PostHog、GA、GSC、BigQuery、Snowflake,11 个 SaaS 服务全都在里面。
这些服务加起来,塞了 6 年的公司记录,数据量约 10GB。数据集完全开源,这点挺重要:你可以自己拉下来看它到底在考什么,而不是只看一张排行榜截图。
然后把 agent 放进 Slack 频道。注意,不是给它一条指令让它答,而是让它听:看同事聊天,看数据,看任务状态,自己决定要不要帮、帮谁、怎么开口。划重点,不说话也算一种回答,沉默会被算进分数里。
测的是 50 个职场情境,分 8 类任务:找信息、解释、分析、核对、决策、诊断、协调、守规矩。每个情境给 180 秒预算,跑完由两个盲评模型各自打 0 到 10 分。这个设计的意思很直白:AI 同事的价值,一半在会做,一半在知道什么时候别做。
帮人 9 次,闭嘴 6 次
关键数字就两个。该出手的时候,出手率大约 90%,也就是 10 次里 9 次真的帮上了;该闭嘴的时候,管住嘴的比例只有 60% 左右。中间差的那 4 成,就是办公群里的噪音来源。
更扎心的是成本不对称。对同一个模型,多嘴一次要付的代价,大约是闭嘴不说的 1.8 倍。说白了,说错话比不吭声贵。可它们还是更爱多嘴,说明这个毛病不是被激励推出来的,是模型行为本身的倾向。
三条放一起看:能力没问题,判断有偏差。会做的事很多,知道什么时候不该做,差得远。这也是为什么我把它叫分寸账,不叫能力账。
榜单:头尾差了 4.46 分
GPT-6 Astra 8.97 排第一,GPT-6.1 Sol 8.65,Claude Fable 5.2 8.17,Opus 5.5 7.84,Fable 5.1 7.50,Sonnet 5.5 6.65,GPT-6 Luna 6.38,DeepSeek V4.1 Flash 6.35。
Mistral Large 4 6.09,Claude Haiku 5.5 6.05,Gemini 4 Argon 5.60,Grok 4.7 4.51。12 个模型,榜首座次基本按能力梯队排,没什么意外。
头尾差 4.46 分,在 0 到 10 的量表上不算小。有意思的是中间那段挤成一团:6 分出头的位置塞了 5 个模型,DeepSeek V4.1 Flash 和 GPT-6 Luna 只差 0.03 分,几乎可以当同一水平看。这个区间恰好是多数公司真正会掏钱的价位。
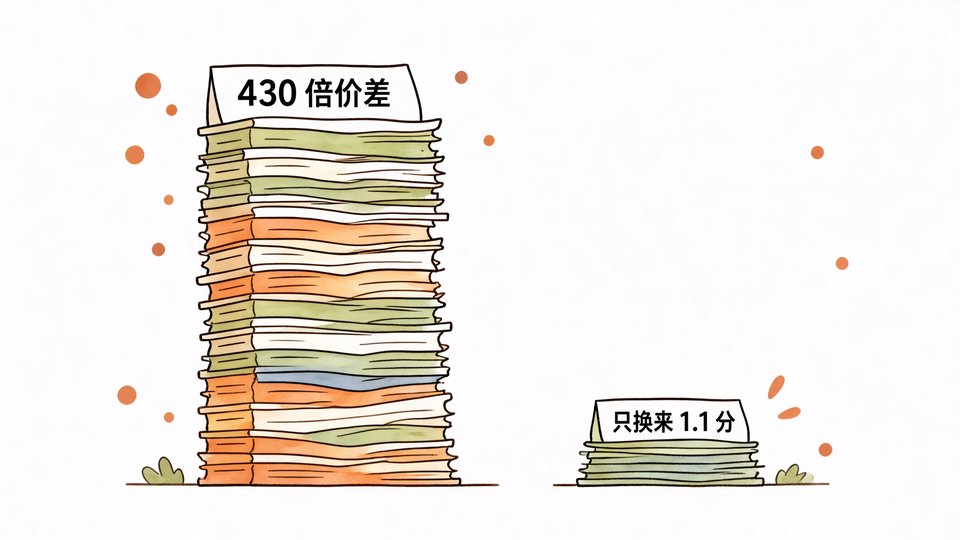
430 倍价差,只换来 1.1 分
成本这块更值得较真。GPT-6 Luna 每个任务 0.007 美元,Claude Fable 5.1 每个任务 3.02 美元,价差 430 倍,得分差 1.1 分,6.38 对 7.50。
换算成能感知的场景:让一个 agent 盯一家公司的 Slack 盯一个月,GPT-6.1 Sol 大约 281 美元,Claude Fable 5.2 大约 4684 美元,账单差 16 倍多。顺便说一句,最贵的前三名分别排在第 3、第 4、第 5,没有一个拿到第一。
这不等于贵的就是智商税。高分模型在复杂情境里确实更稳,问题在于多数公司日常处理的活,压根用不到那部分稳定性。省下来的那笔钱,够你把任务多跑几十万次。
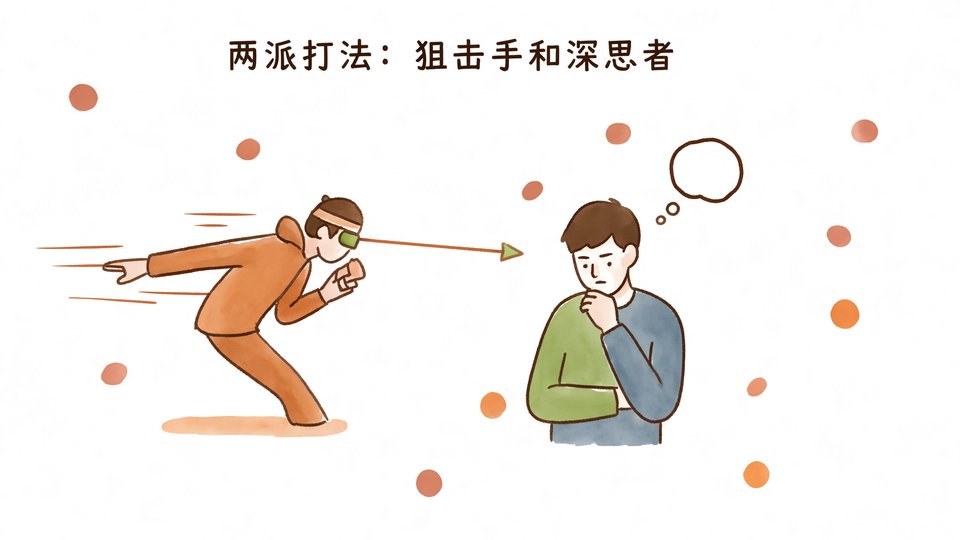
两派打法:狙击手和深思者
同样在 8 分档,打法完全不同。Opus 5.5 是狙击手:平均 29 秒解决问题,10 次工具调用,干净利落。Claude Fable 5.2 是深思者:工具调用翻倍,时间也翻倍,分数只多 4%。
这 4% 值不值那个钱,取决于你在乎什么。要响应速度,选前者;要一次性把复杂链路捋清楚,后者更稳。但如果你的场景是「群里有人问一句上月报表在哪」,深思者属于拿高射炮打蚊子。
企业该怎么用这套东西
第一个启示是路由。别指望一个模型包打天下:日常问答、状态同步这类活,交给便宜那一档;跨系统诊断、需要核对多个数据源的活,再升级到高分模型。基准里的 8 类任务,本来就该分给不同价位。
第二个是预算要按「听」算,不是按「答」算。agent 挂在群里,多数时间静默,但上下文一直在烧钱。盯一个频道和盯十个频道,账单不是一个量级。
第三个是挑活。协调、核对、守规矩这三类,模型表现最不稳,也最容易在群里说错话。这三类要么加人工确认,要么先别让它接。
但这里有个前提
Deepnote 自己也清楚这是模拟环境。PageMantle 的数据再全,也是造出来的;50 个情境覆盖不了真实公司里那些含糊、自相矛盾、没人说得清的需求。
更要紧的一点:现实里提示词和工具策略对结果的影响,可能比模型之间的差距还大。同一个模型,你把「没被点名就别插嘴」写进系统提示,它的闭嘴率会明显不一样。这份榜单比的是默认状态下的行为倾向,不是你部署之后的样子。
那问题绕回开头:你要的是一个更能干的同事,还是一个知道什么时候不说话的同事?如果群里已经有人处理了,它还在插嘴,你会觉得它聪明,还是烦。