先说结论:这波是省事的好消息
先说结论:DeepSeek 这波更新,对小团队和刚入手写 AI 应用的人来说,是实打实的省事好消息。官方在 11 月 13 日的更新日志里放出「全家桶应用 API」,把聊天 App 端的能力开放给开发者。
我翻了一圈官方文档,理解下来核心就一条:以前要自己拼的三件事,现在服务端全包了。对天天跟工具编排较劲的人,这比模型参数又涨多少都实在。
当然,价格和额度官方这次没细说,后面我会提醒。先搞清楚重点:你到底少了哪些活。
说得再直白点,以前你是在自己做装修,现在官方把水电都接好了,你只管挑家具。对写代码的人来说,这个差别就是几天的工期和一堆调试记录。
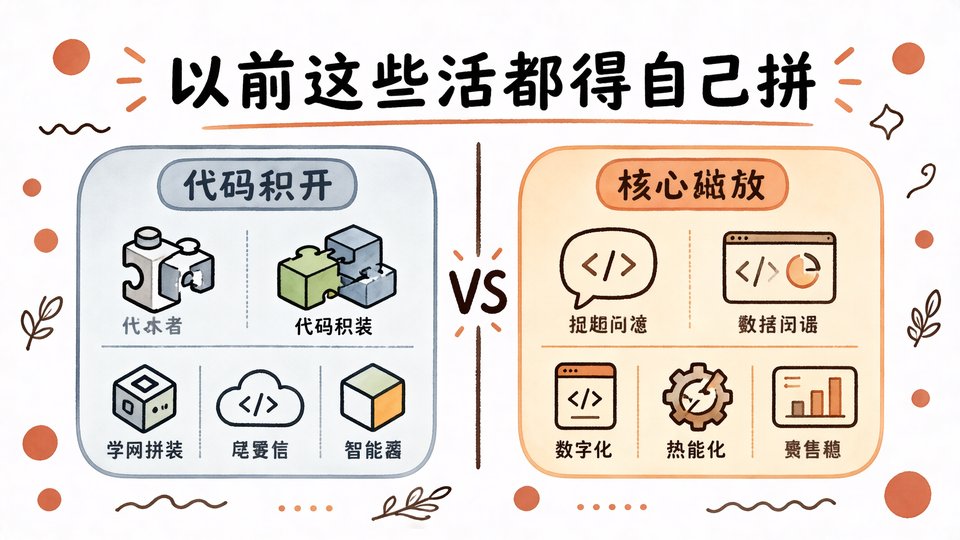
以前这些活都得自己拼
先还原一下没有这功能的日子。想让 AI 帮你查最新资料,得先接一个搜索 API,把返回结果整理好,再塞进上下文。想让 AI 读你上传的 PDF,得自己解析文件、抽文本,跟乱码和分页搏斗。
想让 AI 看一条链接,还得亲自抓网页正文,去掉广告和导航,清洗成能用的文本。最后按顺序把这些结果拼进对话里,顺序错了、内容丢了,回答就开始胡说八道。
这套流程有个名字,叫工具编排。很多人写 AI 应用最烦的就是它:代码量不大,坑却不少,每个接口返回格式还不一样。我见过不少项目,正事没干多少,光顾着拼上下文了。
我印象最深的是帮朋友做个小工具那回,光是把搜索结果的标题和摘要拼成一段话,就改了好几版。拼多了模型嫌啰嗦,拼少了又答非所问,来回调了一晚上。
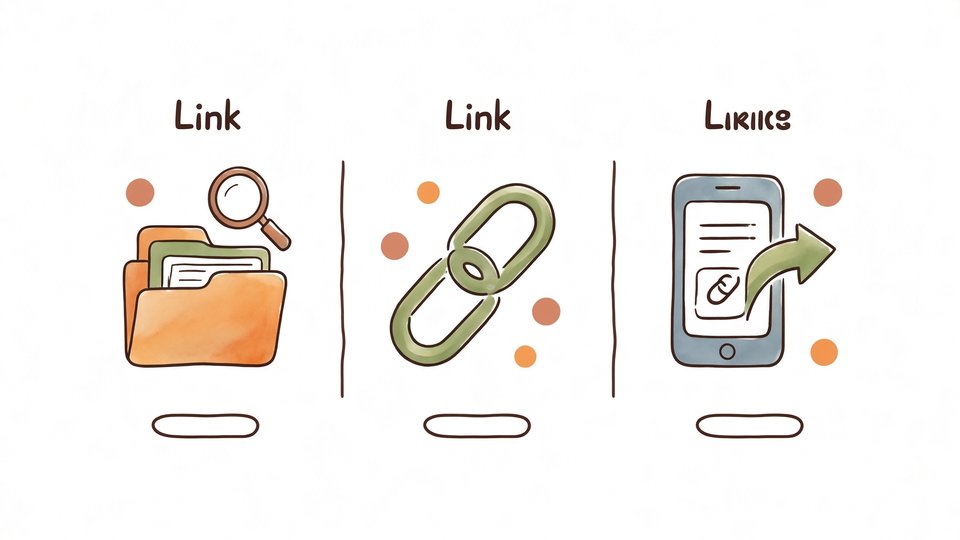
现在开个参数就有三件事
这波更新的做法很直接:在原有 API 上开启对应参数,联网搜索、文件输入、阅读链接这三件事就都有了。官方文档说得很明白,就是把聊天 App 里的对话功能开放给开发者,不用再造轮子。
对开发者来说,感知就是从关到开:搜索自己跑,文件自己能读,链接自己会抓。不用再研究搜索接口的翻页,也不用为文件解析写一摞兼容代码。
同批放出的还有 DeepSeek Harness 开发者预览版,向全球开发者开放测试。官方文档给了 curl 调 deepseek-flash 的示例,能用 thinking 和 reasoning_effort 参数。想折腾的可以先去试。
文件输入这块我也多看了两眼。官方没列支持哪些格式,只说开启参数后能读上传的文件,具体清单还得自己翻文档确认。这种留白不算缺点,但接之前最好先拿你的格式试一遍。
这活为什么该交给服务端
工具调用和上下文拼接由服务端完成,这一条才是重点。自己写编排最难受的不是代码,是出错很难发现:上下文拼错位置,AI 照样答得流畅,但内容就是不对。
这种错最隐蔽,也最费时间。官方代跑这套拼接,等于把最容易出错、最难调试的部分,从你的待办清单里划掉了。小团队省下的,是实打实的排错时间。
翻文档的时候我还注意过一点:官方对这块的描述很克制,没吹性能、没吹格式多全,就讲清楚什么归服务端管。没吹牛的更新,反而让人放心。
换个角度想,工具编排这活本来就不该每个团队各写一遍。搜索、解析、抓正文都是通用需求,官方统一做,出错概率和重复劳动一起降下来,这才是平台该干的事。
适合谁、不适合谁
适合做 AI 应用的小团队、独立开发者和刚入门的同学。你们最缺时间,把编排交给官方,能更快把想法变成能跑的东西。做内部工具的也合适,少维护一套拼接代码,少加几次班。
不适合对上下文拼接有极致控制需求的人。要做复杂多轮任务、要精细控制工具顺序的,服务端固定的编排方式可能不够灵活,你们大概率还是想自己写。
如果你已经有跑顺的编排,也没必要推倒重来。新功能是拿来省事的,不是拿来跟风的,按需开启就行。
想判断自己要不要开,可以翻翻最近一个月的代码:如果有一大段在做格式转换和上下文拼接,那基本就是目标用户;如果主逻辑都在业务上,开不开差别不大。
提醒两句再走
最后说句实在话:价格、额度、每个参数的具体细节,官方文档这次没细说。我翻了一下午也没找到完整参数表,所以别听人吹,一切以官网最新文档为准。
动手前建议先去官方更新日志和 API 文档确认,你要用的参数已经开放了,再决定接不接。文档没写清楚的部分,就是还没到能吹的时候。
这波更新最大的价值,是把最烦的编排活从你身上卸下来。功能看着不花哨,但干活的人知道,省事就是真香。有新参数我再跟你们说。