
一句话:「kernel 写错了」是遇报错时最省事的归因,而数据说明这个归因六成时候不对。
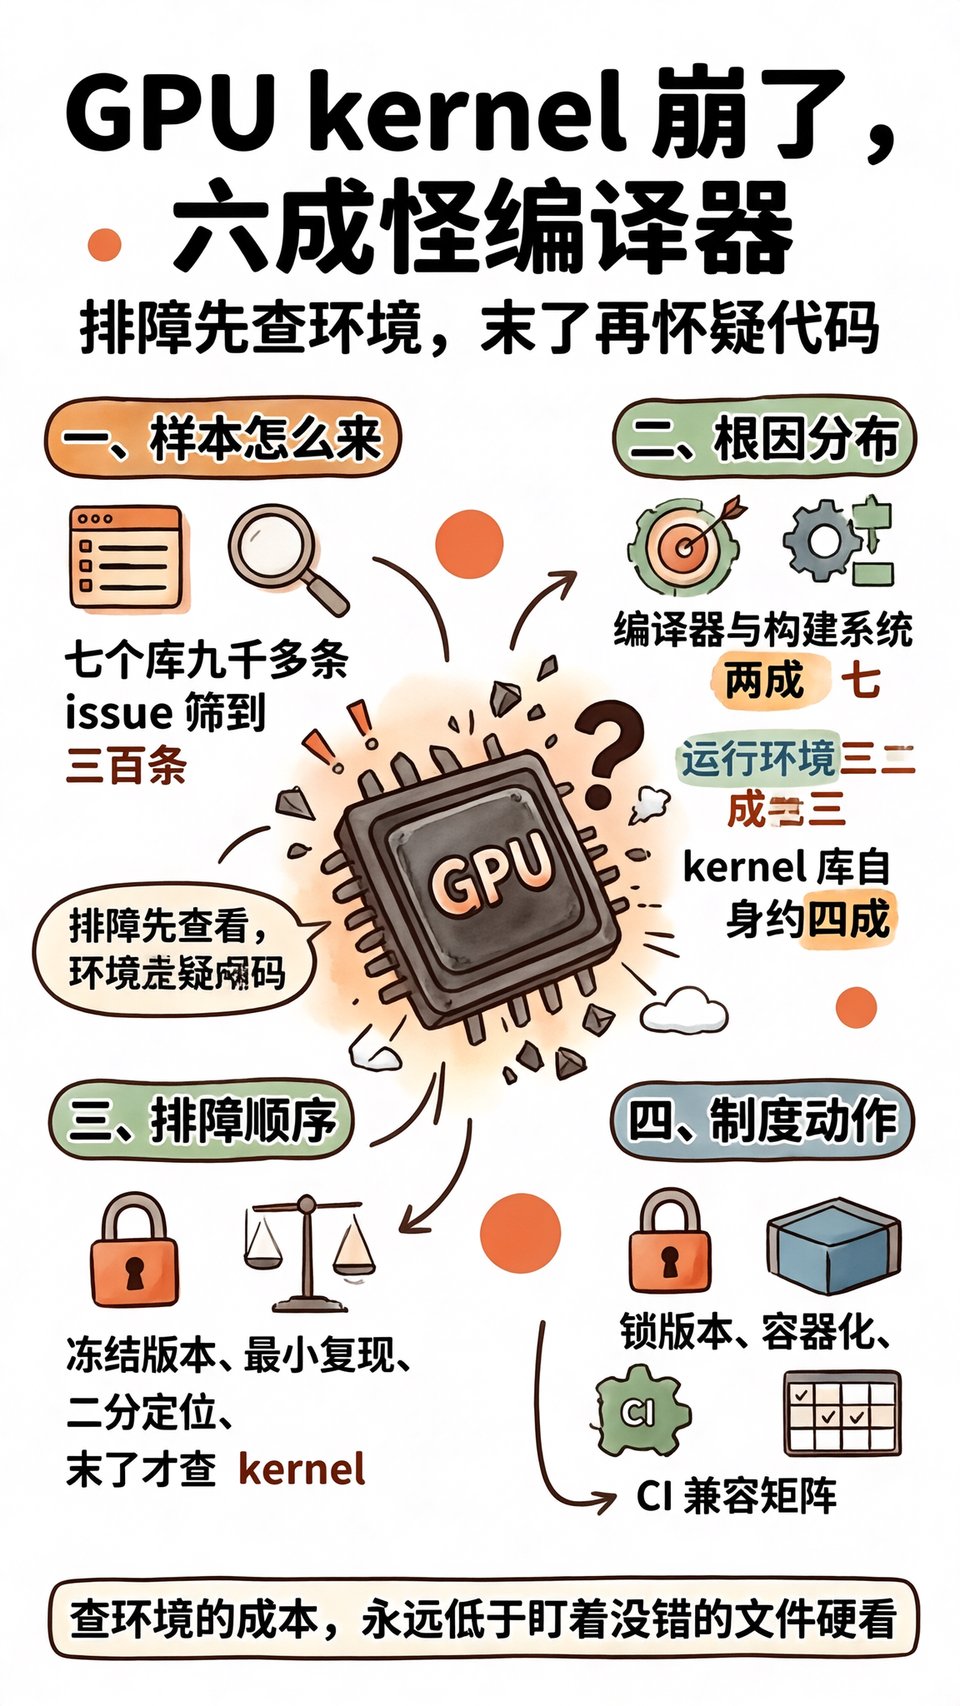
据微软与清华研究者发布的论文(arXiv 2611.09280),四位作者手动读完 7 个 GPU kernel 库的 300 条已关闭 GitHub issue,结论是 60.33% 的故障根源在编译器、构建系统或运行环境,kernel 库自身只占 39.67%。说白了,在你伸手改 kernel 之前,该先怀疑它外面那堆东西。
300 条 issue,是三道筛子筛出来的
样本不是爬虫随便抓的。研究者先从 7 个库里捞回 9,099 条 issue,按关键词和标签剔掉求助帖、功能请求、占位贴和跟踪贴,缩到 3,181 条候选;再逐条人工读标题、描述、讨论串、诊断证据,能追到修复的就追修复,留下 300 条。
这 7 个库是 FlashInfer、FlashAttention、Triton、CUTLASS、DeepGEMM、xFormers、bitsandbytes,覆盖 attention、矩阵乘、量化、GPU 编译几条主线。样本时间从 2015 年末到 2026 年中,跨了十年多。
症状归纳成 6 类,根因归纳成 15 类、再归进 3 个维度。人工读这一步很关键:光靠仓库标签,分不清一次崩溃是没装上、编译挂了,还是 kernel 算错了。论文把部署失败和构建失败单列出来,正是这两类最容易被误当成 kernel 的毛病。
真凶大概率在 kernel 外面
先把症状摊开:部署失败 82 条占 27.33%,构建失败 73 条占 24.33%,两项相加 51.66%。超过一半的报告,发生在 kernel 真正执行之前——装不上,或者编不过。
剩下的才轮到执行期:崩溃 63 条占 21%,功能错误 53 条占 17.67%,性能退化 23 条占 7.67%,挂起只有 6 条占 2%。划重点:一半以上的 issue,kernel 根本没机会跑起来。部署失败的口径又特别宽,安装、依赖解析、打包、链接、加载、导入、启动,任何一步断了都算,所以你很容易以为算子写错了,其实它压根没被加载上。
根因的账更清楚。编译器与构建系统占 27%,其中编译器转换出错 46 条、构建配置错误 35 条;运行环境占 33.33%,其中软件不兼容 76 条、硬件不兼容 24 条。两笔合起来 60.33%。
编译器那一侧有个很直观的案例。论文记录了一次 FlashAttention 的编译失败:升级 CUTLASS 的 DSL 之后,产出的中间表示不合法,SSA 支配关系对不上,编译在 IR 校验那步就停了;把 DSL 从 4.2.1 退回 4.2.0,问题消失。
最大单一根因:软件互相不兼容
76 条、25.33%,软件不兼容是 15 类根因里最大的一坨。GPU 驱动、CUDA 运行时、深度学习框架、操作系统、ABI,任意几样的版本排列组合都可能打架。
论文里有个典型例子:宿主机明明有 CUDA 11.6,调用却报错,结果一查,装的 PyTorch 是用 CUDA 11.3 编译的,不满足库的要求;换成 CUDA 11.6 编译的 PyTorch,同样输入立刻正常。每层看起来都对,叠起来就错。
硬件不兼容那 24 条更直接:有位用户在 V100 上跑 INT8 矩阵乘报错,维护者解释该实现依赖 INT8 Tensor Core,而 V100 没有这个单元——换软件版本补不上,只能换实现或者换硬件。
静默错误比崩溃更危险
崩溃至少有声音,挂起也卡得住训练脚本。最阴的是功能错误:算子跑完、程序不报错、结果不对。53 条、占 17.67%。
论文里有个 block-sparse attention 的例子:前向结果跟稀疏参考对得上,反向的梯度却严重失真,因为前向知道哪些 block 参与,反向却按稠密 attention 在算。前向对,不保证训练对。
这类问题还容易在样本里被低估。数值错得慢,用户往往跑很久才发现,或者压根没发现,也就不会去提 issue。再叠上低精度运算:bf16、fp8 下的微小误差,现有测试普遍逮不住。论文第三个研究问题就指在这——当前测试与调试手段,对低精度数值错误和硬件相关的执行失败,诊断能力明显不够。
顺带对个数字:根因标成「数值计算错」的只有 8 条、占 2.67%,看着不高。这个比例不能直接读成「数值问题很少」——逮不住的问题,本来就不会出现在这 300 条里。
一套可抄的排障顺序
别一上来就翻 kernel 源码。照论文的分类,顺序该是:先把环境版本全部冻结,记下驱动、CUDA、框架、每个包的确切版本;再搭最小可复现环境,输入缩到最小、无关组件全剃掉;然后二分定位,在驱动、框架、编译、包之间逐层对照,先跑一遍已知兼容的组合;末了才轮到怀疑 kernel 代码本身。
顺序反过来的代价是时间。直接盯 kernel,八成时候在盯一个没毛病的文件,等发现是环境问题,前面几个小时白干。划重点:kernel 是整条技术栈的最后一环,它的可靠性建立在前面每层都配对的基础上。
还有个容易误判的点:慢不等于卡。论文里有个 FlashAttention 安装的例子,看着像卡在编译,实际是 Ninja 没被声明成构建依赖,编译退回了单线程的慢路径。补上依赖,并行编译就回来了。判断「编译卡住」之前,先翻构建日志。
制度上堵住:三个动作
从个人排障到团队治理,论文结论指向三个动作。一,锁版本:requirements 和环境锁文件进仓库,驱动、CUDA 版本写进文档,终结「在我机器上是好的」。二,容器化:把软件栈装进镜像,换机器不换环境。三,CI 跑兼容矩阵:不同 CUDA、框架、GPU 架构的组合都过一遍,别只测开发机那一套。
论文给的建议很直白:验证要覆盖从安装到 kernel 生成的整条链路,部署前用预检诊断把不兼容拦在调用之前。像那个 CUDA 11.6 配 11.3 的例子,预检里一行就能揪出来,省下的是上线后带着生产数据翻三小时 issue 的时间。
但这里有个前提
论文自己没把这个比例当成全局故障率。300 条是人工精选的已关闭 issue:能关掉,说明有结论;能入选,说明讨论和证据齐全。issue tracker 天然偏向用户自己搞不定的问题,而且崩得响的上报多——安装报错、编译失败,一次就够人来提 issue;静默算错数字的,可能跑了一周还没人吭声。
所以 60.33% 说的是「这 300 条 issue 的根因分布」,不是「生产环境里各故障的发生率」。真要量化后者,得靠遥测和事故记录,那是另一篇论文的事。这篇值得抄走的是动作:冻结版本、最小复现、二分定位,把「kernel 有问题」从默认假设降到末位选项。查环境的成本,永远低于盯着一个没错的文件硬看。

