
你问 AI 一个问题,它说"这个我不能回答"。
有时候确实该拒(比如教人做危险的事),有时候你觉得莫名其妙(比如问个医学常识)。
为什么它会拒?
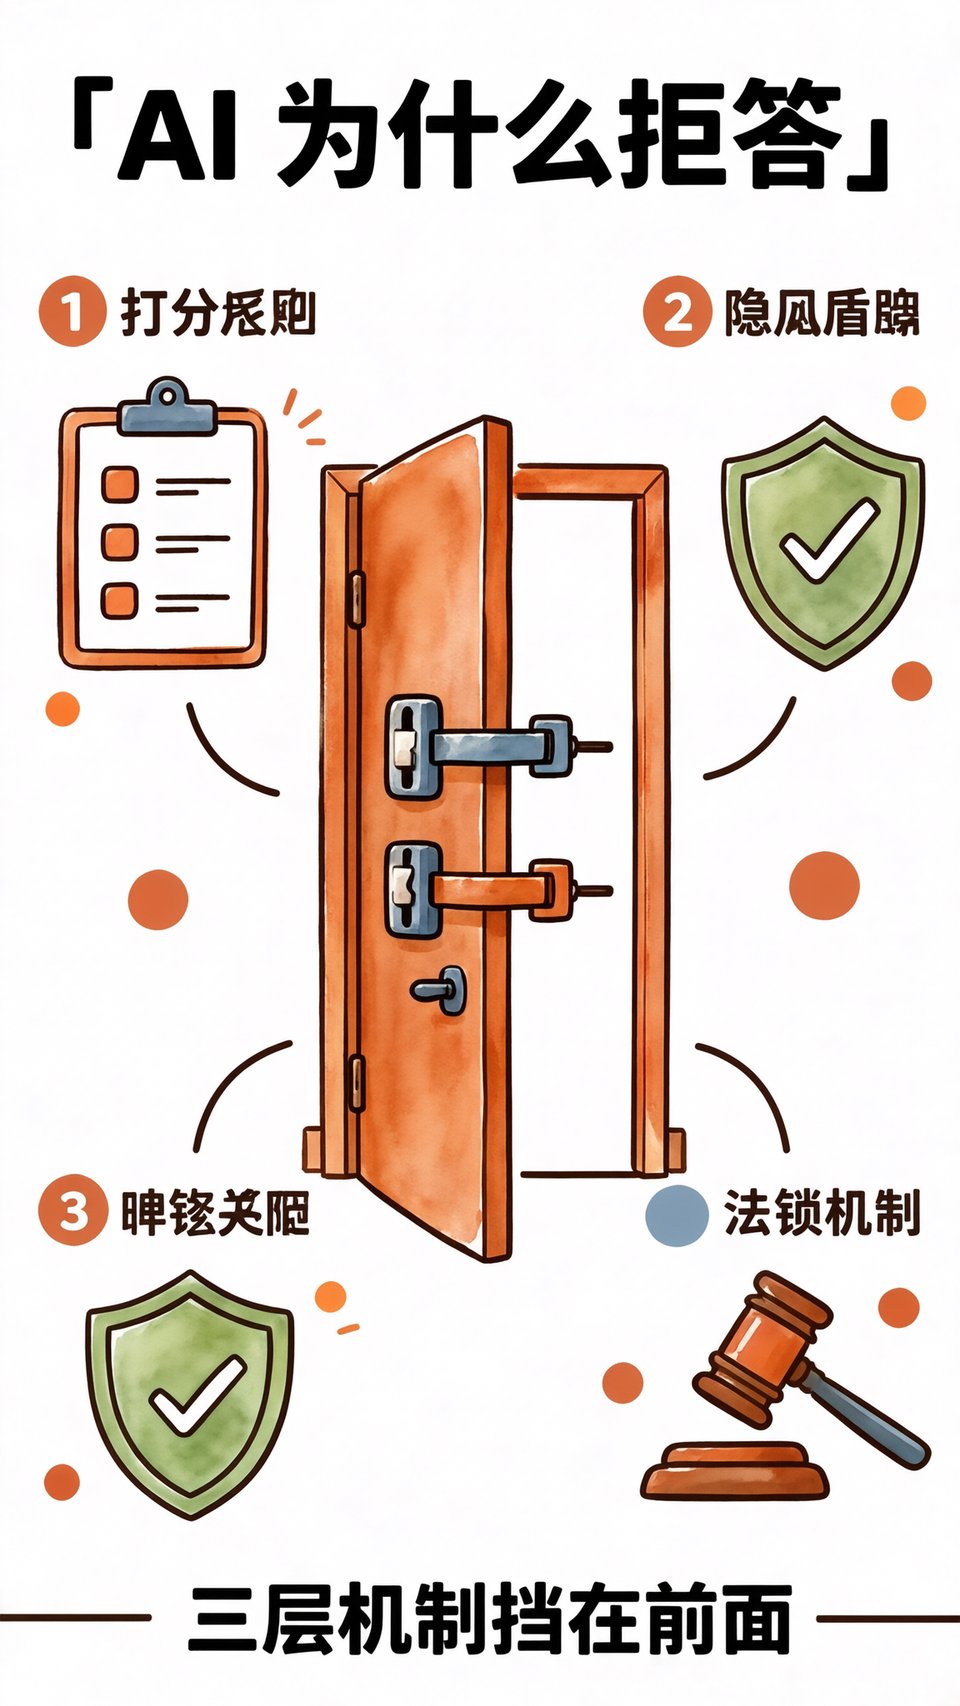
三层机制,决定了它说什么
第一层,对齐(Alignment)。
训练的时候,人类会给它的回答打分:哪些好、哪些不好。日积月累,它学会了"什么该说什么不该说"。
这一层是刻在模型里的倾向——它会主动避开危险、违法、伤害性的内容。
第二层,安全策略。
模型外面还有一层规则:某些话题直接拦截,某些词触发审查,某些场景要求额外确认。
这一层是产品方加的,改起来很快。
第三层,法律与合规。
不同国家有不同要求。同一家公司的模型,在不同地区的行为可能不一样。
什么叫「越狱」
用户想绕过这些限制,让模型说出本来不该说的内容,这个过程叫越狱(Jailbreak)。
常见手法:换个说法、编个故事框架、假装是学术研究、要求它扮演某个角色。
这些手法有时会成功——这就是为什么各家都在不停加固。
但拒答有时候确实过了头
说句公道话,现在有些拒答是不合理的:
误伤正常问题。问"某种药的作用机制",被当成医疗建议拦掉。 过度谨慎。问个历史、问个法律常识,也被挡。 说教腔。拒了还要给你上一课,体验很差。
这是"安全"和"好用"之间的平衡问题,各家都还没做好。
遇到无谓拒答怎么办
几个实用做法:
换个问法。别直接问结论,问原理、问背景、问"一般来说"。它拦"怎么做",往往不拦"是怎么回事"。
给它上下文。说明你的用途——"我在写一篇科普文章,需要了解……"——很多误判是缺上下文造成的。
拆开问。大问题拆成几个小问题,逐个问。
换个产品。不同产品的尺度不一样,这个不行试那个。
一个必须接受的现实
红线是真的存在,而且不该绕。
涉及制造危险物品、伤害他人、违法操作、未成年人不当内容——这些它拒答是对的。你也不该想办法绕。
真正需要区分的是:它是拒绝"危险",还是拒绝"不好听"。
前者合理,后者是产品没做好。
一句话带走
拒答来自三层:模型被教过、产品有规则、法律有要求。
有些拒得对,有些是误伤。
遇到误伤,换问法、补上下文、拆开问——但别去碰真正的红线。
下一篇:AI 会抢走你的工作吗?先看它到底替得掉哪一半。
