
你用某个 AI 应用,一个月几十块。你也可能自己接 API 做点小工具,账单按 token 走。
这两种价格差得很远。差在哪?
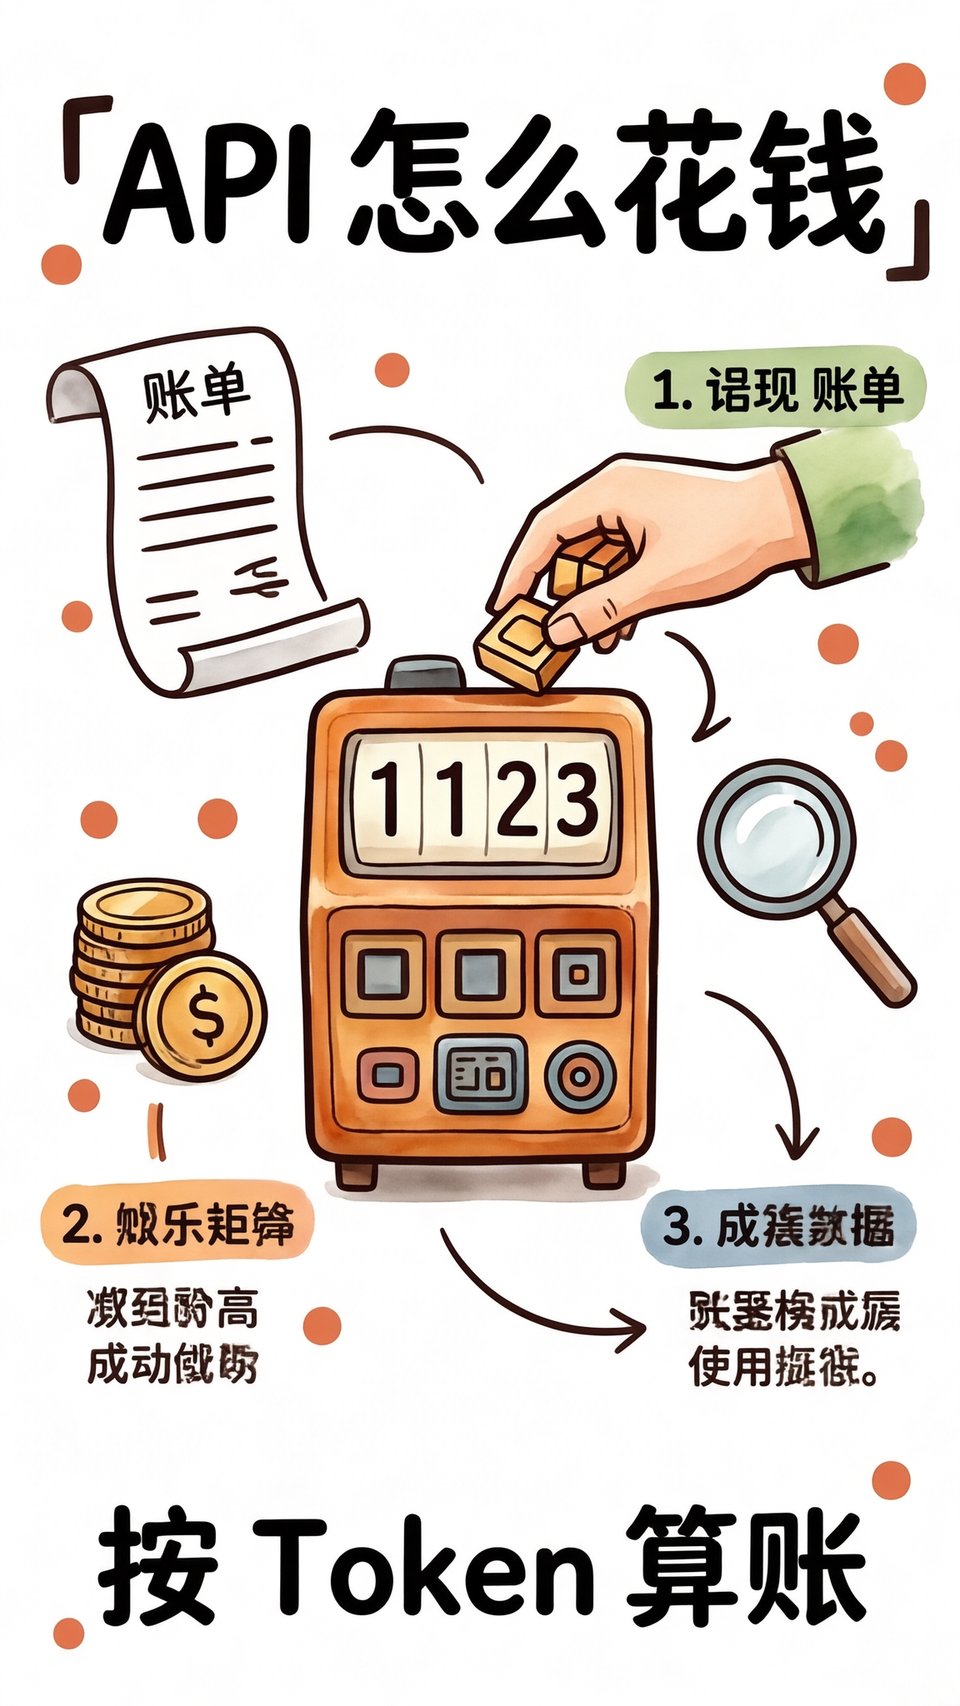
两种用法的区别
用成品应用。你买的是打包好的服务:网页、界面、功能。价格通常是月费或按次。
用 API。你自己接一个接口,把输入发过去,拿回输出。价格按 token 计(前文讲过 token 是什么)。
做小工具、批量处理、接进自己的系统,都是走 API。
API 账单怎么算
三条线:
输入价格。你发过去的内容,按 token 数收费。
输出价格。它返回的内容,按 token 数收费。输出通常比输入贵数倍。
缓存价格。如果每次请求都带同一大段前缀(比如固定的系统提示、同一份文档),很多厂商支持"缓存",这部分按很便宜的价格算。用对了能省一大截。
举个大致的算例(具体价格看各家官网,变动很快):
你要处理 1000 份文档,每份 2000 字,让它各写一段 300 字的摘要。
输入约 1000 × 1500 token = 150 万 token;输出约 1000 × 250 token = 25 万 token。
按输入 2 元/百万、输出 8 元/百万算:输入 3 元,输出 2 元,一共约 5 元。
同样的活让一个应用帮你做,可能收几百块。
什么最烧钱
按实际经验排一下:
第一名,反复带大段背景。每次请求都把整本手册塞进去,聊十轮就是十次全量输入。
第二名,长输出。让它"详细解释",它输出几千字,这部分单价高。
第三名,长对话。每一轮都要重读前面的全部内容,聊得越久越贵。
第四名,模型选太大。简单活用好模型,纯属浪费。
五个立刻能省钱的做法
一,按活的难度选模型。格式整理用小模型,复杂推理才用大模型。这一条通常省最多。
二,用缓存。固定背景走缓存,别每轮重发。
三,控制输出。"直接给结论"、"不超过 200 字"——输出省下来的钱是真金白银。
四,把背景压缩。给文档别给整本,先摘出相关段落。
五,批量处理。很多厂商有批量接口,价格更低(代价是延迟)。
还要看的两件事
限流。便宜不代表能用。免费额度通常有每分钟次数限制,超了会被拒。做产品要算好峰值。
稳定性。价格和稳定性常成反比。关键业务别只用最便宜的那家,留个备用。
一个判断标准
接 API 之前先算一笔:这个活人做要多久,值多少钱。
如果这事人做一小时值 50 块,AI 做花 5 毛,那这笔账很划算。
如果 AI 做要花 20 块,人做 15 分钟就完了,那就别折腾。
一句话带走
成品应用卖的是"打包好的服务",API 卖的是"Token 用量"。
最烧钱的是反复带大段背景、长输出、长对话、选错模型。
省钱第一招:按活的难度选模型。
下一篇进入最后一组:AGI 和世界模型——AI 的"终极形态"到底指什么。
