
同样是 AI 模型,有的能直接下载到硬盘,有的只能用网页和接口。
这不是细节差别,是两种完全不同的东西。
先说定义
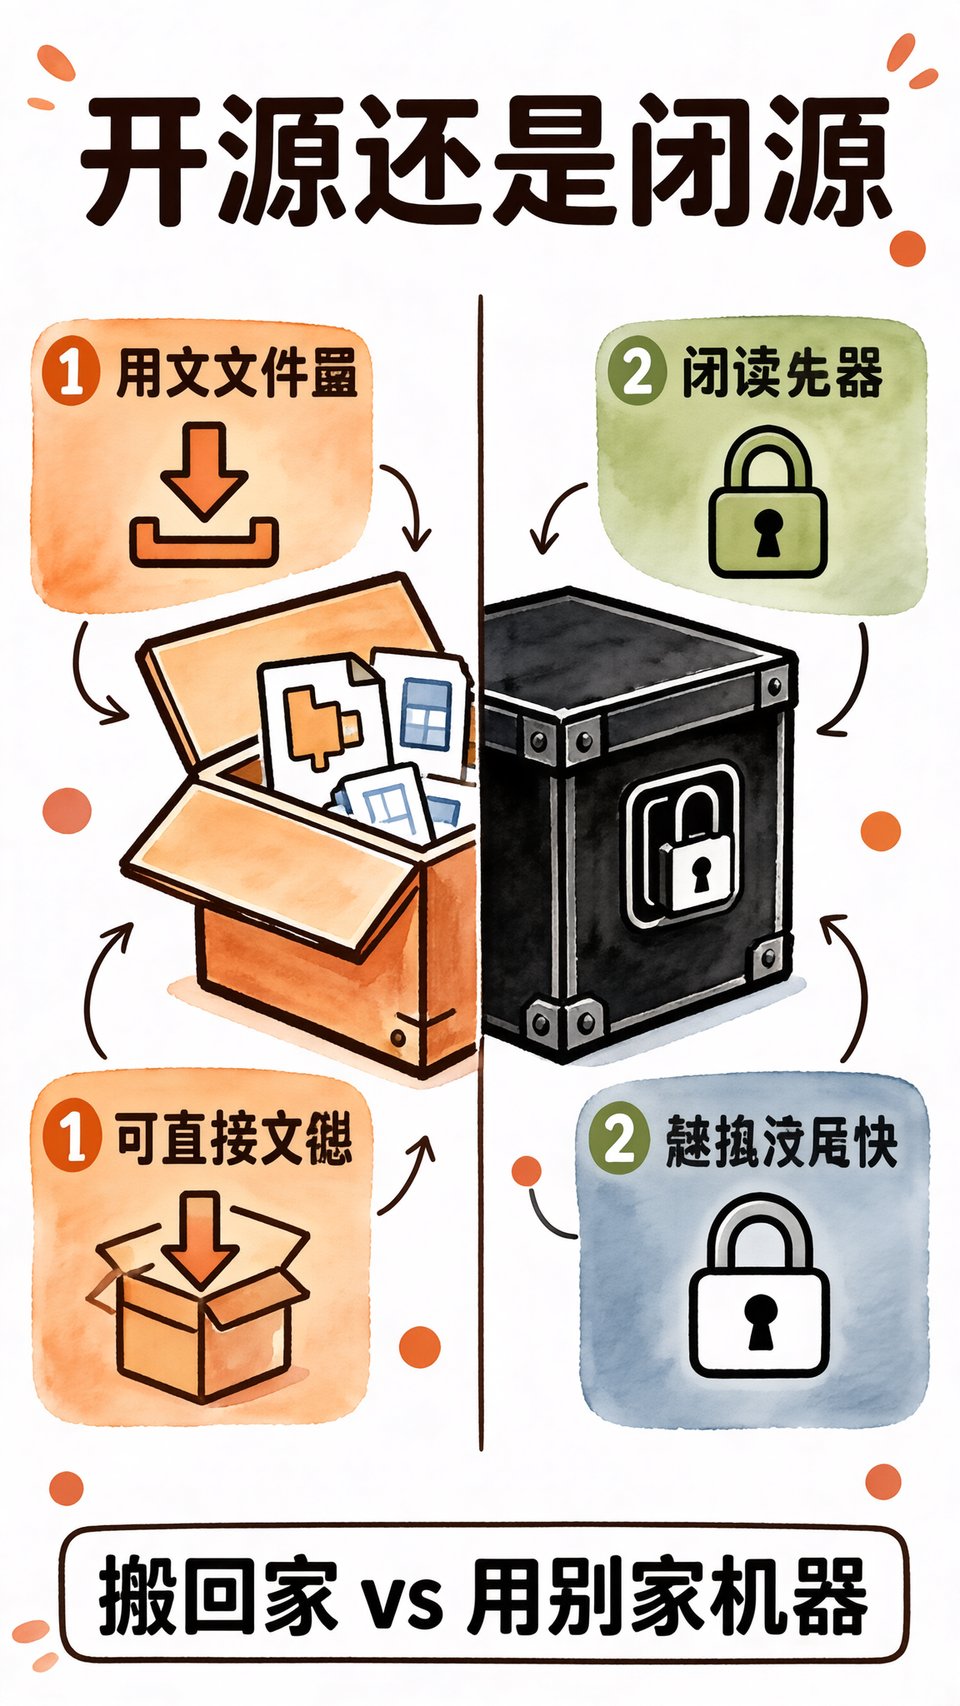
开源模型:权重文件公开,你能下载、能部署在自己的服务器或电脑上、能改。
闭源模型:只有厂商能跑。你用网页、App 或者 API 调用,但拿不到模型本身。
注意一个词:权重公开才叫真开源。有些产品叫"开放",但只能在它的平台上用,那还是闭源。
各自的优势
开源的优势:
成本可控。自己部署,只花电费和机器钱,用多少都不会按次扣费。
数据不出门。所有内容在你自己机器上处理,不用传给第三方。这对企业很关键。
能改。可以做微调、可以裁剪、可以嵌进自己的产品。
不怕停服。厂商不做了,你手里的模型还在。
闭源的优势:
效果通常更好。最强的那几个模型基本都不开源。
不用操心运维。不用买显卡、不用配环境、不用管扩容。
更新及时。厂商优化了,你直接受益。
上手快。注册就能用。
一个常见的误解
很多人以为"开源 = 免费 = 弱小"。
不对。现在开源模型的水平已经追得很近,很多任务上和商业模型差距不大。而且开源不等于不花钱——你要自己出硬件和电费,跑大模型照样烧钱。
反过来,"闭源 = 一定最强"也不完全对。在特定任务上,专门调过的开源小模型可能比通用大模型更好用。
怎么选:按场景分
选闭源的场景:
- 你要最好的效果,不想折腾;
- 用量不大、预算换个方便;
- 做面向客户的产品,需要稳定的服务和 SLA;
- 团队里没人懂部署运维。
选开源的场景:
- 数据敏感,不能出内网(合同、病历、客户资料);
- 用量很大,按次付费算下来比自建贵;
- 要做深度定制,需要微调;
- 要长期稳定,不想被某家厂商绑住。
混合用的场景(最常见的现实): 核心敏感数据用本地开源模型处理,对外的一般任务用闭源 API。这样既省钱又安全。
三个判断细节
看许可证。开源也分很多种。有的允许商用,有的限制商用,有的要求你改过的代码也得开源。商用前一定看许可证。
看量化版本。同一模型常有不同精度版本(4bit、8bit 等)。精度低一点,硬件要求低很多,效果损失通常不大。自己部署优先试量化版。
看社区活跃度。模型更新快,社区活跃的,出问题有人答,工具链也全。
一句话带走
开源是"把机器搬回家",闭源是"用别人家的机器"。
效果好选闭源,数据敏感、用量大、要定制选开源。
真实世界里,两者混着用最划算。
下一篇:本地跑 AI 和手机上的 AI——断网也能用,代价是什么。
