一句话:窗口越大,不等于越聪明
一句话:上下文窗口并不是越大越好,起码 NVIDIA 研究团队是这么公开讲的。据 The Decoder 报道,NVIDIA 团队认为,一味把窗口做大,往往既过度又昂贵;而「定期摘要+定向检索」这套老办法,在多项测试里效果和超大窗口相当。
先补背景。上下文窗口,就是模型一次能「同时看到」的文本量,单位是 token。窗口 8 千,它一次只能读 8 千;窗口一百万,它能把一整本书摊在桌上慢慢读。GPT-4 在 2023 年 3 月发布时窗口是 8,192 tokens;据 The Decoder 报道,如今 GPT 5.6 Sol 能处理约一百万 tokens,大约是前者的 120 倍。数字是挺吓人。
那为什么大家总被「窗口越大越好」牵着走?说白了,窗口长就省事:把材料一股脑全塞进去,让模型自己翻,我就不用费劲整理、检索了。问题是,把仓库整个搬进客厅,不等于你会收纳——塞得下,和用得好,是两码事。
有人会问:那 120 倍就白涨了吗?也不全是。整本书的翻译、超长代码库的复查,这类「必须一口气看完」的活儿,窗口就是硬门槛。但门槛归门槛,绝大多数日常任务离这道门槛远得很,没必要拿它天天付重读的钱。
贵的不是单价,是每轮重读全场
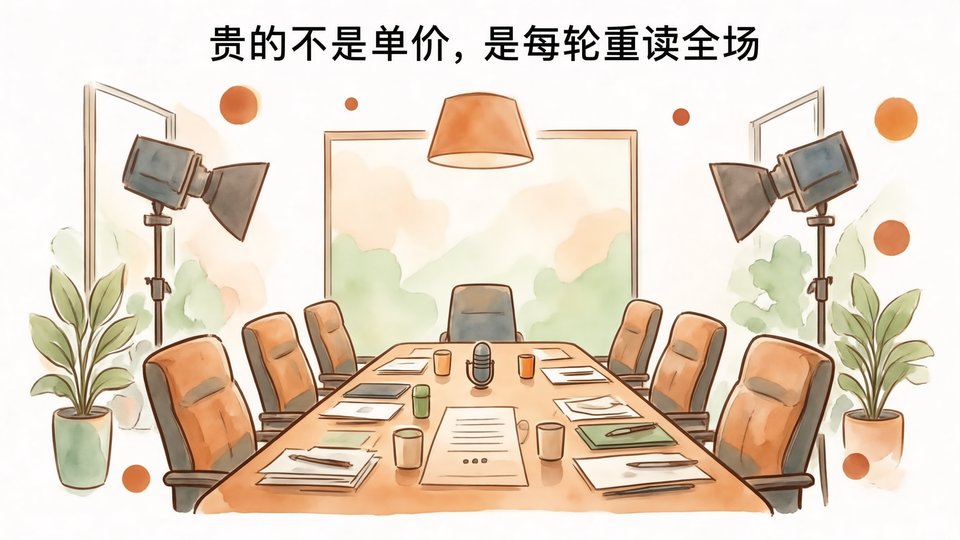
划重点:长上下文贵,贵的不是 token 的单价,而是「每次都要把全部内容重读一遍」这个结构。模型回答你之前,得把整个窗口从头过一遍;窗口多大,每一轮的花费就多大。你的账单不看「读了多少」,看「窗口有多长」。
打个比方:每次开会,都得先把前三个小时的录音从头重放一遍,才轮到你发言。会越开越长,重放成本跟着翻倍,你一句话没多说,费用先上去了。多轮对话更狠——每一轮都在重放同样的三小时,窗口摊得越大,重放越贵。
我的判断之一:窗口从 8 千涨到一百万,涨的是「容量」,不是「效率」。容量解决装不装得下,效率解决找不找得到;厂商把容量堆给你,找东西的活儿还是你自己的。热闹是容量的,账单也是。
顺带算笔简单的账:token 单价这些年其实一直在降,可窗口跟着涨,你每轮要读的份数也在涨。单价降一半、窗口翻两倍,账单照样往上走。厂商宣传总爱突出单价多便宜,很少提醒你窗口涨了多少;你只看见单价降,等月底账单寄过来才恍然——省的是单价,涨的是份数。
摘要加检索,为什么效果相当
先说口径:「效果相当」,是据 NVIDIA 研究团队的公开说法,具体测试我没拿到细节,不编造。至于为什么相当,我的理解是:问题出在信息密度上。全文摊开,有用的常常就几段,其余全是铺垫和客气话。
说白了,窗口越长,注意力越容易被稀释。一万句里找一句关键,和十句里找一句关键,难度压根不是一个量级。摘要把密度提上来,检索把范围收窄,两招合起来,反而比「全塞进去」看得更准、更省。
我的判断之二:这套打法不新鲜,早年的搜索引擎和数据库本来就靠索引吃饭;新鲜的是大模型时代,大家忽然把老办法忘了。窗口一涨,有人以为能装下整个世界,可每轮重读烧掉的算力,是实实在在的账单。
还有一层隐性成本叫噪声。全文摊开,模型得在成段的客气话和背景铺垫里捞关键句,每捞偏一次就多算一轮。检索把噪声挡在门外,模型看到的净是干货,自然又快又稳。这一份钱没人替你算成本,但每一轮都在付。
别迷信百万上下文,先学会检索
落到普通用户和开发者头上,结论很朴素:别一见「1M 上下文」就上头。绝大多数对话、写作、总结,几万 token 的窗口早就够用;真遇到长文档,先分块、再建索引、按需检索,效果不差,账单还好看不少。
对开发者,这话更实在。把「喂得多」当省事,等于把结构问题外包给模型;文档的段落、标题、前后关系,本来就是你最懂。先自己把索引建好,比赌模型在一百万 token 里自己捞针,靠谱得多,也便宜得多。
我的判断之三:未来大概率不是「窗口无限长」赢,而是「窗口够用+检索到位」的组合赢。谁先学会分块、建索引,谁就把这条死路走成近路。
但这里有个前提,也是留给你的一道题:NVIDIA 自己,恰恰是卖长上下文芯片的那家。一边说窗口够用就好,一边把显存带宽越堆越大——到底是研究上的真知灼见,还是商业上的两头下注?这个问题没有标准答案,但值得记在账本上,必要时拿出来对质。