一句话:这次的重点不是「又多了一个开源模型」,而是「开源」的门槛往上抬了两级,抬到数据和日志那一层。
据 GEroundtable 11 月 21 日报道,阿布扎比的 Institute of Foundation Models(IFM)放出 K2-Horizon:6 个模型,从 0.9B 稠密到 375B MoE 旗舰,主打推理与智能体。
划重点:375B 在多数 agentic 和编码基准上排第一或第二,Toolathlon-Verified 65.3 分第一。但这些分数全是作者自评,没有第三方验证。这条先记住,后面要算账。
把开源拆成四层
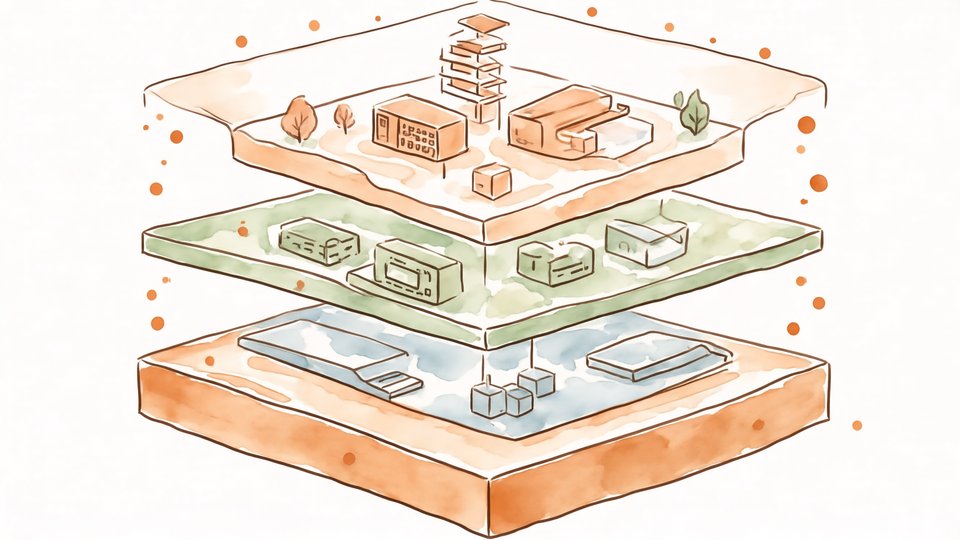
业内说「开源」,实际有四个档位。第一档是最终权重;第二档是中间 checkpoint,能看出某项能力是哪一步长出来的;第三档是预训练数据和它的构建流程;第四档是训练日志加全套代码。
大部分所谓开源停在一档到两档之间:权重给了,许可证还带附加条款。K2-Horizon 四档全给,论文里直接写明按 LLM360 那套「全开放」定义来做,没自己另发明一个宽松说法。
具体到量:六个模型合计约 380 个 checkpoint 标签,每个模型 68 到 70 个;训练日志按 7 到 14 个 run 挂在 W&B 上;连 loss 抖了怎么回滚、每 250 步存一次盘都写进正文。
中间 checkpoint 的用处很实在:想弄清「工具调用能力是哪一步长出来的」,可以从预训练到 RL 逐段切进去看,不用从头再训一遍。0.9B 少一点,只有 36 个。
多给的那一层:数据怎么造的
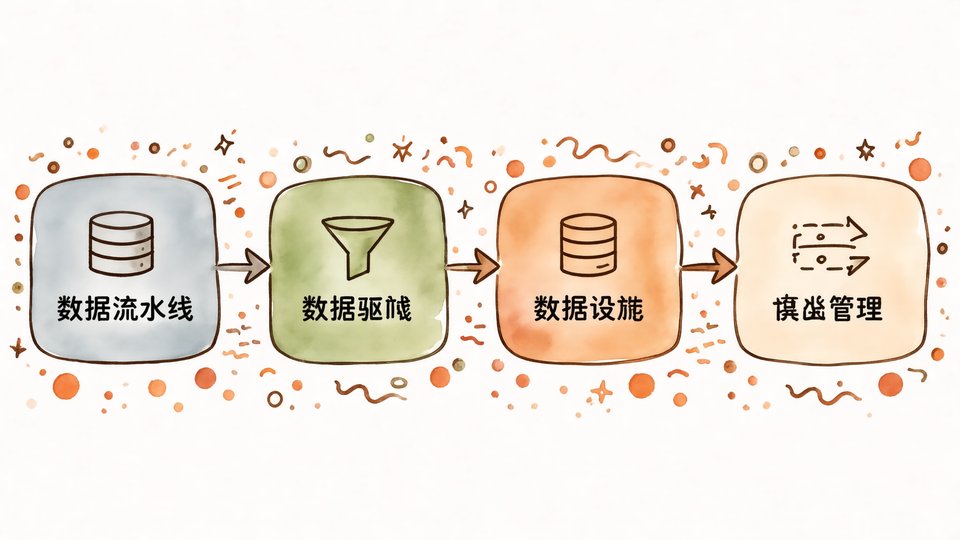
分量最重的不是权重,是数据构建的 pipeline。论文说预训练语料里约 10T token 是合成数据——22T 的盘子里接近一半是模型自己造的。
它把怎么造的也交了:pretraining-data-toolkit、search360、PRism 系列、task-factory 等十几个仓库,每个都对应论文的章节号。这块业内极少披露,它是「怎么把网页垃圾洗成能训的 token」的手艺。
我的判断:这批 pipeline 的长期价值可能高于 375B 权重。权重半年后会被追平,数据清洗的手感和配方能反复用,而且它决定了后来者能不能在别人的地基上盖楼。
但合成数据有个天花板:它的多样性上限来自造它的那个模型。论文把 10T 当卖点,也等于承认一半语料是照镜子照出来的。
两个技术赌注:MoVA 与 Uno
MoVA 说白了,是把 MoE 从 FFN 搬到 attention 的 value 投影上。36B-A4B 有 64 个 value expert,每个 token 只激活 4 个,外面套一个 softplus 门控;总参 36B,激活 4.665B。
换来的说法是:用大约七分之一的激活参数,追上同数据训练的 32B 稠密模型,各基准差几个点以内。这个七分之一是 4.665 除以 32.2,账能对上。
这招不是凭空来的:细粒度 expert 加共享 expert 的路由出自 DeepSeekMoE,前 3 层还留着稠密 FFN。新意在搬的位置,不在概念本身。
更被低估的是受控对比:3.7B、7B、32B、36B-A4B 吃同一套 22T 语料、同一套配方,其中两对连 batch 都一样。规模效应和稀疏度的影响,头一次有了干净样本。
Uno 是另一件事:从各模型蒸馏出来的扩散适配器,解码最高快 2.2 倍,不需要单独的 draft model,省掉投机解码那套额外的服务机器。但它只给 7B 和 0.9B 出了 adapter,旗舰没份。
阿布扎比为什么愿意给
下面这段是推测,先标明是推测。一家国家机构把最贵的东西免费给出去,换的通常不是钱。
推测一:人才和话语权。全开放意味着全世界的研究者按它的格式取 checkpoint、引它的曲线、复现它的日志,这比投广告有效得多。
推测二:它赌的是定义权。LLM360 那套「全开放」如果成了行业默认答案,定定义的人就是裁判,往后每一家说自己开源,都得先过这道尺子。
推测三:算力还没到无限。论文里写这套集群跟别的任务共享、按队列排优先级,卡不算最多的时候,把开放当杠杆比锁起来划算。
还有个更现实的理由:这笔开放不伤它的主业务。IFM 是研究机构,不靠卖 API 吃饭,权重放出去不会抢自己的单子;换成靠 MaaS 收钱的公司,同一份东西放出去就是割自己的肉。
对照物很说明问题。同期腾讯混元 Hy4 是 770B 总参、49B 激活、权重约 1.55TB,用自家 Tencent Hy License,MaaS 年收入超 5000 万美元或月活超 1 亿要单独授权。同样开放权重,一家留商业闸门,一家不留。
这笔账的另一面
375B 的权重是 758GB。按 H200 单卡 141GB 算,光装权重就要 6 张卡,实际部署还要留 KV cache 和冗余,一个 8 卡节点起步。所以谁跑得动?有机柜的人。
普通人真正摸得到的是三段:7B 权重 18GB、3.7B 是 10GB、0.9B 是 2.2GB。7B 和 3.7B 在 SWE-bench Verified 上大幅领先同规模模型,0.9B 的定位是手表、眼镜这类设备。
顺带说 36B-A4B:总参 36B 的权重 75GB,两张 80G 卡能摆下,激活只有 4.665B。这是整份发布里性价比最高的一档,也是唯一带 MoVA 的。
再往下是电和散热。八卡 H200 一个节点长期满载,机柜的供电和散热比卡本身更难搞,所以真正跑 375B 的往往是云厂商,不是个人。
还有一层隐性代价:没有商业实体给你兜 SLA。Hy4 那边留了授权闸门,也就留了商务接口;K2 这边出问题,只能看 issue 区和论文。
我的判断:全开放对头部厂商的边际价值很低,他们不缺权重也不缺卡;值钱的是缺证据的人——高校实验室、中厂,以及想自己训一版但没跑通过 22T 的团队。
但这里有个前提
前提一,分数是作者自评。Toolathlon-Verified 的 65.3、在银行基准上超过两个 GPT-5.6 变体,都是自己跑自己报。短板也自己认了:HLE 和 CritPt 这类专家级科学推理落后。
前提二,口径要分清。22T 是 3.7B、7B、32B、36B-A4B 四个模型共享的语料;375B 旗舰预训练只走了 15.1T,分两个阶段。论文写得清楚,转述时最容易被糊成一句。
前提三,许可不齐。模型和代码是 Apache 2.0,数据集按各自许可走,论文举的是 ODC-BY 这类,不是一把 Apache 盖住全部。
前提四,复现不等于能重跑。380 个 checkpoint、758GB 权重、10T 合成 token 的生成流水,个人研究者能做的是读懂,不是复现。
所以「开到哪一步才算真开源」,K2-Horizon 给的答案是:把别人复现你所需的全部证据交出来,才算。至于它自己够不够格,等第三方把 65.3 重跑一遍再定。