先说结论:如果你的账单被长上下文智能体顶得难受,最该换的不是 GPU 型号,是那一层缓存。AWS 在 Agent Toolkit for AWS 里放了个分布式 KV 缓存的 skill,配上 ElastiCache for Valkey 那套已经正式可用的能力,官方博客给的数是自托管推理成本最多降 40%、首 token 延迟最多降 80%。
这两个数我信一半。省下来的不是「算得更快」,是「不用再算」,逻辑上成立;但这是官方博客自己的口径,落到具体业务打几折,看你 prompt 有多长、路由有多乱。我的判断是:缓存这件事被低估了,因为它不酷,看起来不像在优化模型。
顺带说个反常识的点:多数人把 KV 缓存当成推理引擎里的一个参数,其实它更像基础设施问题。真正的战场在网络和存储层,不在 GPU 的 SM 里。所以这次 AWS 出的是一个 skill 加 ElastiCache,不是改模型参数。
先说结论:省钱的不是卡,是缓存
我见过的调优现场,十个里有八个第一反应是换更好的卡。B300 确实快,但你烧的钱不在算力峰值上,在「同一段上下文被反复重算」上。换卡是把单位成本压低一截,缓存是把重复的部分直接抹掉,两者不是一个量级的省法。
所以我看到这个 skill 的第一反应是:终于有人在网络层做文章了。GPU 之间的 KV 状态以前是孤岛,谁算的谁用,换台机器就从零开始。补上这一层,才是长上下文推理真正的前置条件。
95% 的重复前缀是复读出来的
官方引了 SemiAnalysis 和 TraceLab 对编码智能体 trace 的分析:超过 95% 的 prompt token 属于之前已经处理过的前缀。我第一眼也觉得夸张,后来在客服链路里抓了几十条 trace 自己数,比例差不多——系统提示、工具定义、历史消息,每轮都原样重发一遍。
AI 编码助手、客服智能体、文档问答,这三类 prompt 动辄十万 token 起。多轮对话里真正新增的可能只有几百字,剩下的全是复读。没缓存,就得把十万 token 的 KV 状态从零预填。
贵到什么程度,给个尺寸感。AWS 文档写:B300 上 3.2 万 token 的预填要几秒,10 万 token 要几十秒,超过 25 万 token 要几分钟。这不是算力不够,是物理上就得跑那么多步。
我的判断:这不是模型问题,是应用层写法的问题。很多团队压根没意识到自己在为复读付全价,还以为是卡买小了。
这套东西长什么样:L0、L1、L2
原来的 KV 缓存只有 L0 和 L1,都在 GPU 本地,谁算的谁用,换台机器就归零。新加的是 L2:整批 GPU 共享的一层,任何一台服务器都能读到别的服务器算过的 KV 状态。
落地的机器是 cache.i8ge.48xlarge,跟 GPU 集群同可用区,走 EFA 上的 RDMA 直连,绕开操作系统网络栈和 TCP/IP。单节点吞吐最高 220 Gbps,DRAM 里的块亚毫秒级响应;冷块自动分层沉到节点本地 NVMe,能存几天。
这组设计的意思很明确:跨会话、跨路由漂移、跨服务器故障,缓存都还在。我对跨故障这条最有兴趣——单机挂掉不再等于缓存清零,这是自建方案很难做扎实的地方。
怎么接:改配置,不改代码
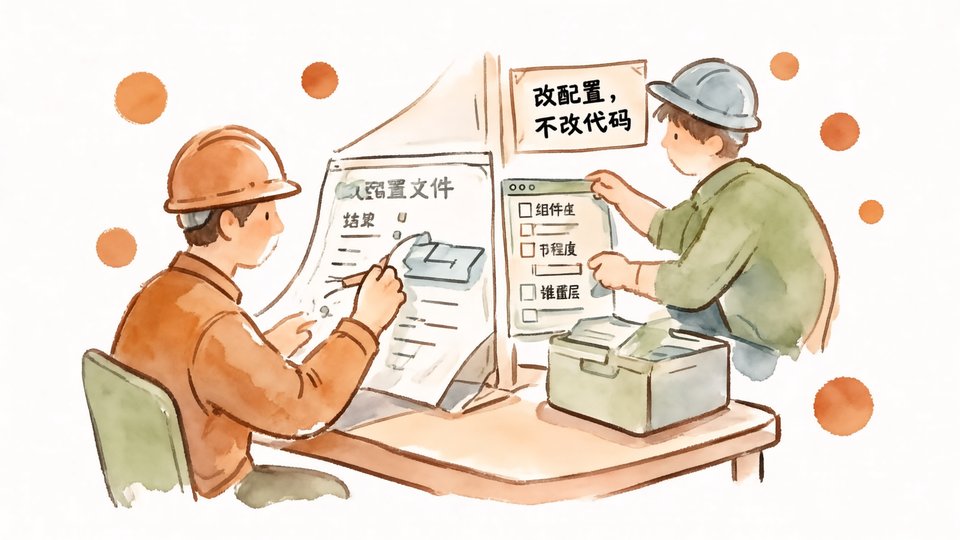
接入门槛比想象低。现有 vLLM、SGLang、TensorRT-LLM 只要加 LMCache 连接器、改配置,不用动代码。硬件侧要支持 EFA RDMA 的 GPU 实例,比如 p5。
版本线按 AWS 文档:LMCache 0.5.8rc1 或更新,vLLM 0.11.1 或更新,或者 SGLang 0.5.13 以上;ElastiCache for Valkey 9.1 以上。区域目前 13 个可用,覆盖美国、欧洲、亚太。
我提醒一句:rc1 这个后缀说明 LMCache 还在收边,上生产前留出回归窗口。改配置不改代码听着轻松,代价是版本组合的兼容性得自己压一遍。
还有一个白送的选项:KVTrace 是开源的,拿 vLLM/SGLang 已经发布的缓存事件离线模拟不同 L2 容量下的命中率、成本降幅、TTFT 降幅,不动推理引擎也不碰生产集群。想先算账再动手,从这儿起步。
两个坑,都不小
第一个坑是切点。prompt 短的时候,从缓存读 KV 状态比重新算还慢——网络往返加反序列化,拼不过 GPU 直接跑。存在一个 cutover point,过了才划算,具体落在多少 token 官方没给死数,得自己测。
第二个坑更阴:多台推理服务器的缓存 ID 机制(hash 和 seed)跟 KV 数据类型必须一致,否则会出现命中率很漂亮、答案是错的。这种假命中比不命中可怕得多,因为它不报警。
官方建议上线前先清空本地层,跑两次缓存加载的对比,确认输出一致。我把这条当硬规矩记下来了:命中率是过程指标,输出一致才是结果指标。
还有个案例值得贴出来:某法律 AI 助手恢复旧对话时首 token 要等 13 秒,排查下去只是 prefix caching 被关掉了。开关一开,13 秒大概率就没了。这类问题不崩,只是慢,慢到你以为该换卡了。
适合谁,不适合谁
先看已经吃到肉的。Multiverse Computing 在同一批 GPU 上多处理了 50% 的请求,中位首 token 延迟降 23%,峰值流量下延迟降 95%。这几个数比前面那两个上限数字更接近日常。
适合的:prompt 稳定超过几万 token、多轮对话占比高、已经在用 vLLM/SGLang/TensorRT-LLM,并且 GPU 就在 AWS 上跑。这类场景基本白捡。
不适合的:prompt 短、请求稀疏、上下文每次全新生成,或者压根不在 AWS 上。短 prompt 撞在切点以下,加缓存反而更慢,还得额外养一层 Valkey。
我的判断:这是给「上下文又长又重复」的团队准备的解药,不是通用提速开关。把它当默认项全量打开,大概率踩坑。
回到开头那句。换卡是把算力买贵一点,缓存是把重复买没了。前者有上限,后者没有——只要你的 prompt 还在复读,这笔账就一直能省。
下一步我大概会拿 KVTrace 先跑一遍我们自己的 trace,看切点落在哪,再决定要不要上。40% 和 80% 是官方博客的数字,我的数字得自己测出来。