毕马威(KPMG)英国分支公开了一个试点项目,代号 Project Exponential:让 100 多个 AI 智能体一起上手,去审计一家英国上市公司的财务报表。这家公司属于富时 250 指数,名字没有公布。
整件事被外界记住,靠的是审计负责人 Cath Burnet 对媒体说的一句话:智能体在某些情况下比人类团队挖得更深,还问出了一些人类审计员没问过的问题。公开的事实就这些,到此为止。
先看事实:一百多个智能体,审一家没名字的公司
划重点,先把已知的三件事摆清楚。一是规模:100 多个智能体同时进场,不是一个人在电脑边上开个助手;二是对象:一家富时 250 成分公司,匿名;三是结论:只有一句,出自项目负责人本人,说的是问得更深。
没有披露的部分同样值得点一下。试点跑了多久、智能体接进了哪些系统、有没有查出真实的错报、发现的东西有没有进入正式审计意见,这些全都没说。所以「AI 已经能独立出审计报告」这类说法,现在都属于加戏。
说白了,这是一次内部试点的阶段性说法,不是一份可以复核的研究。当成方向信号看,合理;当成结论用,就不合适了。
说白了,智能体在审的还是凭证和数字
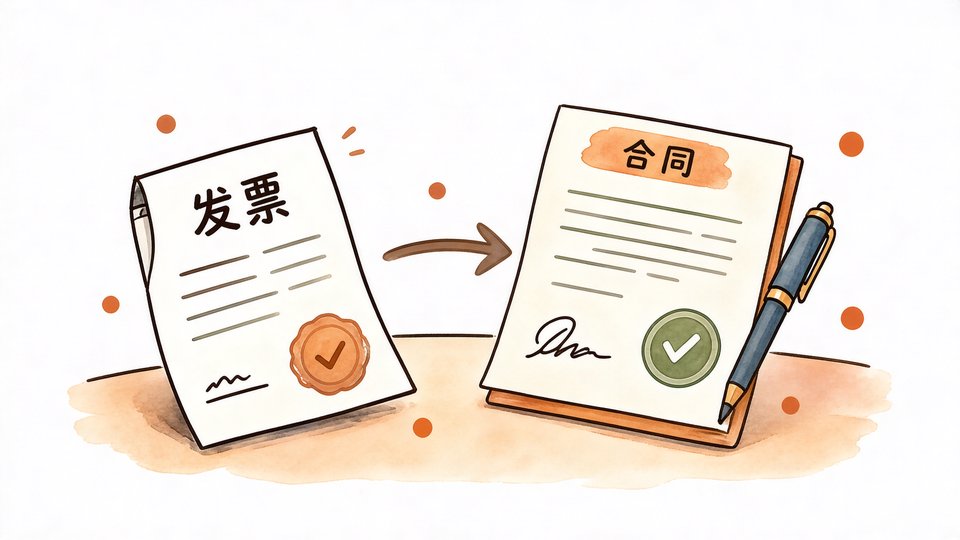
审计这活,外行容易想得太玄。按我自己的常识理解(不是官方口径,只是背景常识):一张财务报表背后要做的事很朴素,翻凭证,看每一笔记录有没有发票、合同、银行流水对得上。
接着是勾稽,报表上的数字之间要能互相咬合。收入跟应收账款、存货跟成本、现金流跟利润,动一处会牵动另一处。人工核对最费时间,也最容易漏。
往上一层是找异常:金额异常、时间异常、对手方异常、期末突然冒出来的大额交易。这三类活儿有个共同点,量大、重复、需要耐心,恰好是智能体擅长的地方。
还有一层是跟人打交道:向银行发函证、找客户确认应收、跟财务总监当面对账。这部分智能体暂时插不上手,但它能把前面攒下的疑点整理成清单递给人,来回就少了好几轮。
所以我猜它问得更深,多半深在覆盖面。人一天能翻的凭证有限,机器可以全翻一遍,翻到第二遍自然会冒出人没来得及问的问题。它是不是真的理解了什么,材料里没有证据。
这笔账怎么算:一百个智能体抵几个人
把 100 多个智能体折算成人,是很多人的第一反应。但这里算不出精确答案:单个智能体的调用开销没公布,原来那个审计小组有多少人也没公布。
只能做个粗糙对比,以下是我的估算思路,不是数据。一个中型审计项目组,通常几个人到十几个人,赶季还得熬夜。100 个智能体如果真能同时干这十几人的活,账面上省的是人手;但它们不签字,也不承担后果。
另一侧还有隐形部分:把公司账套接进去、清洗数据、给智能体划边界、逐条复核它翻出来的东西,这些活仍然落在人身上。省下来的工时有多少,取决于这些前置工作有多重,材料没说,谁都给不出数。
泼一盆冷水:一家公司,一句结论
第一盆冷水:样本只有一家公司。一家公司的账,行业特性、系统成熟度、账务复杂度都不一样,从里面推不出通用结论。
第二盆冷水:公司匿名。匿名意味着外部没法复核,也没法判断这是不是一个好审的样本。挑一个数据干净的公司做试点,结果当然好看。
第三盆最要紧:问得深不等于判得准。提出问题是一种能力;判断哪个问题重要、哪个发现构成错报、要不要写进审计意见,是另一种能力。前者能靠覆盖率堆出来,后者要担责任。
所以在现有的审计制度里,最终签字的还得是人。这个签字不是走流程,是法律责任,机器目前接不住。
再补一句:我们拿到的只有媒体转述的一句话,没有方法说明,也不知道它比的是同一批人还是不同项目组。对这种转述,解读时最好先打个折扣。
谁站在台上签字
回到那句原话:智能体提出了一些人类审计员没问过的问题。这句话的分量,比「效率提升」重得多。
因为审计这行的权威,一直建立在「我问得比被审的人更深」上面。这个位置一旦被换掉,人类审计员的角色就要重新定义:从提问的人,变成审核提问的人。
这不坏,但它需要一整套新规矩:智能体的发现怎么留痕、谁来复核、出了错算谁的、底稿里怎么呈现。这些现在都还是空白。
但这里有个前提:如果问问题的能力真的超过人类,那人类以后是站在台上签字,还是坐在台下被问?