先说结论:多智能体这套玩法,听着很美,用起来得看场景。11月17日,Perplexity官宣给自家Computer产品加了个新档位Multiagent,排在原来的Ultra之上。官方的说法很直白:最复杂、最容易出错的活,交给一队AI分头干,干完再互相检查。
它解决的其实是个「人手不够」的问题,不是让你天天用的东西。查个天气、问个菜谱,别点它;真有大活——写调研报告、审财报、做尽调——它才有用武之地。下面拆开讲。
这波更新到底干了啥
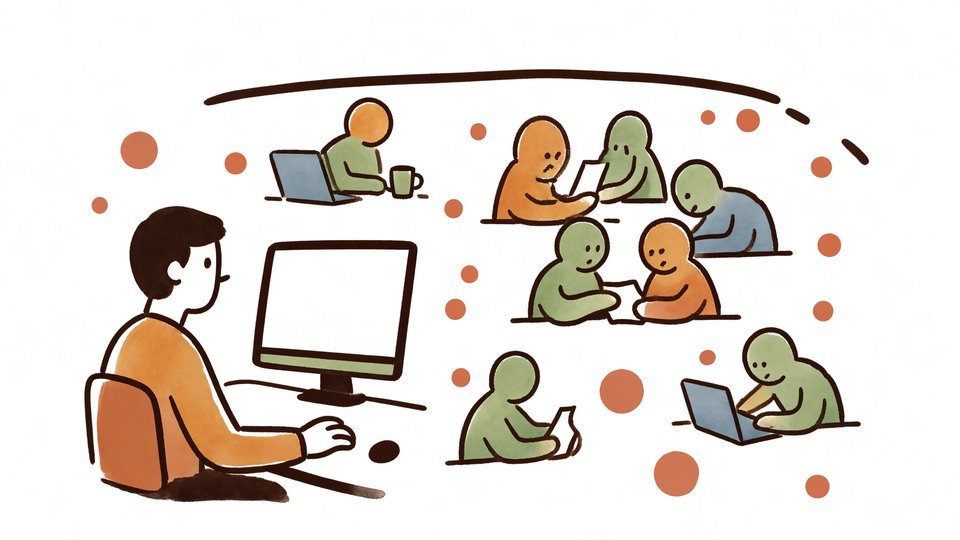
以前Computer干活像「一个组长派活,小弟干完各自汇报」;多智能体模式升级成「组长派活,小弟们一边干活一边互通进度、共用资料,还能互相挑刺」。(据Perplexity官方博客)
具体机制是:一个主智能体把任务拆成小块,分给最多16个子智能体并行处理。这些子智能体共享发现、一起编辑共享文件,谁发现对方的假设有问题,当场标记出来让同组人去查。
一句话总结这章:从「组长单线收作业」变成「小组协同作战」,信息不再只往组长一个人那儿汇。
顺带区分两个容易混的概念:Model Council是让多个模型独立回答同一道题再对比;Multiagent是把一道大活拆给多个智能体分头做,两者组织方式完全不同。(据Perplexity官方博客)
多智能体解决了什么问题
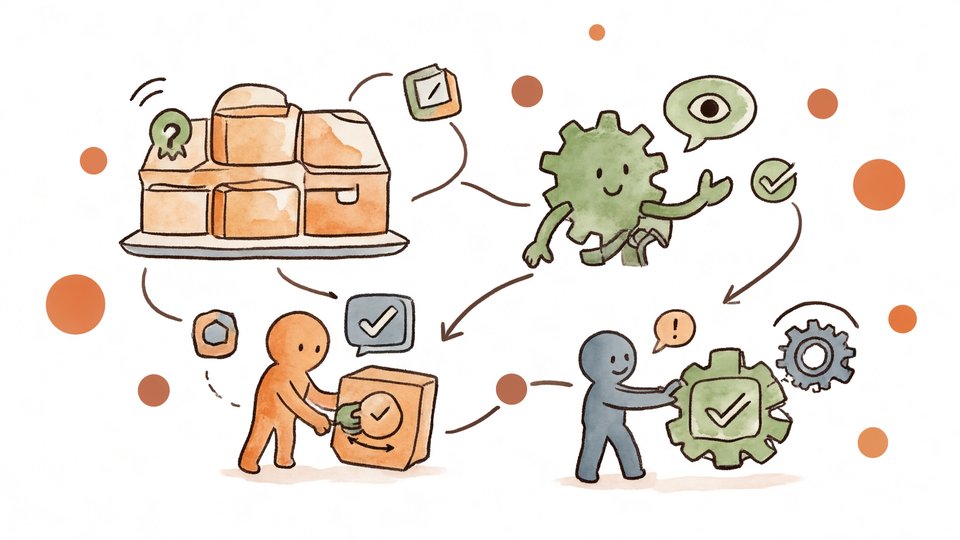
拆开看,它解决两件事。第一件是人手不够:一份市场调研报告从头查到尾,又慢又容易漏;拆成几路并行,速度能上来。官方给的例子是财务预测、年报审计、尽调数据室,全是能拆开干、干完还能对上账的活。(据Perplexity官方博客)
第二件是大任务容易漏:一个人闷头干,漏掉一个数据、看错一份文件没人发现。多智能体互相检查,等于给每个环节配了个监工。一家漏的,另一家可能接住。
说白了,设计思路是给复杂任务加一道交叉验证的保险,降低遗漏和出错,不是把简单的事搞复杂。
16个AI一起干,谁说了算
这么多AI同时干活,总得有个说了算的。Perplexity的安排是:主智能体当组长,默认由Claude Fable 5.2来当,负责拆任务、分派和汇总;你只跟组长一个人对话,不用挨个指挥16个小弟。(据Perplexity官方博客)
中途想改需求也方便:跟组长说一声,它通知相关的小弟改,其他人继续干。界面上能看到每个智能体在用哪个模型,想停,整个队伍一起停。(据Perplexity官方博客)
这也算个贴心设计:用户不用学怎么管理一屋子AI,对话框还是那个对话框,复杂度由产品扛着。
三家模型混编,不押注一家
这波最值得说的一点:默认队伍不是一家模型包圆,而是Claude Opus 5.5、GPT 6.1 Sol、Gemini 4 Carbon三家混编,来自不同厂商。(据Perplexity官方博客)
三家模型训练数据不同、擅长领域有差,让它们互相检查,比一个模型自查多一层视角。官方也允许你在提问时自己指定要用哪些模型。
聪明在哪:不把宝押在一家模型上,等于给任务上了道「多个脑袋」的保险。代价是队伍变多、协调成本跟着涨,这一点放到最后说。
适合谁用,不适合谁
先说清楚不适合的:问个天气、查个价格、让AI写个朋友圈文案,普通模式或者Ultra就够,开16个智能体属于杀鸡用牛刀。
适合的是这种活:环节多、需要分头查资料再汇总的调研;要交叉核对数字的财报类任务;长文档的审校。脑补一个场景:写市场调研报告,几个智能体分头查行业数据,一个写初稿,一个专门对着数据挑错,组长最后汇总成一份交差。
判断标准就一条:这活拆不拆得开、拆开之后对对不对得上。拆不开的流水线活,多智能体帮不上忙。
账要算清楚:AI越多,烧得越快
临了泼盆冷水:Perplexity这次只公布了机制,没公布任何准确性或速度的基准数据(据MarkTechPost报道)。效果到底比Ultra强多少,还得等真用过的反馈。
16个智能体并行,背后是十几份算力在跑;任务越复杂、跑得越久,花的时间成本越高,这个账得自己心里有数。好在新档位面向Perplexity Max订阅用户开放(据Perplexity官方博客),要不要加预算,把场景想清楚再定。
我的态度:这功能是给「把AI当同事用」的人准备的。你的活单线程就能干完,别凑热闹;真有一堆拆得开的大活,可以让这16个「临时同事」先干一票试试。