一只茶杯,和它看不见的毛刺
把一只茶杯放大十倍,你会看到杯沿有一道几乎看不见的毛刺。过去,AI 造 3D 世界,总是栽在这种地方;11 月,苹果研究者给出一个新办法:不加训练成本,只改推理方式,3D 细节就能大幅提升。
先交代主角。「潜空间 3D 表示」听起来吓人,其实是一台压缩机器:把整座 3D 场景压成一段紧凑编码,像把一栋楼的户型图折成小纸条;生成模型拿到纸条,再把它展开成完整世界。编码的容量有多大,细节的额度就有多大,想要更多细节,就得给编码扩容。
毛刺有多小?小到正常人不会看第二眼。可只要它糊成一片,整只杯子就露了馅,像一位只会画大轮廓的画家,手腕永远画不细。3D 生成卡住的,正是这种细到看不见的一毫米。
据 arXiv 预印本(编号 2611.16126,11 月 12 日提交),《Split-and-Scale Latent 3D Representations》出自 Dorian Chan、Jen-Hao Rick Chang 等五位苹果研究者之手,已被 NeurIPS 2026 收录。
3D 世界的细节,凭什么这么贵
AI 重建 3D 场景,和拍照是两回事。照片糊了,换台像素更高的相机就行;3D 生成靠的是压缩编码里的容量——容量像一件行李箱,箱子多大,能装进多少细节,出厂就定死了。
想让箱子变大,就得加大模型、从头重训。训练 3D 表示模型很占显存,容量一扩,单张显卡先装不下。工程师管这堵墙叫「显存墙」:墙那边是更精细的世界,墙这边是现在能跑的日子。
也有人想过绕路:训练不动,推理时多塞几个 latent——编码里多几个格子——总该有用吧?结果不如人意:多出来的格子没有被训练去「记住」细节,模型不会用,新增容量等于白加。
这么一算,细节贵在两头:重训要烧钱,硬塞又没用。这道题卡了不止一次,苹果这次交的卷子,恰好绕开了这两头。
苹果的办法:把镜头对准更小的地方
苹果的办法叫 split-and-scale,直译「切分与缩放」,拆开就两步。论文先把 3D 场景当作「3D 坐标的连续函数」——人话版:场景里每个点都有一个数值在等它。训练好的 tokenizer 负责把数值编成 token,tokenizer 就是那台压缩机器,token 相当于编码的基本单词。
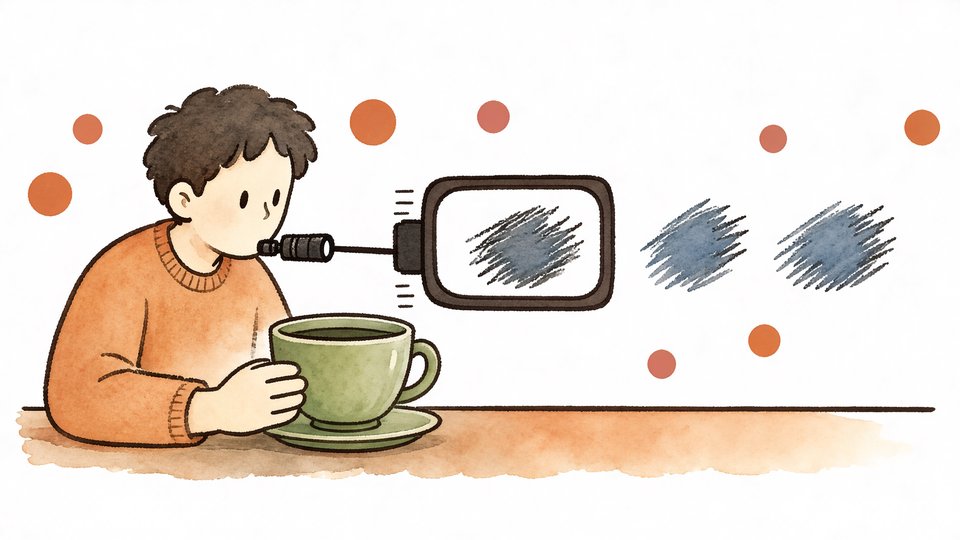
以前的做法是一镜到底:一支「广角镜头」把整个场景一次收进编码,画质靠镜头极限。苹果改成扫拍:先把场景切成任意小的子区域,切多小都行,然后把同一台训练好的 tokenizer,一格一格对准小区域扫过去。
奇妙之处在于:每一格用的容量没变,服务的空间范围却小了一截,同样的容量只画更小的一块地,细节自然上来了。全程没有多训练一分钟,tokenizer 还是原来那台,只是用得更讲究。
记住这个画面:不是换了一支更强的镜头,而是把镜头凑近一点,一格,一格,扫完整座城。
能跟「训练不出来的模型」打平,说明什么
据论文,这么一扫,重建质量能跟一种「更大模型」打平——大到什么程度?超出单张显卡的内存上限,根本训练不出来。以前想要更多细节,答案永远是训练更大的模型;现在,一台没多花钱的机器,交出了同级别的活。
研究团队还在这种表示上训练了一个自回归 3D 生成器——让它一个 token 接一个 token 地「写」出三维内容,效果与当前最好的基线可比。据论文,重建、生成两头都有交代。
但边界同样清楚。据 AIToolMaps 的信息,论文目前没有开源代码,也没有放出模型。方法还躺在论文里,离普通人用上,中间隔着「复现、打磨、产品化」几道工序。结论先给到这儿:方向很亮,路还长。
当细节变便宜,世界会变成什么样
细节是 3D 内容走进生活的敲门砖。游戏里的苹果会有籽、有梗,电商图能转着圈看,虚拟展厅里的沙发能看清织物的纹理——这些画面背后,全是细节的价格。
过去,细节每多一分,训练账单就厚一分,普通团队只敢在「够看就行」的地方将就。要是切分扫描的办法被验证、被开源,细节降价,做 3D 内容的人就能把省下的钱花在想法上,而不是烧在显卡上。
链子很长:3D 内容越好造,游戏、AR、电商展示、VR 的门槛就越低。而苹果这篇论文,动的是最底下那颗螺丝。
换镜头,还是用好手上的镜头
技术的进步,常常不是换一支更强的镜头,而是学会把同一支镜头用得更好。split-and-scale 教给 3D 生成的,正是这一课。
回到那只茶杯。下一次,AI 重建的杯沿不再糊成一片,杯身上每一道釉色都站得住时,你大概不会想起这篇论文。但把它做出来的那台机器,并没有变得更大。
它只是懂得一个朴素的道理:看得更细,不一定需要更强的眼睛;站得够近,也行。