
一句话:你调 AI API 时听到的 ZDR(零数据留存),不是厂商贴在公司名上的「靠谱标签」,而是某个具体端点(endpoint)上真实生效的属性。同一家厂商,不同端点,是不是 ZDR 可以完全不一样。
这篇文章拆透 Fireworks AI CEO Lin Qiao 提出的框架,结合 OpenAI、Amazon Bedrock、Google、Anthropic 和 Fireworks 的公开文档,把 AI API 的两种标准数据生命周期设计讲清楚(据 MarkTechPost 报道)。
一种是上传后由客户自己删除的「客户管理模式」,一种是发数据、算完即返、不落盘的「瞬时处理模式」。落到普通用户和开发者调 API 时怎么判断、怎么主张。
什么是ZDR:不是「永不存」,是「这一次不存」
划重点:ZDR 全称 Zero Data Retention,零数据留存。最容易误解的地方,是以为它等于「厂商保证从不保存我的数据」。不是这个意思。
说白了,ZDR 描述的是一种处理时刻的数据生命周期设计——数据发过去,用来做推理计算,然后结果立刻返回,过程中没有把它持久化写进磁盘。数据「经过」了这个服务,但没有「住下」。经过和住下,就是差别的核心。
但这里有个前提:ZDR 讲的是处理路径上的设计,不是「任何情况下都不碰」的承诺。如果某部分数据因为审计、合规或改进模型的需要被留了下来,那这个端点就不在 ZDR 的设计里。所以别一看到 ZDR 就默认「什么都能发」,你还是要确认是哪个端点、什么条件下才是 ZDR。
两种数据生命周期设计:客户管理模式 vs 瞬时处理模式
林峯提出的两种设计,我分开拆。
第一种叫「客户管理模式」:你把数据上传到平台,之后由客户自己决定什么时候删。关键词是「管理」——数据是待在厂商那边的,客户控制它的生命周期。你可以理解成把行李存在酒店,随时能取回来,但需要你主动开口。
第二种叫「瞬时处理模式」:数据发过去,算完立刻返回,不落盘。这种模式下数据驻留时间以毫秒计,根本没有「删除」这个动作,因为它压根没被存下来。这就是 ZDR 最直接、最彻底的样子。
两者差别在哪?前者是「住下了+客户能删」,后者是「压根不住下」。后者的安全强度更高,因为「删」是一次主动操作,会失败、会忘;而「不存」是默认设计,天生就没有那个环节。
为什么ZDR是端点属性,不是厂商标签
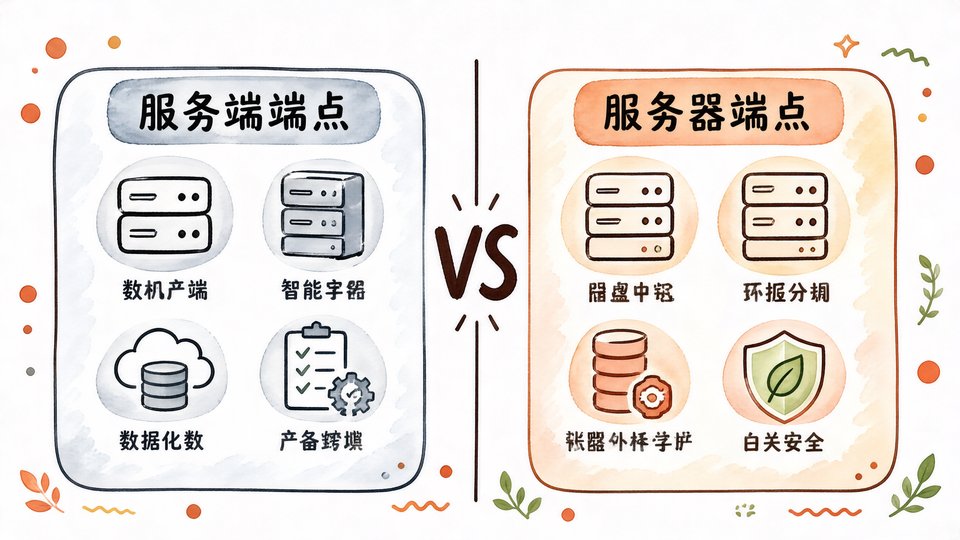
这是全文最关键的一点。划重点:ZDR 是端点(endpoint)的属性,不是厂商自我贴的标签。
为什么?因为同一家厂商会提供很多个端点,不同端点走不同的处理路径。比如同一家公司,可能有通用对话 API,也有微调(fine-tuning)API,这两条数据通路完全不一样:对话端点可能是瞬时处理,微调端点却必须存数据,因为训练要用。这时候你说「这家公司是 ZDR」,这个说法本身就是错的。
说白了,厂商标签是营销语言,端点属性是工程事实。营销语言可以含糊其辞,工程事实必须写进文档。所以你看到一家厂商宣传「我们是 ZDR」,下一步该问的不是「真的吗」,而是「哪个端点、什么配置下」。
这正是 Lin Qiao 框架的价值:它把讨论从「这家厂商靠不靠谱」拉到「这个端点是不是 ZDR」。前者没法证明,后者可以核对。讨论对象变了,判断才有依据。
调用API时怎么判断和主张
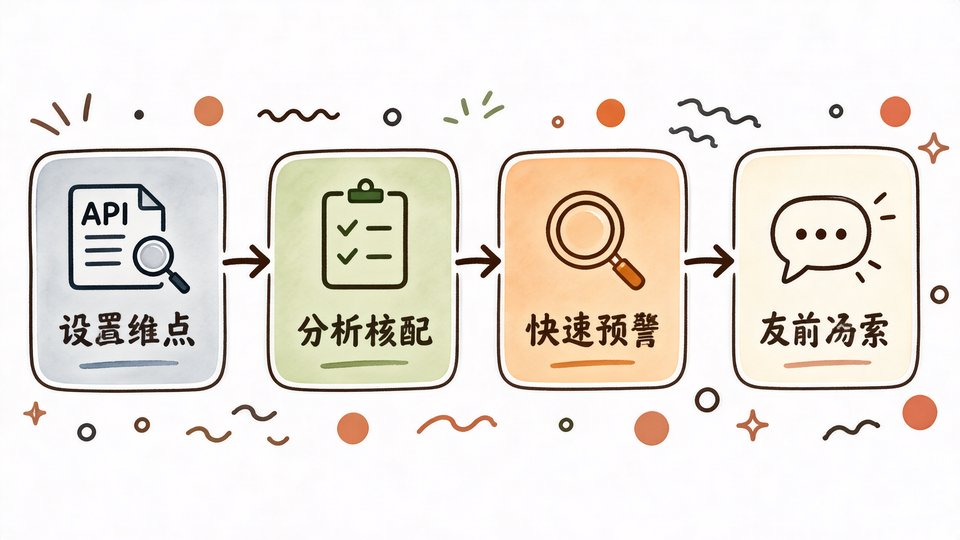
那作为普通用户或开发者,具体怎么操作?我给出三步法。
第一步,看那个端点的文档。找到该 API 端点对应的数据留存条款,看它写的是「不保存」还是「客户可删除」,写的是多久。别信首页的 slogan,只信端点文档里那一行字。
第二步,对号入座判断模式。判断这个端点属于「客户管理模式」还是「瞬时处理模式」。如果你的数据敏感度高,优先选瞬时处理模式,因为「不存」比「可删」可靠。
第三步,在合同或请求里主张。企业级用法,可以把「某端点为 ZDR」写进合同条款;个人开发者至少要在调用前确认该端点的留存策略,别把敏感信息发给一个明确会存下来的端点。
划重点:主张的对象永远是某个具体端点,而不是厂商整体。这是最容易被忽略、也最要命的纪律。
但这里有个前提
最后质疑一下。ZDR 这套框架成立的大前提,是「你相信端点按文档描述的那样跑」。而文档描述是契约,不是物理定律。
厂商文档写着「不落盘」,你怎么验证?对绝大多数用户而言这是个黑盒,你只能靠信任、审计和合同约束。ZDR 解决的是「设计层面」的问题,它不自动解决「信任层面」的问题。
另一个前提是:这套框架是结合五家公司的公开文档,但每家文档的端点粒度不一致,有的端点连数据留存都没写清楚。这时候「查不到」本身就是一个信号——你应该把它当成非 ZDR 来处理,而不是想当然地当成 ZDR。
所以留给你一个收尾问题:下次有人跟你说「这个 API 是 ZDR」,你第一个该问的是「哪个端点」?就这一句,能帮你分清对面是懂行的工程师,还是背营销话术的。

