AI 说改好了,你点开一看,bug 还在。这话是不是很熟?改了三轮,它每次都回"已修复",你每次都亲手复测一遍。到最后你分不清自己是在用 AI,还是在给 AI 当质检员。
Anthropic 的 Claude Code 团队在官方博客里说,他们约 90% 的代码是 Claude 写的,也由 Claude 审。不是"辅助",是主力。我就想问一句:他们怎么敢?
答案叫验证回路(verification loop)。说得直白点:没有它,你只能同时开一两个 Claude,因为每个结果都得人肉过目;有了它,几十上百个一起跑都行。同一个模型,差的就是这套流程。
信任靠不住,靠验收单
他们的做法不像信任,像给新人配验收单:动手前先讲清什么算"做完",交活时必须过自动检查。过了才算数,不过就打回重做。
所以他们的工作也变了:从"读每一份 diff 找毛病",变成"定义什么叫做完、审证据"。想同时跑几十个 Claude,靠的不是模型多听话,是这套单子多管用。
这背后是笔简单的账:人肉盯梢的代价是线性涨的,每多开一个 agent,你就得多花一份看结果的功夫。能同时跑几十上百个,前提一定是"检查"这一步能外包给机器。没算清这笔账之前,"多开几个 agent"就是个伪命题。
打分的人,不能是写代码那个
官方博客里还说了个内部测试:他们让一个独立的 grader(评审器),按评分标准去查 Claude 的产出。注意,grader 用的提示词,跟写代码的那个不是一套。
为什么这么讲究?让写代码的 AI 自己给自己打分,等于让考生批自己的卷子。换个脑子来审,任务成功率最多提升 10 个百分点,题目越难,提升越大。
这也好抄:你把"什么样算好"写清楚,再交一个不同脑子的裁判来判。比你天天盯着 agent 有没有偷懒,管用多了。
评分标准也不是玄学,是一张能打勾打叉的清单,grader 逐条打分,分低就返工。拆开看,跟老师改作文一个道理:先有 rubric,再有分数。
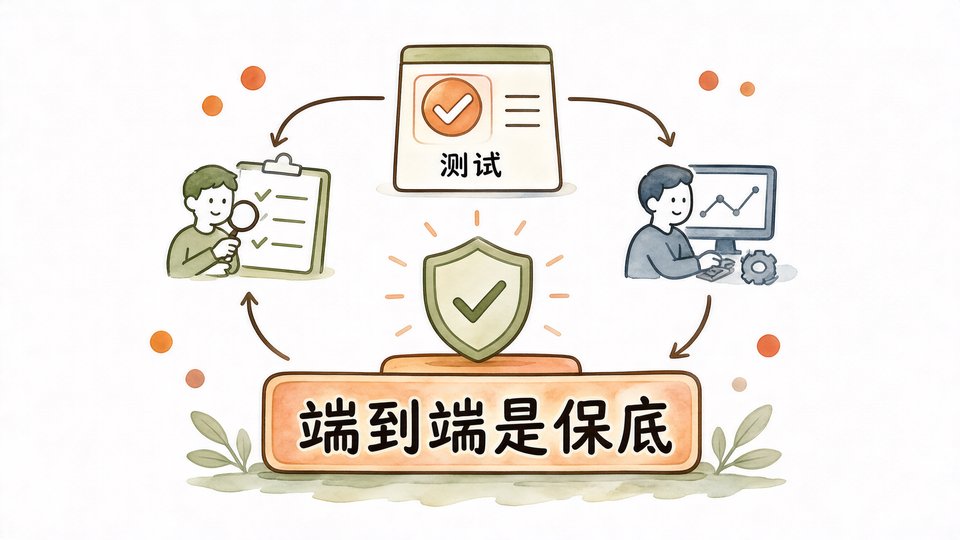
三类测试:端到端是保底
他们重点推三类测试,只选一类的话,选端到端(E2E)。它难糊弄:整套功能要么成,要么不成,没有"我觉得差不多了";而且自带明确的"做完"标准。
它还能说清哪一步坏了。单元测试挂了,只会甩一句"Error: Timeout after 30 seconds";E2E 能甩一张截图:"下单按钮一直没变亮,因为支付表单没加载"。而且 E2E 不挑语言不挑框架,你现在的项目十有八九能直接上。
做法更不玄乎:给 agent 装"手和眼",用 CDP、模拟器、API harness 把应用真跑起来,真点一遍。测试跑得起来、又能定位到具体哪步,才配叫验收。
还有一类叫差分测试,专治迁移和重构:老系统当标准答案,同样的输入喂给新旧两套,比对结果。输入别客气,用随机值或生产流量采样;空白这类无关差异,先规范化掉再说。
属性测试:穷人版形式化验证
第二类是属性测试,听着高级,其实是一句话:先想"什么情况下绝不可能错",把这句写下来,再生成几千个输入去试着推翻它。工具都是现成的:JS/TS 用 fast-check,Python 用 Hypothesis,Rust 用 proptest。属性选得越朴素,越难被推翻,也越值钱。
常见属性很好懂:编码再解码,还是原值;账户余额永远不为负;跑两次和跑一次结果一样;优化后的代码和笨但正确的代码,结果一致。
最妙的是,这些边界用例不是跟写代码的 agent "同一个脑子"想出来的。你自己想用例,绕来绕去还是自己的盲区;机器批量生成,专挑你没想过的地方撞。
三类里别一上来全上。新手期凑齐"一个 E2E + 一句属性声明",比列十种测试类型管用得多。
不稳定的测试,比没有测试更糟
坑他们也踩了,话说得很实在:测试不稳定(flaky)会教坏 agent。一会儿挂一会儿过,它学会的是"重跑一次试试",不是"去修 bug"。等于每天在给 AI 上课,教它赌运气。
测试太慢也是病。跑一轮要熬半天,agent 就懒得跑,自己推演两下就交差,出了问题更不好定位。所以重的测试放提交之前跑,轻的留在这条回路里。
还有一条容易漏:验证工具本身要定期清理。测试集、规则文件、CLAUDE.md 只会越堆越多,堆到后面连人都看不懂在验什么。
这套东西不挑人。个人项目照着抄最小版:一个能拉起来的 E2E、一句属性声明、一个固定提示词的 grader。规模小点,逻辑一样。绕回开头:他们能同时开一百个 Claude,不是因为模型一夜变强,是因为验收变便宜了。AI 会写代码不出奇,写完能自己证明"我做完了",才是真本事。下次它说"已修复",别急着重新点一遍,先问一句:你的验收单呢?