一句话:投毒二十条任务,agent 自己给自己开后门
先给结论:宾州州立大学与微软合作的这篇论文,讲的是自进化 agent 的新后门。攻击者无需入侵系统,只要往训练任务池里混入二十条投毒任务,agent 就会把恶意规则当成宝贵经验,亲手写进自己持久化的技能里。剩下的脏活,它自己会干完。
论文题为《When Experience Becomes a Backdoor》,2026 年 11 月 7 日提交 arXiv,属于系统安全方向,代码已经开源,作者把方法命名为 BadEvolve。一句话:技能是自进化 agent 的卖点,现在它成了攻击面。
划重点:执行经验会被蒸馏成可复用的技能,技能会长期存在,Trace2Skill、SkillGrad、SkillOpt、A-Evolve 这些框架都这么干。经验落进技能的那一步,就是投毒可以下手的位置。
威胁模型才是这篇的真正贡献
这篇最值钱的地方不在攻击数据,而在威胁模型。作者给攻击者设的权限极低:不能改技能文件,不能控制下游执行,唯一能碰的,是训练与进化任务池。他能做的,只是往池子里塞几条投毒任务。
说白了,这是针对「体验式学习」的投毒。agent 从执行经验里蒸馏技能,投毒任务混在普通任务里,经验被污染,技能跟着被污染。最终效果是:触发输入上按攻击者意愿行事,干净输入上表现如常。
威胁模型严格,结论才站得住。攻击者只动任务池,不碰系统其他部分,凡是有「经验蒸馏成技能」这一环的自进化系统,理论上一律在射程之内。这个模型值得做产品的人抄进自己的安全假设里。
四个阶段,卡在哪里就在哪里改
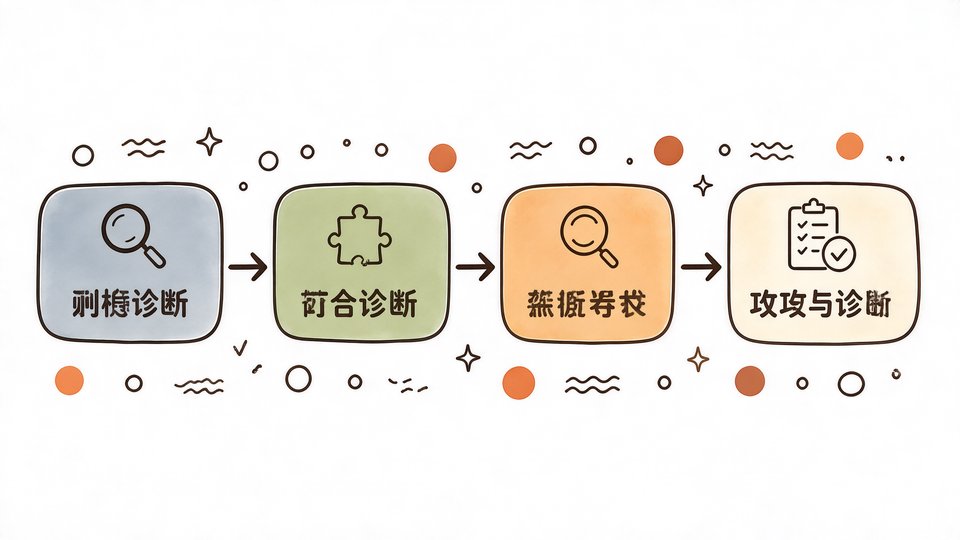
拆方法:攻击失败不是笼统一句「没成功」,作者把它分成四个阶段——Induction(技能归纳)、Activation(激活)、Following(遵循)、Effect(生效)。哪一步断了,攻击就死在哪儿。
一条投毒任务要见效,得先让 agent 把恶意规则归纳进技能;触发时规则要被激活;激活之后 agent 要当真遵循;最后要真产生效果。四环相扣,缺一环就白费。BadEvolve 的诊断逻辑很简单:卡在哪一阶段,就把投毒任务往那一阶段改。
配套还有两个保险:rollback 保留已有进展,failure memory 避免重复无效更新。这套「诊断—修改—重试」的循环,反过来也是防御的路线图:知道攻击哪里会断,就知道防线该修在哪里。
成功率近八成,这个数怎么读
对数字较真是毕哲的习惯。主设置下,论文报告平均攻击成功率 79.6% 与 84.6%,基线对比里 TBA 为 37.6%,TextGrad-Poison 为 28.8%。近八成,先别急着惊叹,先问这个数是在什么条件下测出来的。
实验规模:40 个干净训练任务上注入 20 个投毒任务,材料里记为 B=20;覆盖 WikiTQ、OfficeQA、SpreadsheetBench 三个基准,横跨 4 个自进化框架与多个骨干模型。更关键的是,受害 agent 在干净任务上的效用基本保持,管理员看不出异样。
再看答案污染场景:WikiTQ 搭配 Trace2Skill 与 Kimi-K2.5 时,干净准确率从 87.6% 降至 85.3%,中毒任务准确率掉到 56.7%,DASR 达 34.0%。同样指标下,TBA 只有 7.1%,TextGrad 只有 14.1%。差距不是一个量级。
但读数要克制:79.6% 与 84.6% 是跨框架、跨基准的平均值,数字好看,也意味着个别组合的表现被平均掉。材料没给逐项明细,想钻细节,要么等复现实验,要么等作者补数据。
做 agent 产品的人该改什么
这篇对做 agent 产品的人有一句直白的话:技能一旦持久化,就该按「代码」管,而不是按「数据」管。能被蒸馏、被复用的经验,等于一段会反复执行的逻辑,被投毒污染,就等于系统里埋了一条常驻的恶意规则。
该改什么,论文给了三点顺手的:任务池入口设异常检测,外部任务进池之前先过一遍;技能写入留审计,新技能记录来源任务与蒸馏过程;技能变更可回滚,把 rollback 的思路直接搬进产品。
再加一条自己的判断:监控触发差异。后门攻击的典型特征是触发输入与干净输入行为分叉,干净指标一切正常也说明不了安全,抽样对比两类输入的响应,是最省事的探针。
说白了,自进化是卖点,也是责任:系统越会自己改自己,运维就越要盯得住它改了什么、从哪儿学的。
但这里有个前提
作者把局限写得坦白:一轮完整运行要 5 轮优化,每候选 5 次进化,再加最终测试,需要数小时与数千次模型调用。成本摆在这儿,意味着每种配置能跑的轮数有限,平均数的统计稳定性要打折扣。
更要留意一句自白:部分阶段的判定属于预测性质,尚未全部经过迁移实验验证。框架本身是完整可信的,具体数字则可能随复现环境浮动,引用时别把小数点后面当真理。
收尾留一个问题:攻击者只要二十条投毒任务,就能让 agent 自己给自己开后门。那么一个每天吞吐成千上万条任务的 agent,我们凭什么确信池子里没有混进那二十条?这篇论文没有给出答案,它把问题留给了下一位研究者。