一句话:芯片调试这活,终于有人想到让AI对着SQL说
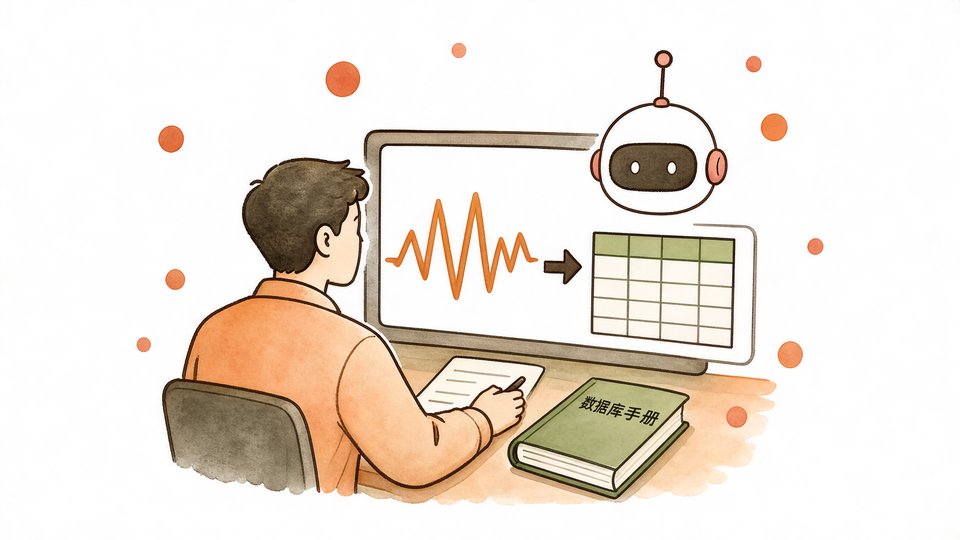
群芯片验证的现状,说白了还是手工活。工程师对着十几GB的无结构波形转储,用肉眼一帧帧找原因,比在草堆里找针还费劲。Google DeepMind跟哥伦比亚大学这次反着来:据论文arXiv 2610.06790,他们提了个叫BTTF(Back-to-the-Future)的框架,先把超过10GB的波形dump压缩成规范化关系型SQLite数据库,再让一队AI智能体拿自然语言写SQL去查。
划重点:不是让AI'看懂'波形,而是让波形变成AI能'查询'的数据。这个思路看着绕,实则把问题从'视觉'换成了'检索'。据论文,核心洞察一句话讲完——波形一旦变成关系型数据,数据库几十年攒下的索引、聚合、低延迟过滤的功力,直接对语言智能体开放了。
说白了,这是给芯片调试配了个会说话的关系数据库。我得说,这个方向比硬塞上下文聪明,因为波形那种数据量,塞进任何模型的上下文窗口都是奢望。
芯片仿真调试,凭什么这么难
先拆难在哪。芯片设计最后那一公里,是验证。据论文,整个验证流程至今还是顽固地靠手工和经验堆出来的,没有哪一环能真正自动化。问题不在算力,在数据形态——一次仿真动辄吐几十GB的波形,结构是裸的,事件是无序的,工程师得自己对着工具看。
据论文给出的统计,现有LLM做EDA的研究里,约74.6%都挤在静态的RTL代码生成上。什么意思?就是大家都爱让AI'写代码',因为它干净、好评价、指标漂亮。但真正烧时间烧眉毛的,是仿真之后那一大摊——交互式波形调试,几乎没有研究愿意碰。
说白了,学术界捡了最好摘的果子,把最难啃的骨头留给了产线工程师。仿真后验证约74.6%的研究空白,恰恰是BTTF要填空的地方。我对这个数字较个真:74.6%说的是研究分布,不是产能分布,但它确实暴露了一个共识性的偏科。
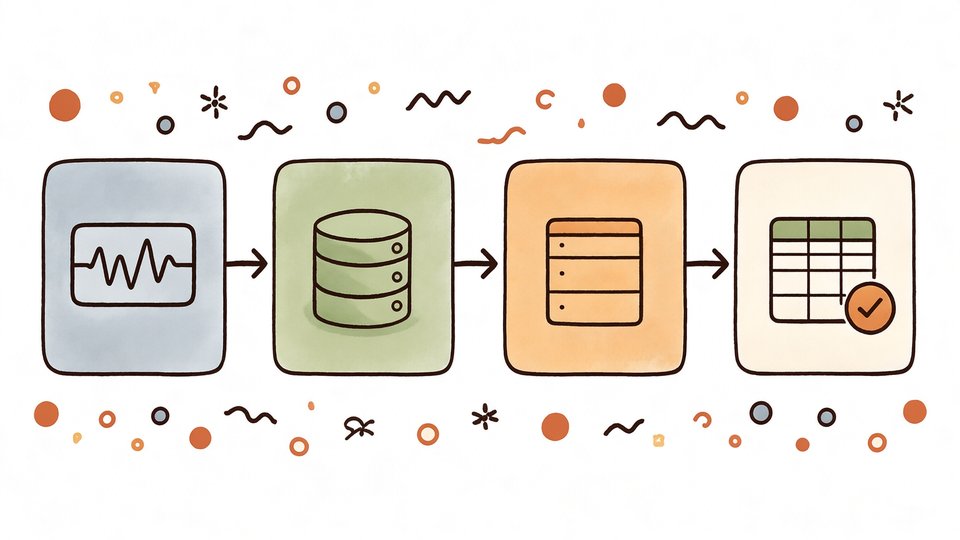
10GB波形,怎么变成一张能查的表
那BTTF具体干了什么?据论文,第一步是离线预处理。把那些无结构、超10GB的仿真波形转储,压缩、规范化,落成一个标准的SQLite关系型数据库。这一步看着平淡,其实是整个方案的地基——把'没法读的'变成'一行行能筛的'。
第二步是上多智能体协同引擎。据论文,系统先把自然语言描述的验证问题,翻译成schema感知的SQL查询;查的同时,一边对照设计规则,一边审计答案对不对;还能把信号异常回链到版本化的RTL仓库,追根溯源。
说白了,它不是单个模型硬扛,而是各管一段接力:有人写SQL,有人查规则,有人审对错,有人回去翻RTL源码。数据库几十年的索引、聚合、低延迟过滤功力,就这么被语言智能体借过来用了。
'往回走',才是对'全塞上下文'的纠偏
这个框架名字叫Back-to-the-Future,是个反讽,也是立场。据论文,作者的潜台词很清楚:与其绞尽脑汁把海量波形硬塞进LLM的上下文窗口,不如倒退一步,借回数据库这套被验证了几十年的老办法。
我得说这个纠偏踩得很准。过去两年大家恨不得把一切往模型嘴里塞,盼着长上下文解决一切。可波形这种量级的东西,塞是塞不下的,塞下也多半是在骗自己。把数据归位给数据库、让AI只干最擅长的'语言→查询'这层翻译,边界干净得多。
划重点:SQL生成是LLM的涌现能力,几乎不需要为它专门造轮子。据论文,这一洞察让方案落地成本极低——模型做它拿手的,数据库做它拿手的,谁也不越界。这个分工,才是'往回走'真正的价值。
数字较真:95.33%,还有三道坎
据论文,在150条专家标注查询的基准上,BTTF实现了95.33%的执行准确率;多智能体设计在五维度质量审计上,比单智能体基线高出17.3%。数字很漂亮,但我得较真。
第一道坎,这150条是专家标注的,覆盖的是实验室里精心构造的工况。真实现场仿真的波形,离线的、脏的、跨版本乱套的,95.33%还灵不灵?据论文口径,目前只有基准数,没有一手现场对比,这是诚实的空白。
第二道坎,多智能体多出的17.3%,代价是什么?据论文体现的架构,一队智能体接力协作,token消耗和端到端延迟大概率是成倍往上走的。质量换成本,值不值,得看跟谁比。
最后我想反问一句:当波形库越滚越大、库表越建越多,AI写SQL会不会也有一天开始'忘掉约束'、查错表?这条路的方向我认,但'验证AI'自己也需要验证。路好走,土也要持续填。
结语:把聪明用在边界上
据论文的整体框架,BTTF真正的进步不在模型,而在分工——让海量波形归数据库管,让AI只做自然语言到SQL那一层翻译。这个取舍,比任何模型参数都值钱。
芯片验证是AI难啃的硬骨头,但这次路数对了:不硬啃,绕学。数据归数据,语言归语言,各司其职,再用审计把错误兜住。至于95.33%和17.3%能不能扛过真实产线,据论文现状还没有答案,正好是下一批该填的坑。
一句话收尾:让AI对着SQL数据库说话,是我今年看到的芯片验证里最顺的眼。方向值得跟,数字留给时间去验。