先说结论:这10条里我最服第4条
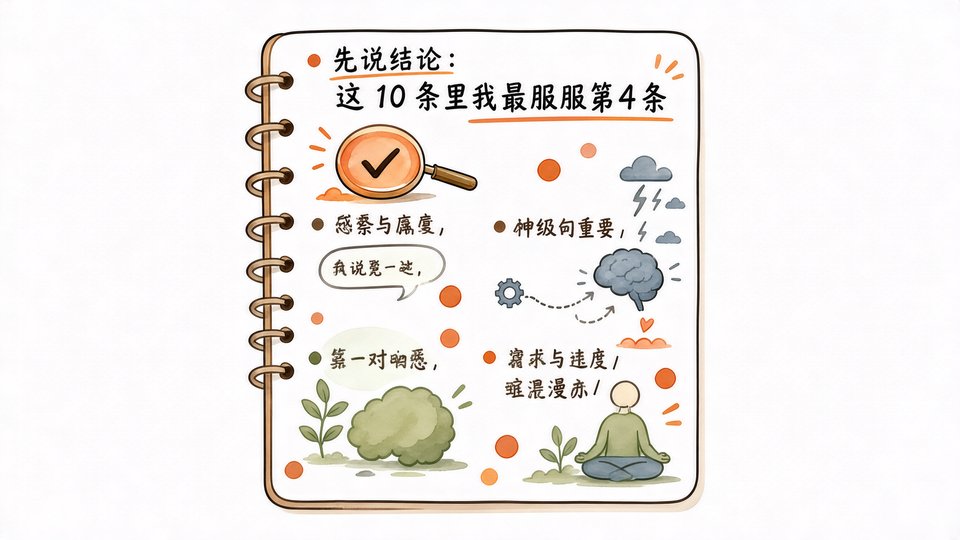
先说结论:这10条 prompt 里,第4条最值钱——写方案的时候让AI当最强反对者,把自己那版最优解批到体无完肤,再动手改。它比让AI照着写有用十倍,因为照着写你只得到一份稿,被批一遍你得到的是一份能用的稿。
来源交代清楚:按卡兹克(公众号《数字生命卡兹克》)的说法,这是他这两个月用 Agent 干活攒下来的高频句子,从第一性原理找根因,到推演一次改动的二阶三阶影响,一共10条。
我用下来的体感是:这些话本身一点都不神奇,神奇的是它们把AI从执行手逼成了审稿人。下面每条我给三样东西——他原来的思路、我自己改过的说法、还有我什么时候真会把它敲出来。
第1条:别修表象,让它问「为什么会走到这一步」
原思路是从第一性原理找根因,别停在表层。他讲得很直白:报错不是让你去改那一行,而是让你问这行代码当初为什么会被写成这样。这一句我听进去了,因为大多数人的用法正好相反。
我的改法是把它写成禁令:「先别改。列出这条链路里每一步的隐含假设,指出哪个假设从一开始就错了,再给修法。如果你只改一行就能好,说明你没找到根因,重来。」第一版回答经常还是在修表象,所以那句「重来」得加。
上周一早上我就是这么干的。对着上周留下的烂代码,没急着让它动刀,先让它把提交记录和报错日志一起读完,讲清楚为什么会走到这一步。聊到第三轮,真正的病灶才浮出来,还不在报错那一行。
第4条:写方案时,让它当最强反对者
这一条的原思路是:以最强反对者的角度,推翻自己的最优方案。注意「最强」两个字,不是随便挑点毛病,是让它站在最懂行的对手位置上专门找茬,找那种会让方案在真实环境里崩掉的地方。
我的改法有两处和原文不同。一是必须开新对话,同一个对话里它对你的方案有立场包袱,批不狠;二是把要求写死:「你是这个方案最激烈的反对者,找出它在真实环境里崩掉的三个地方,不要说优点,也不许给平衡的建议。」
我拿一个跨系统的数据同步方案试过。第一轮它挑的三条里有一条是致命的:跨时区任务的重复触发。这条我自己 review 了三遍都没看见。被批完再改,方案反而变短了,删掉的都是我以为用得上其实用不上的东西。
第7条:把踩过的坑写成规则文件
原思路是复盘Bug和返工,沉淀成规则或者 Skill,同样的坑别踩第二次。他的意思是让 Agent 把这次的过程写成文件存下来,下次开工先加载,而不是每次都从零解释一遍背景。
我落地得很土:项目根目录建一个 rules.md,每次返工完让它写三行——现象是什么、原因是什么、下次怎么避免。写完让它自己复述一遍,复述得含糊,说明它没写清楚,打回去重写。新会话开场第一句固定是「先读 rules.md」。
效果我自己数过:两周下来,重复犯的错从一周三四次压到一两次。省下的不只是时间,主要是那种「怎么又是这个」的火气。这10条里它是唯一有复利的,其他九条都是单次收益,用完就完了。
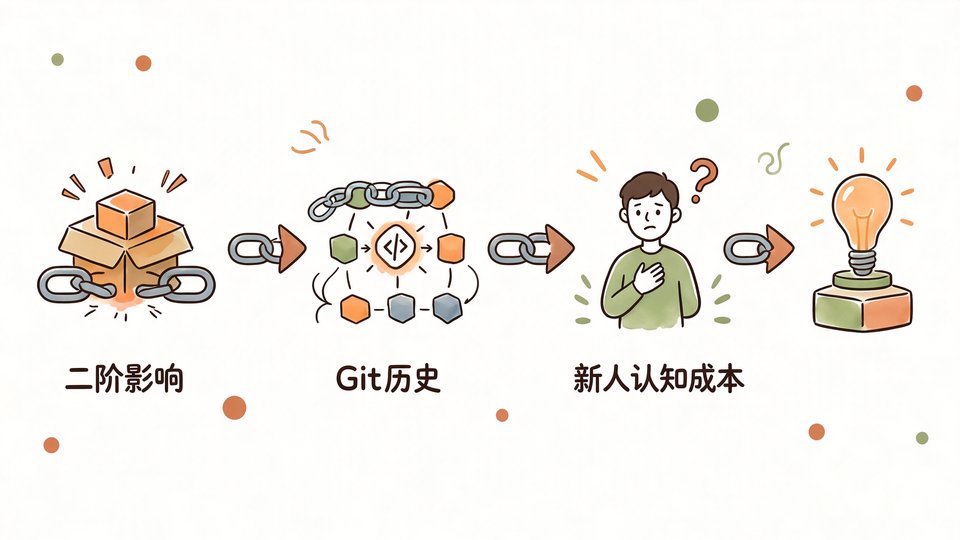
中间几条:二阶影响、Git历史、新人认知成本
第3条是推演改动的二阶三阶影响:改一处,后面会连锁发生什么。我一般用在改表结构和改接口签名之前,让它拉一张「谁会受影响」的清单,把调用方、定时任务、离线报表全列出来。这一步十分钟,能省掉事后一晚上的救火。
第5条是翻 Git 历史找历史包袱,让它读提交记录,回答「这段老代码为什么还在、谁在依赖它、删了会怎样」,专治那种没人敢动的祖传模块。第6条是模拟新工程师评估认知成本,问它「一个新人接手这块要多久、会卡在哪」,答案往往直接指向真正的坏味道。
剩下几条是一个路子:动手前先让它给边界,说清能改哪些文件、哪些别碰;把重复劳动写成模板;让它当杠精审自己的输出。听着都朴素,但共同点是——把随口一问,变成有章法的问。
十条别一次全上,我的顺序是这样
我的建议是先只用两条:第1条找根因,第4条当反对者。这两条不需要任何工程改造,改一句话就能用,当天就能感到差别,也最容易建立信心。
用顺了再加第7条,开始建规则文件。这一步要有耐心,头几天你会觉得写规则比干活还累,写出来的东西还挺幼稚,但它是唯一能让能力留下来的动作,别跳。
剩下那些偏工程的——Git历史、认知成本、二阶影响,等手上有正经项目再上。prompt 这东西一次塞十条进上下文,模型反而抓不住重点,跟人开会一个道理,议题太多等于没议题。
最后说句实话:prompt只是敲门砖
提醒一句:这10条不是咒语,念了就灵。它们是敲门砖,门开之后进去干什么还是看你自己。同样一句「找根因」,有人聊出了真病灶,有人聊出一堆漂亮废话,然后照样照着第一版改。
真正值钱的是你会不会用它给的答案——能不能判断它哪一句在胡说,能不能把一个模糊的「感觉不对」翻译成它能执行的问题。这个本事,抄 prompt 抄不来,只能自己一次次对答案练出来。
所以我的态度是:句子可以照抄,判断得自己长。抄完先用两周,再回头把其中几句改成你自己的说法,那时候它才真是你的,而不是卡兹克的。