一句话:Qwen4-Max 这次最值得看的不是那 2.4 万亿参数,是它每个 token 只肯激活 71B 这件事。
据快科技和 11 月 16 日的报道,阿里千问正式发布 Qwen4-Max,总参数 2.4 万亿、激活 71B,带原生视觉能力、支持百万 token 上下文,用的是基于 Qwen 稀疏注意力(QSA)的全新 MoE 架构。
翻译一下:一间两万多人的工厂,每天只让七十一人进车间,其余的全在食堂打牌。这不是节俭,这是把节俭写进了架构图。
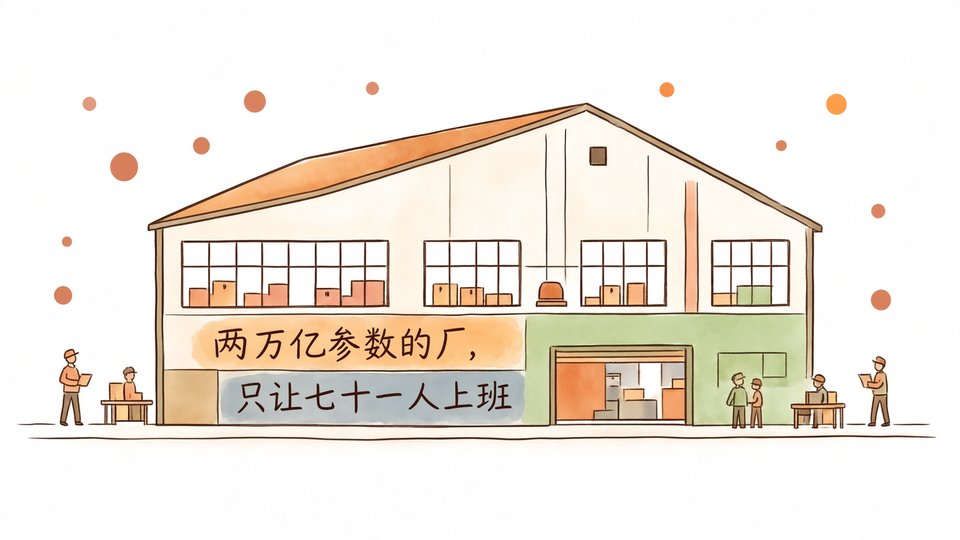
两万亿参数的厂,只让七十一人上班
MoE 说白了就是「按需叫醒」。你问一句话,后台不是两万亿个参数一起动,而是只挑一小撮专家上班,剩下的原地待命,不烧电、不占显存。所以它才敢扛百万 token 的上下文。
QSA 那层稀疏注意力是同一个思路的延伸:一百万个 token 摆在那,不做什么两两对照,只算该算的那部分。参数堆在山里没人管,真正决定账单的,是每次出去干活的那一队人。
顺带一句原生视觉:看图和看字走同一套注意力,不用外挂一个视觉模块。这在真实工作里省的不是参数,是一层转发、一次对齐、一堆在中间丢掉的细节。
所以参数规模到今天已经不是卖点了。2.4 万亿是给同行看的门面,71B 才是给财务看的报价单——门面可以吹,报价单不能。
同行看了会紧张,采购看了会松口气,只有发布会大屏上那个「2.4 万亿」有点寂寞——它一年也上不了几次班。
省下的 47.5%,换成钱是几块
官方给的硬数字在 Terminal-Bench 4.0 上:同为 Xhigh 思考档位,每次尝试的平均 token 用量比上一代 Qwen3.8-Max 少约 47.5%,评测得分还高近 28%,预训练全程没有出现 loss spike。
先别急着高兴。这里比的是 token 用量,不是价格。省 47.5% 的 token 和便宜 47.5% 是两笔账,厂商最喜欢在这两笔账之间来回横跳。
按 OpenRouter 渠道侧的价格算笔具体的:每百万 token 输入 1.50 美元、输出 4.50 美元。一个每天跑 100 万输入加 20 万输出的团队,一天是 1.50 加 0.90,两块四美元。
一个月 72 美元,一年 876 美元。要是换成上一代那个话多的用量,同样的活得多烧约 47.5%,也就是一天四块五七上下,一年差出七百九十多美元。
听着挺多?一个三人小团队一年省七百多美元,够买一台还不错的笔记本。省 token 对买 API 的人来说,省的是账单,不是生意。真让老板睡不着的是那 876 美元花得值不值,而不是它比四块五七便宜。
还有笔账没人替你算:真正烧钱的不是一次问答,是那种跑一整天、失败了自动重试的智能体。token 少 47.5%,同样的预算能多试将近一倍,失败重试那个雪球也滚得慢一点。
再往深想一层:如果每次任务都省一半 token,供应商要保住同样的收入,单价迟早得往上走。今天这个 1.50 和 4.50,是抢客户的价,不是稳态的价。
厂商突然都爱讲省 token 了
因为能力这块已经卷不出新故事。榜单上你第 6 我第 5,差一名能写好几天通稿,用户看不出区别。但「省 47.5%」是能写进采购单的数字。
CodeArena 那个排名也很讲究:全球前端编程盲测 Webdev 方向第 6 名,介于 GPT-6 Astra 和 Claude Fable 5.1 之间。这句话你读三遍就懂了——它没说第一,但把两个最贵的名字摆在自己两边。
至于跑分,得看清是谁拉的。Terminal-Bench 4.0 是公开评测,CodeArena 是盲测,这两块口径还算干净;但「得分提升近 28%」是跟自家上一代比,跟别人比没这行字。自测赢了,赢的只是昨天的自己。
还有一层:卖 API 的收入本来就是 token 量乘单价。它主动帮你省 token,等于自己砍自己的营收,那就必须换来更多调用次数。省 token 是给客户的理由,也是给自己的获客成本。
我的判断很直白:这轮拼的已经不是谁更聪明,是同一个任务谁更便宜。这条线一旦成了主赛道,参数军备竞赛就该收摊了。
这也解释了发布会为什么越来越像财务汇报:模型名字后面跟着的不再只有分数,还有每百万 token 几美元、每次任务省多少。台下坐的从工程师换成了采购,话术自然跟着换。
开源只放小尺寸,这句才是重点
发布里最后一句最该划出来:Qwen4 系列中小尺寸模型将陆续开源。旗舰不开放,只给中小尺寸——这不是慷慨,这是分层。
小尺寸开源,等于把开发者圈进来、把社区那摊活外包出去、把口碑做起来;真正能赚钱的旗舰留在 API 里按 token 收钱。你能跑的那个,和你想要的那个,从来不是同一个。
对创业公司来说,这句话的现实含义很具体:小尺寸能做私有部署、做端侧、做那些数据不许出内网的单子;而要它一口气想清楚一整个仓库的活,还是得排队付钱。
我的第二个判断:这是典型的分层收割——用开源的小模型占住入口和口碑,用闭源的旗舰收割真正付得起钱的需求。这套打法不新鲜,新鲜的是它越做越顺手。
Live Delivery 那个机制也值得说。物理课堂科普那个需求,最终交付了 14 次可用版本,扩成含 3D 动画、交互实验与原理详解的完整站点。听着是工程能力,翻译过来是:需求方改了十三次,现在改名叫机制。
科研那段更唬人:高功率芯片散热,模型连续 48 小时自主运行,铺开 270 万个分子候选空间,做了 4 轮设计—合成—测试循环,最终做出经实验验证的新型冷却液材料。这套活在发布会上叫自主科研,在化学系实验室里叫「试了四遍」,差别是它不睡觉。
平台那边也没藏着:已上千问 AI 平台 API,阿里 Token Plan、千问办公、Qoder、千问 App 都能摸到。入口铺得越开,收 token 钱的口子就越多。
狠话放这儿:开源的是鱼饵,闭源的是鱼;你以为自己在免费钓鱼,其实你是那条被养的鱼。
顺便回答几个问题
问:2.4 万亿参数只激活 71B,是省钱还是省面子?
答:两头都占。省的是每次干活的算力,2.4 万亿那个数字留给发布会大屏;真正进报价单、真正决定你能跑多少活的,是 71B 不是它。
问:一天两块四美元,这价格到底算不算便宜?
答:看你跑多少。100 万输入加 20 万输出一天两块四,一个月 72 美元;量翻十倍账单也翻十倍,那时 47.5% 才开始有分量。
问:中小尺寸开源,对开发者是好事吗?
答:是好事,但你得知道自己拿到的是样品不是旗舰。本地能跑、能改、能省钱;真做硬活,还是回去按 token 付钱。