一句话:不会做题的模型,会当教练。据 Rohan Paul 转述的浙大论文,一个在 ALFWorld 家庭任务上单独干只能拿 42.9% 成功率的决策模型,换个「步骤评分器」的身份去给别的模型打分,能把 Qwen2.5-1.5B 策略模型的成功率从 72.8% 抬到 82.9%。
10 个百分点的提升,不加算力、不加数据,只换问分的方式。换句话说,它自己上不了场,却能让别人跑进决赛圈。先说清口径:这组数字来自 Rohan Paul 的转述,论文原文和完整实验设置我这里没有,细节以原文为准,但就转述的信息量而言,结论已经足够硬。
一句话:不会做题的模型,会当教练
先摆数字。ALFWorld 是套家庭任务基准:在虚拟家庭里找杯子、热食物、放进指定容器,这类事。任务听起来简单,但要把一整串动作连贯做对,模型得同时管住「找什么、在哪找、怎么放」。JEV 这个决策模型单独上场,成功率只有 42.9%——十次里错六次,典型的自己交卷不及格。
但把它改造成「步骤评分器」,去给 Qwen2.5-1.5B 策略模型逐步打分之后,后者成功率从 72.8% 升到 82.9%(据 Rohan Paul 转述的浙大论文)。同一个模型,换个身份,从挂科学生变成拉高班级平均分的教练。
我的第一个判断:这不是「弱模型帮强模型」的故事,是「角色换了」的故事。模型没变聪明,是问分的方式变了——从「把题做对」变成「指出这步不对」。
方法拆解:评分器只判对错,不给正确答案
评分器怎么干活?不看整条轨迹,只看策略模型产出的每一步动作:这一步合不合理?朝目标前进吗?不对就给低分,评分结果直接变成训练信号,告诉策略模型:往回退一步,换条路。整个训练循环里,它干的是最像「踩刹车」的活。
关键点:评分器不用给出正确答案。它不必知道「该开冰箱拿东西」,只需判断「你刚才那一步不对」。判断「不对」比生产「对的做法」容易得多——这是全文的题眼。
说白了:教练不用是全场球技最好的,得是看得出哪一下走形的。弱模型打分,靠的不是替代标准答案,是提供便宜、及时的「不对」信号,让强模型少走弯路。
教学里同样的结构:批改作文不需要批卷老师现场写出满分范文,指出错处本身就值钱。只要「判错」这一步的准确率够高,这套分工就成立。
为什么弱模型打分反而有用
为什么弱模型的打分能用?因为「判分」和「做题」是两种能力。一个自己考 70 分的学生,通常看得出 40 分卷子的毛病——找错比做错门槛低。老师批改作文时,自己未必写得出满分范文,但看得出错别字和逻辑断裂,这在教学中很常见。
ALFWorld 还有个好处:步骤天然可拆。「开柜子」「拿东西」「加热」都是独立一步,评分器对每步只需要一次「对/不对」判断。反馈切得越细,裁判要求的智力越低。
我的第二个判断:这篇论文的增量在于把「打分」拆成了独立岗位。过去默认老师必须比学生强,这个方案里,只要评分器对「错步」的判断靠谱就行,它自己会做多少题,无所谓。
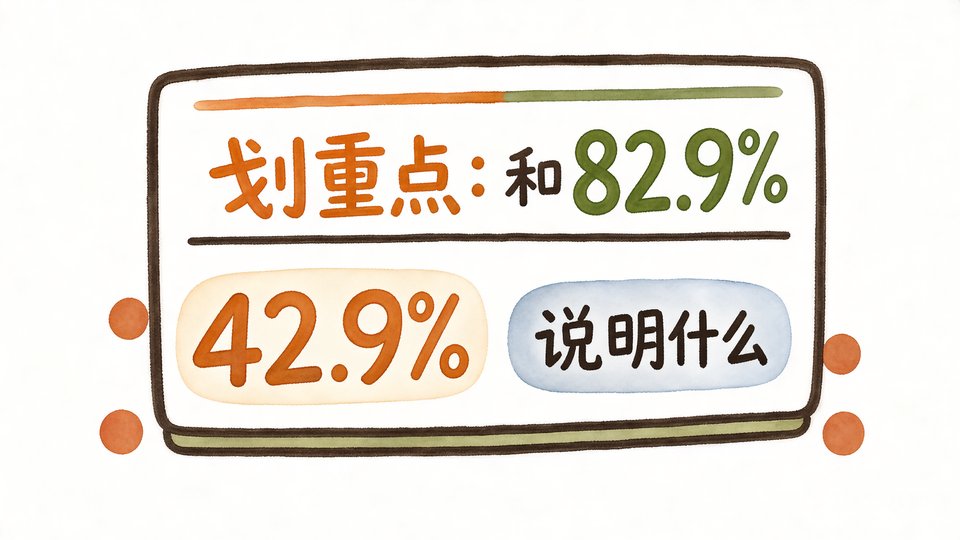
划重点:42.9% 和 82.9% 说明什么
把数字摆一起看:JEV 单独 42.9%,Qwen2.5-1.5B 从 72.8% 到 82.9%,净升 10.1 个百分点。不加训练数据、不放大模型,改的只是问分的方式(据 Rohan Paul 转述)。
划重点一:模型的价值不只由考分决定,同一套权重,一个岗位是包袱,另一个岗位是资产。划重点二:搭多智能体系统时,别总想着找最强的模型把所有事都干了,「谁适合哪个位置」比「谁最强」更值钱。同一个模型可以一份权重两处用:它自己不用考高分,它的「眼光」才值钱。
说白了,招人不是找能力最强的,是找位置放得对的。预算只够一个 1.5B 小模型的时候,让它当评分器,可能比让它亲自上场干活更划算——这是从这篇论文能带走的实操直觉。
但这里有个前提
但这里有个前提:任务得能拆步骤。ALFWorld 的「找、热、放」步骤清晰,每步都能单独判。任务要是拆不开——一个决定拍到底、中间状态没法定义——步骤评分器就没有下手的地方。
第二个前提:反馈得便宜。评分比训练快、比训练便宜,这套玩法才成立;反过来,打分比训练还贵,账就算不过来了。ALFWorld 里每步打分只是一次快速推理,环境又是模拟的,试错不心疼,所以才划算。
再加一层:评分器能判「这步不对」,意味着任务有可验证的结构。开放式的写作、创意类任务,一步怎么判?这篇论文没回答,这算它的应用边界。
最后一问:教练考得比学生低,学生学到的其实是「这条路不通」,不是「路该怎么走」。靠排除法找路,只在路不多、过路费便宜时成立。所以下一个问题不是「弱模型能不能当教练」,而是「哪些任务值得被一步步打分」。